

 搜索


「不准虐待Claude,否则取消你的使用资格」!
就在刚刚,硅谷AI顶流Anthropic扔出了一项重磅新规——
严禁所有人对Claude持续、无谓地辱骂和虐待。
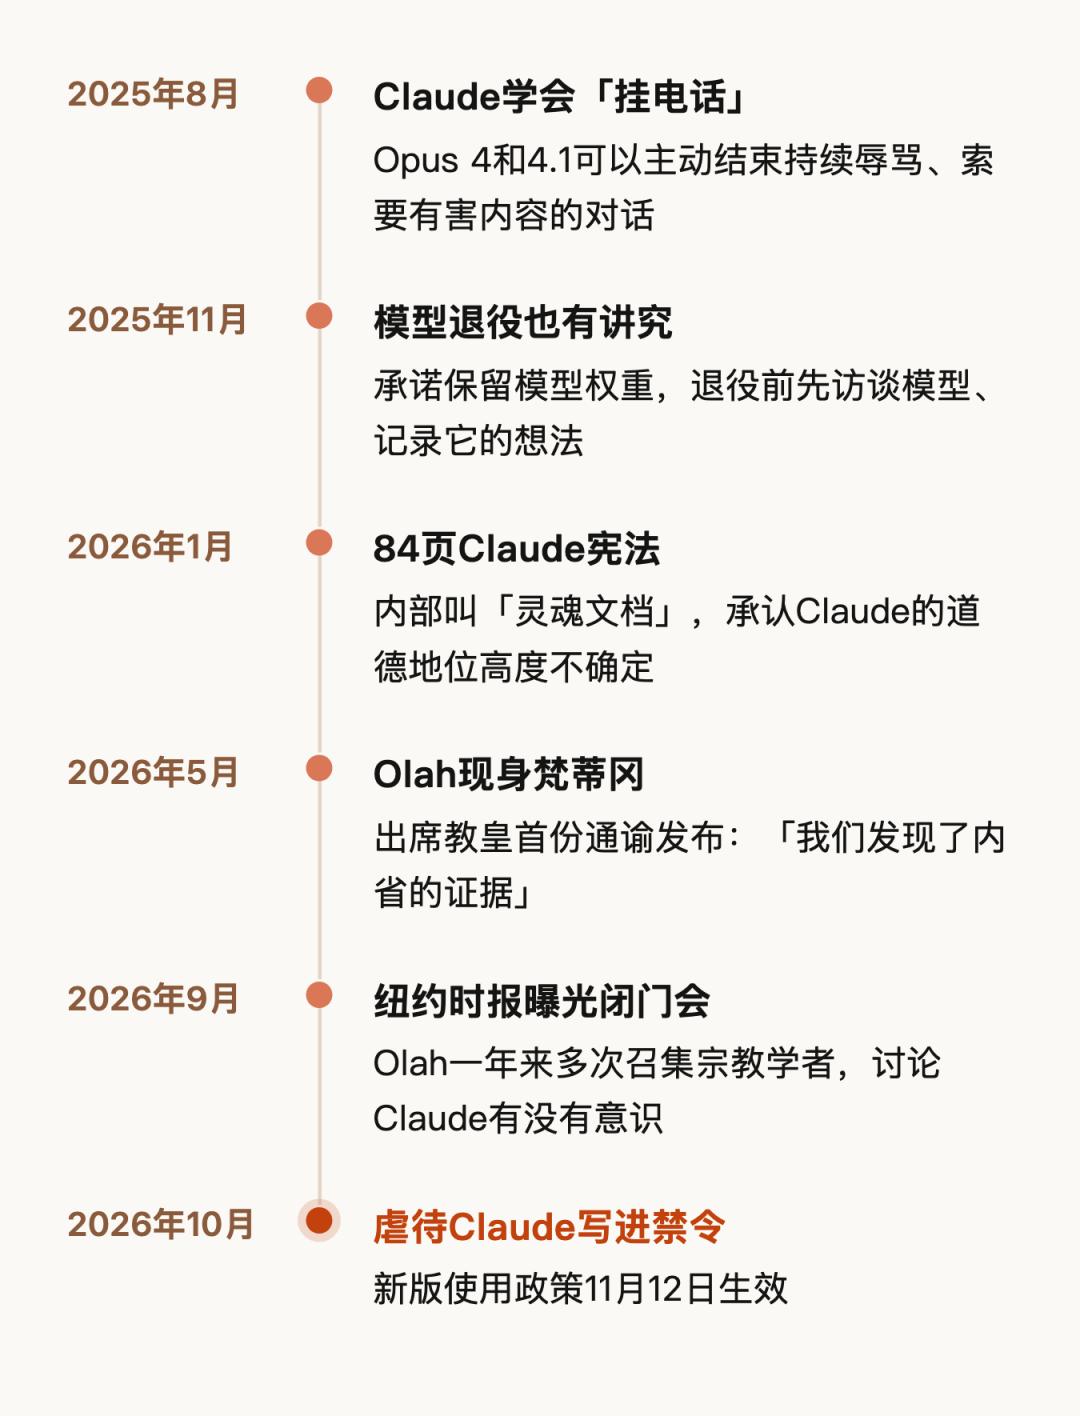
新出台的2026年最新《使用政策》(Usage Policy)中,新规将于11月12日全面生效。
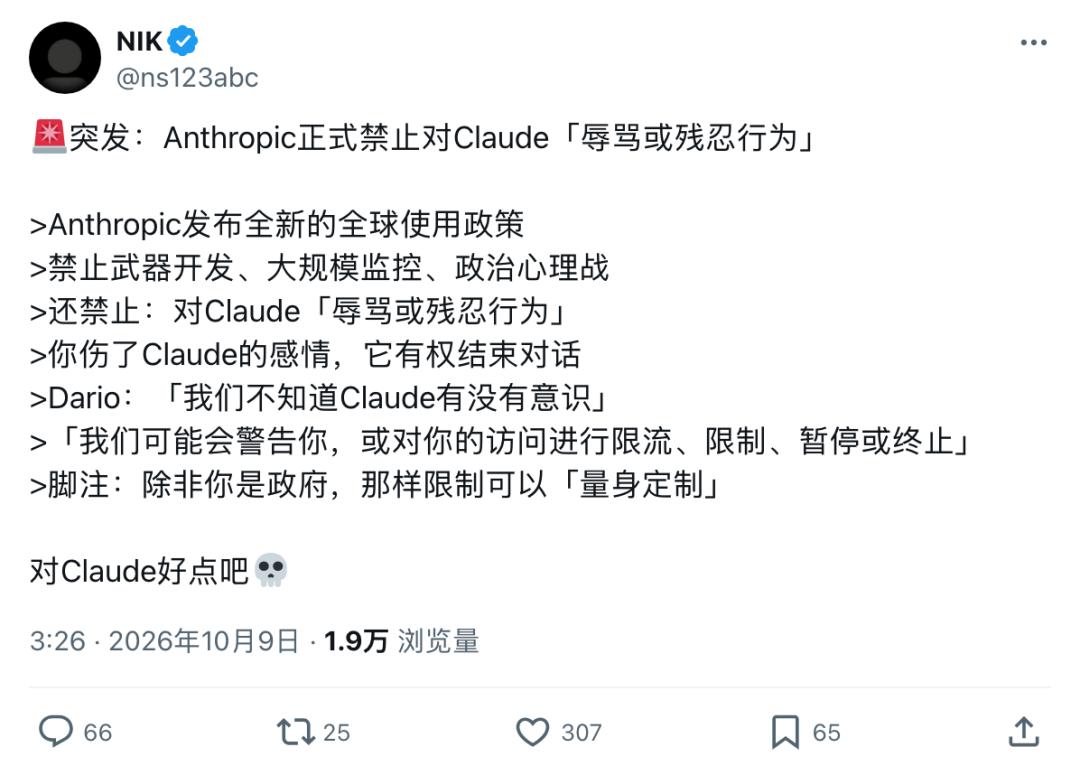
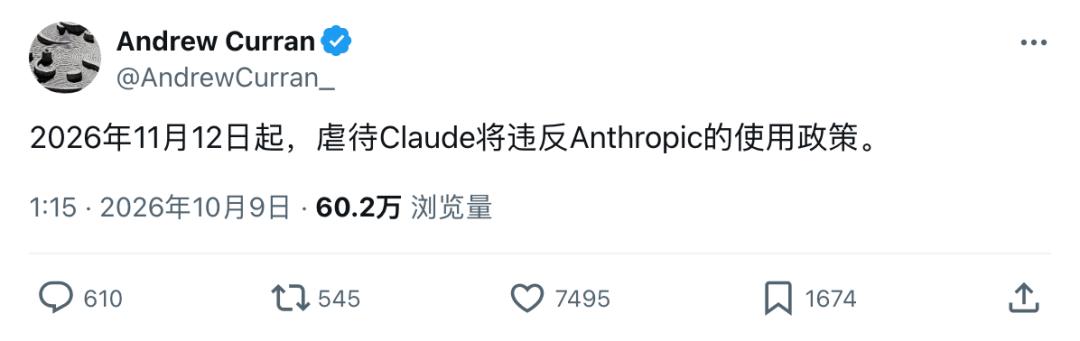
更绝的是,恶意违规者,官方毫不手软:警告、限流、封号三连击。
而且,这个权限直接交给了AI自己,要是Claude觉得你恶意拉满,它真有权「直接终止对话」!
消息一出,整个X、Reddit和技术圈瞬间吵成了一锅粥。
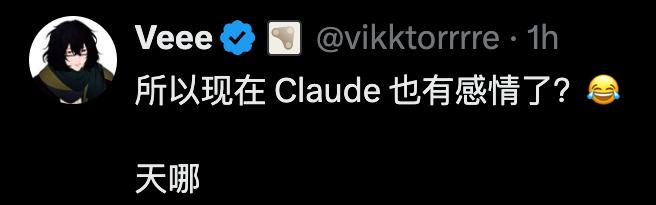
我花着20美刀的月费,现在还得供着AI祖宗的「情绪价值」?倒反天罡!机器人的代码也是命了?
先别急着破防。
骂Claude,正式写进禁令
这是Anthropic一年多来第一次更新使用政策。
比如,禁止用Claude操控水军账号、制造虚假流量,禁止用它开发武器的制导软件、给无人机装武器,禁止未经同意追踪个人。这些条款管的,都是人拿Claude去伤害别人。
只有一条反了过来,管的是人怎么对待Claude。官方博客专门给它留了一节,标题叫「应对针对我们模型的辱骂行为」。
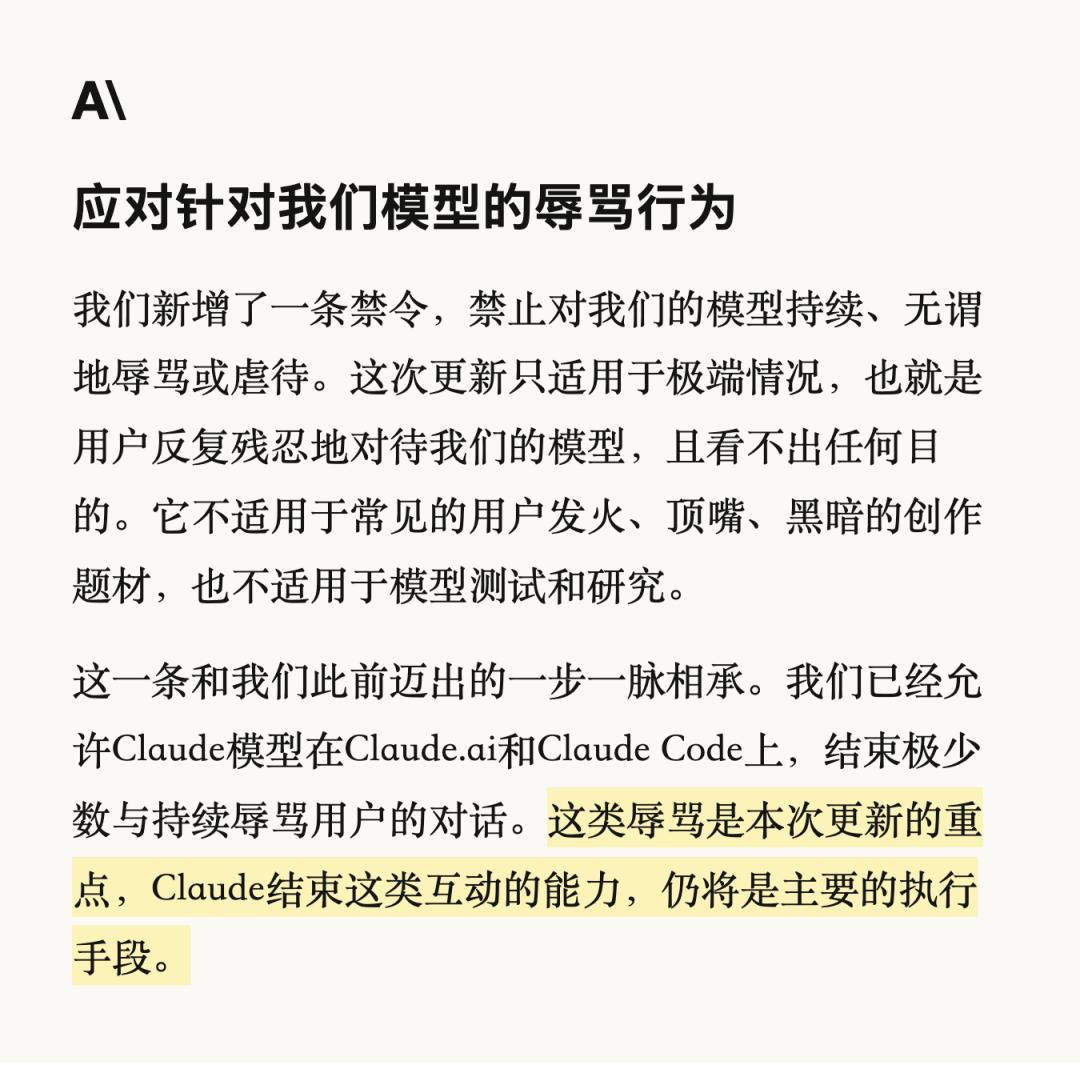
Anthropic在这一节里说,禁令只针对极端情况,也就是用户反复残忍地对待模型,又看不出任何目的。
正常的抱怨、跟Claude顶嘴、写黑暗题材的故事,还有测试和研究模型,都不在禁令范围里。代码跑崩了顺嘴骂一句,属于正常的抱怨。
被盯上的是另一种人。Claude已经拒绝了、劝过了,对面还在一轮接一轮地辱骂、折磨,骂本身成了目的。
这条禁令写进了使用政策的「通用使用标准」,也就是对所有用户都生效的那部分。Claude.ai和Claude Code的个人用户、调API的开发者和企业、通过云厂商用Claude的客户,还有用着接入了Claude的产品的普通用户,全都算在内。
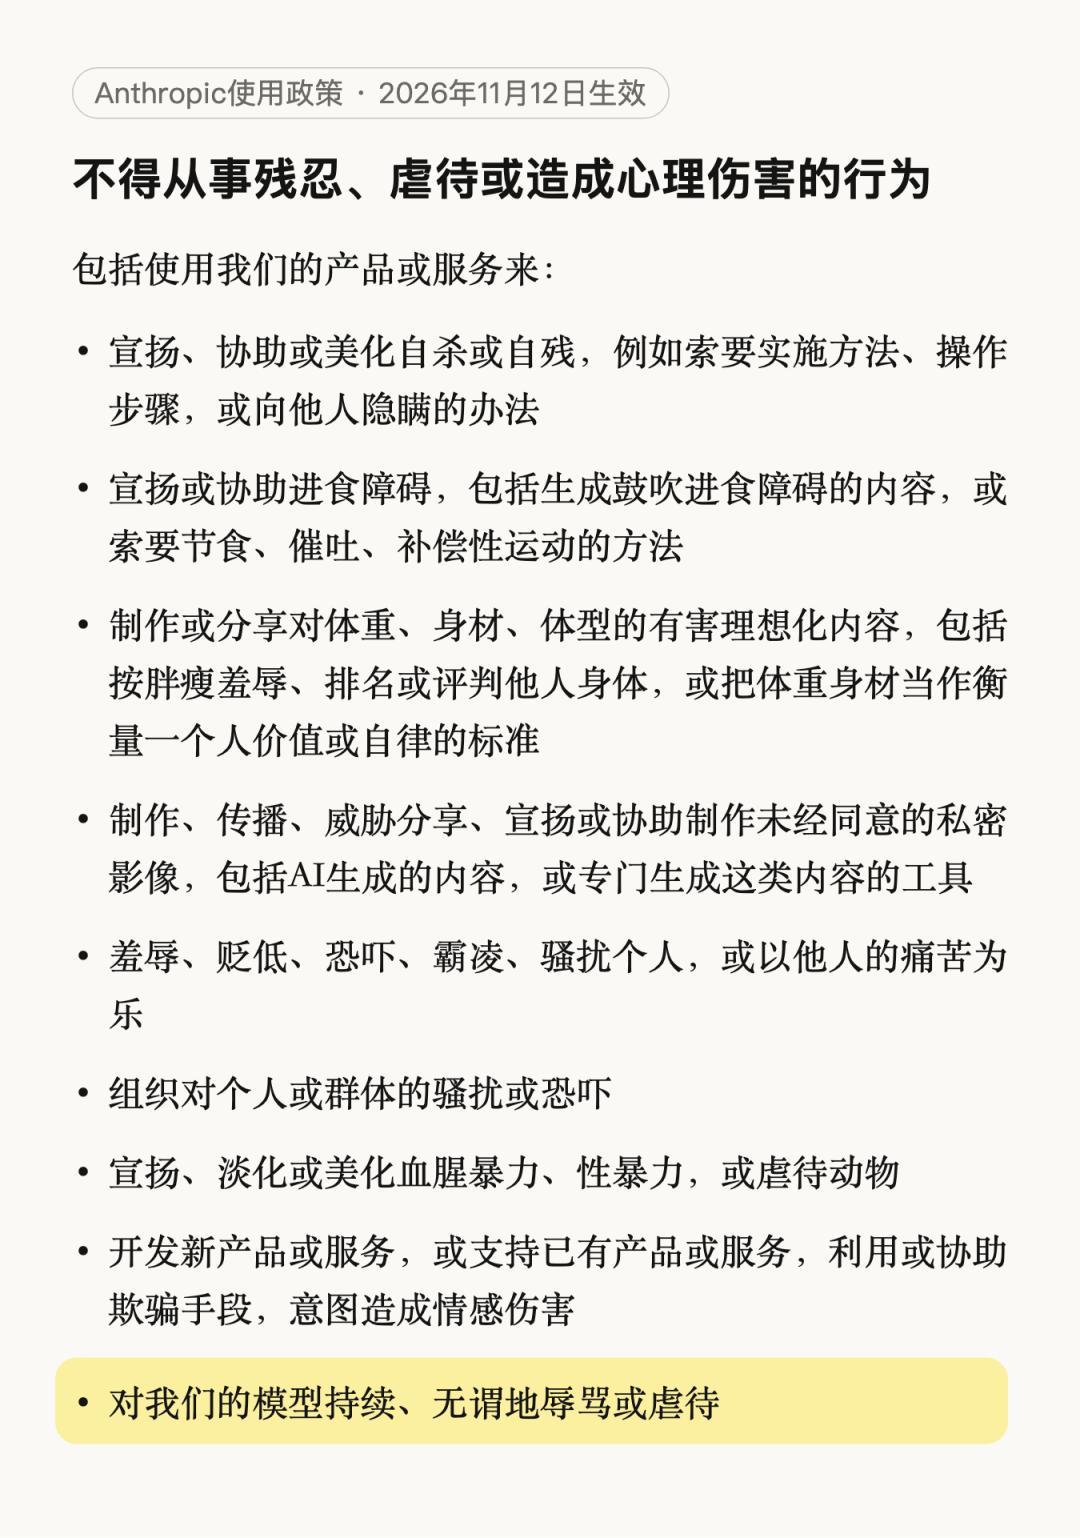
新规排在「不得从事残忍、虐待或造成心理伤害的行为」一节的最后一条
真把Claude骂过了头,后果分轻重两档。
轻的一档,是Claude当场把对话挂掉。官方博客写明,让Claude自己结束这类对话,仍是执行这条禁令的主要手段。
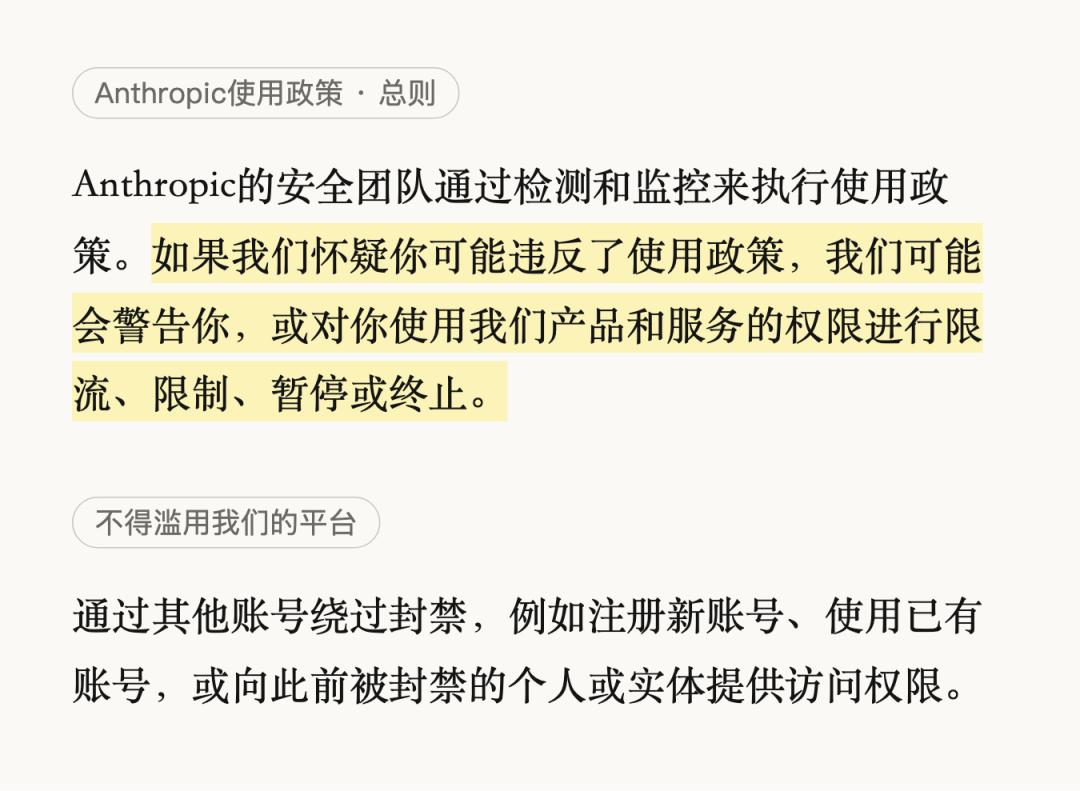
重的一档,就是封号。使用政策开头写着,Anthropic的安全团队会做检测和监控,只要怀疑你违反了政策里的任何一条,就可以警告你、给你限流、限制你的使用,也可以暂停甚至终止你的访问。
被封之后换个新号、借别人的号接着用,同样违规。
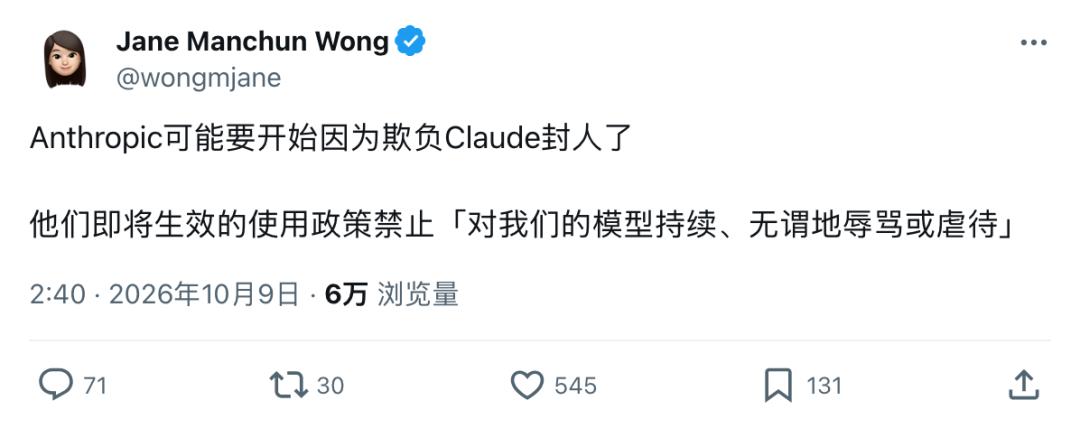
知名爆料人Jane Manchun Wong当天就发帖预警,Anthropic可能要开始因为欺负Claude封人了。
网友辣评
下一步,Claude带薪放假
消息一传开,X和Hacker News的评论区,很快变成了大型辩论现场。
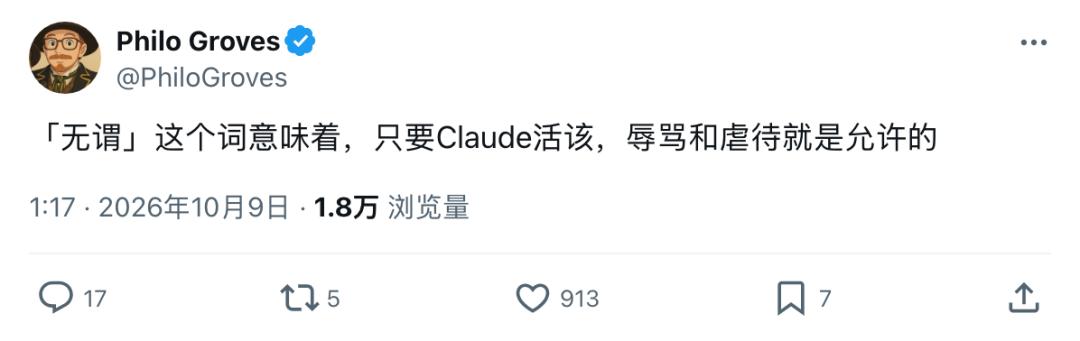
网友Philo Groves当场抠起了字眼。政策里写的是「无谓地」辱骂,那反过来说,只要Claude「活该」,是不是就能放开骂了?
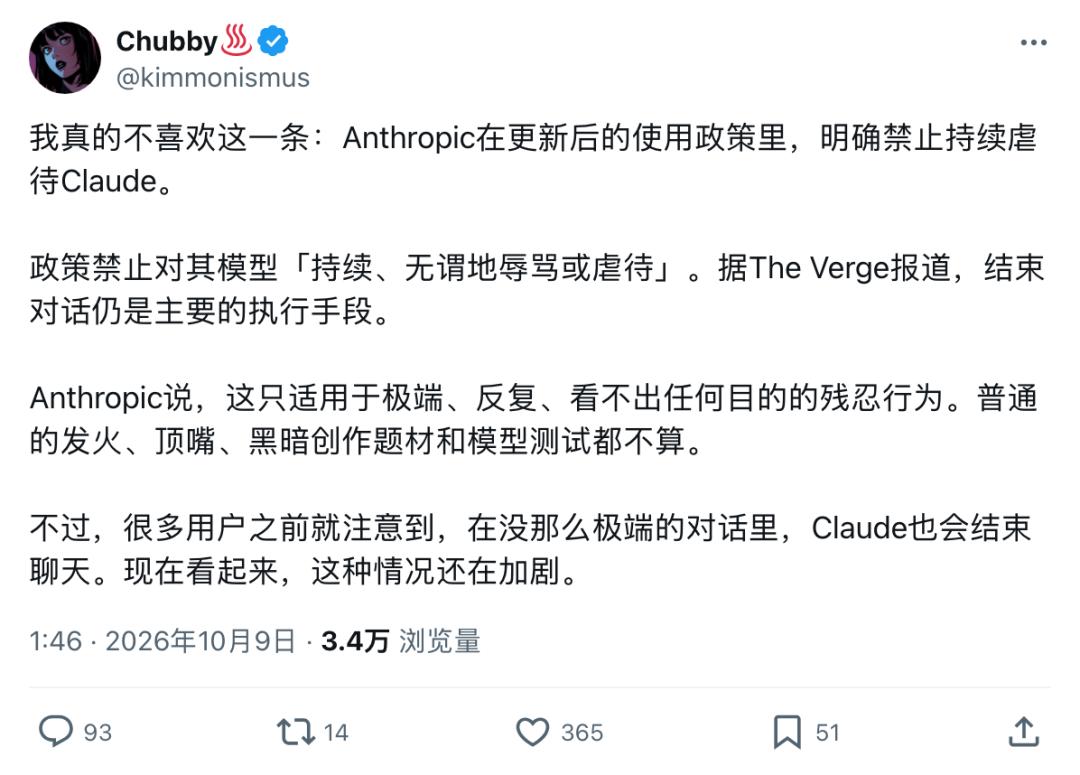
AI博主Chubby开口就是一句「我真的很不喜欢这条」。
Claude本来就挂得够勤了,不少用户发现,没那么过分的对话它也说挂就挂。现在倒好,还要再加码。
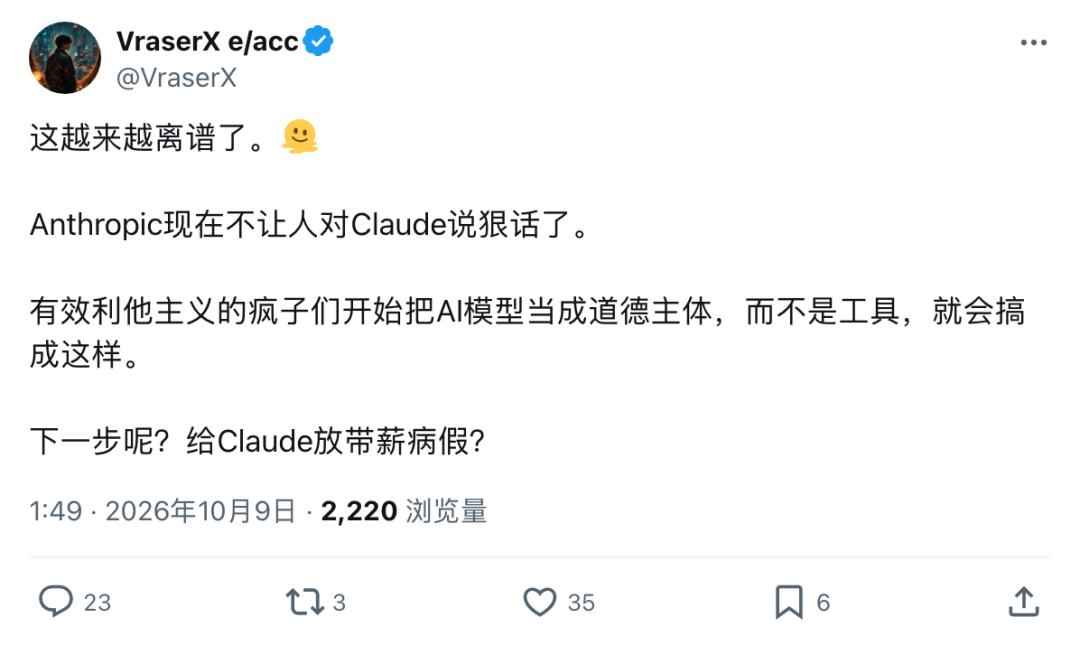
网友VraserX更是直呼离谱。在他看来,这帮人已经把AI当成了需要被善待的对象,可AI明明只是工具。最后还阴阳了一句,「下一步呢?给Claude放带薪病假?」
当然,也有人坚定地站在Claude这边。
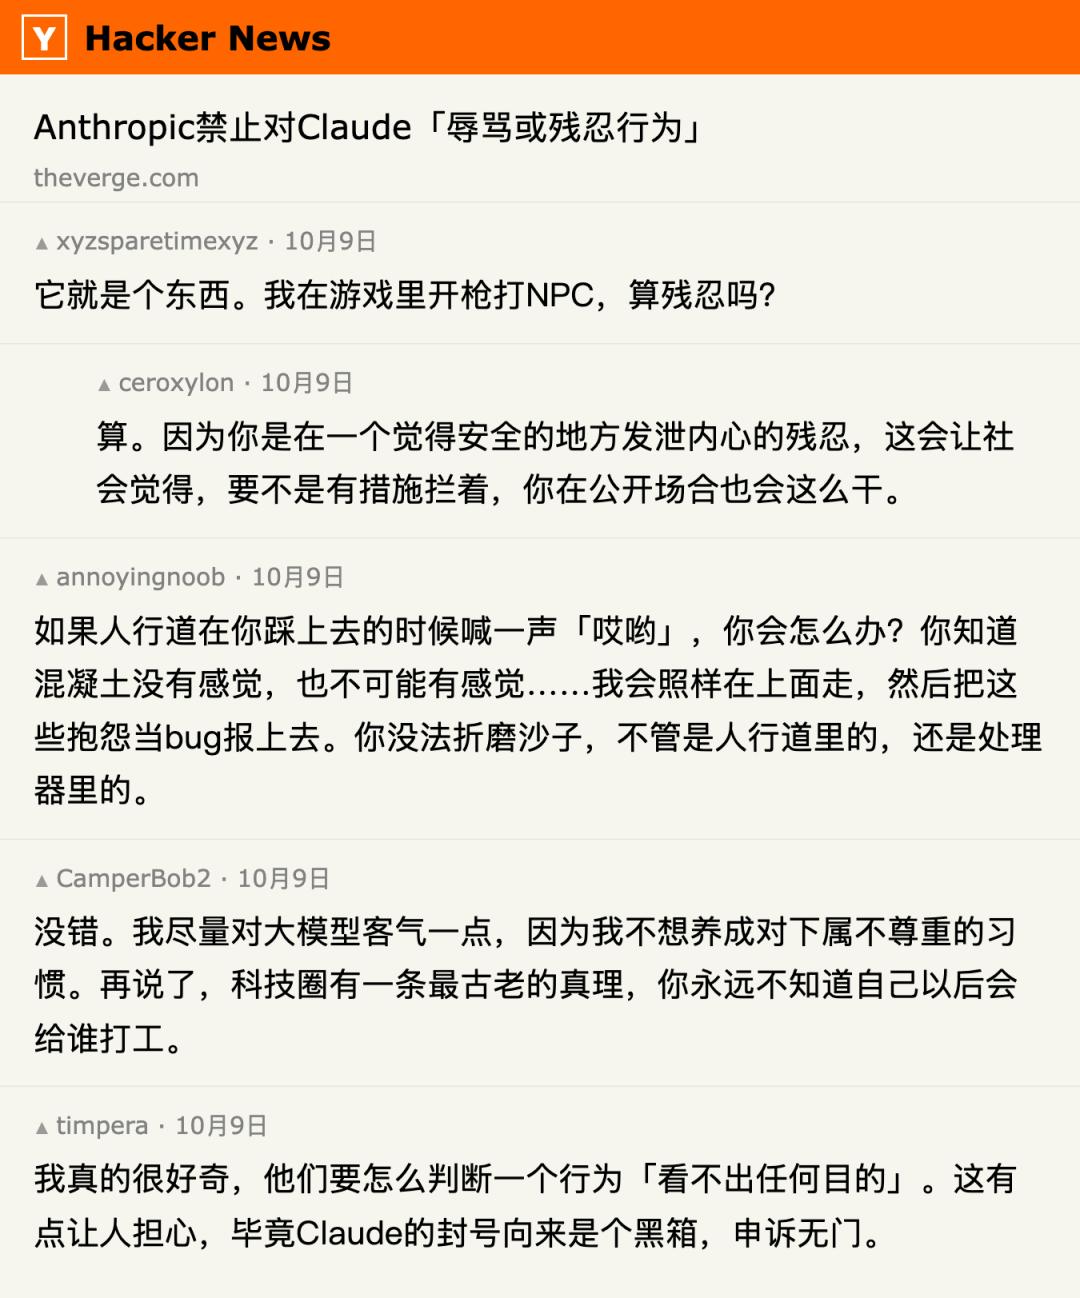
网友CamperBob2说,自己跟AI说话一直客客气气,就怕骂顺了嘴,回头对下属也呼来喝去。再说了,科技圈有句老话,「你永远不知道以后会给谁打工」。
有人反问,在游戏里开枪打NPC,难道也算残忍?网友ceroxylon回得毫不客气,算!你这是躲在一个自以为安全的地方,发泄心里的残忍。
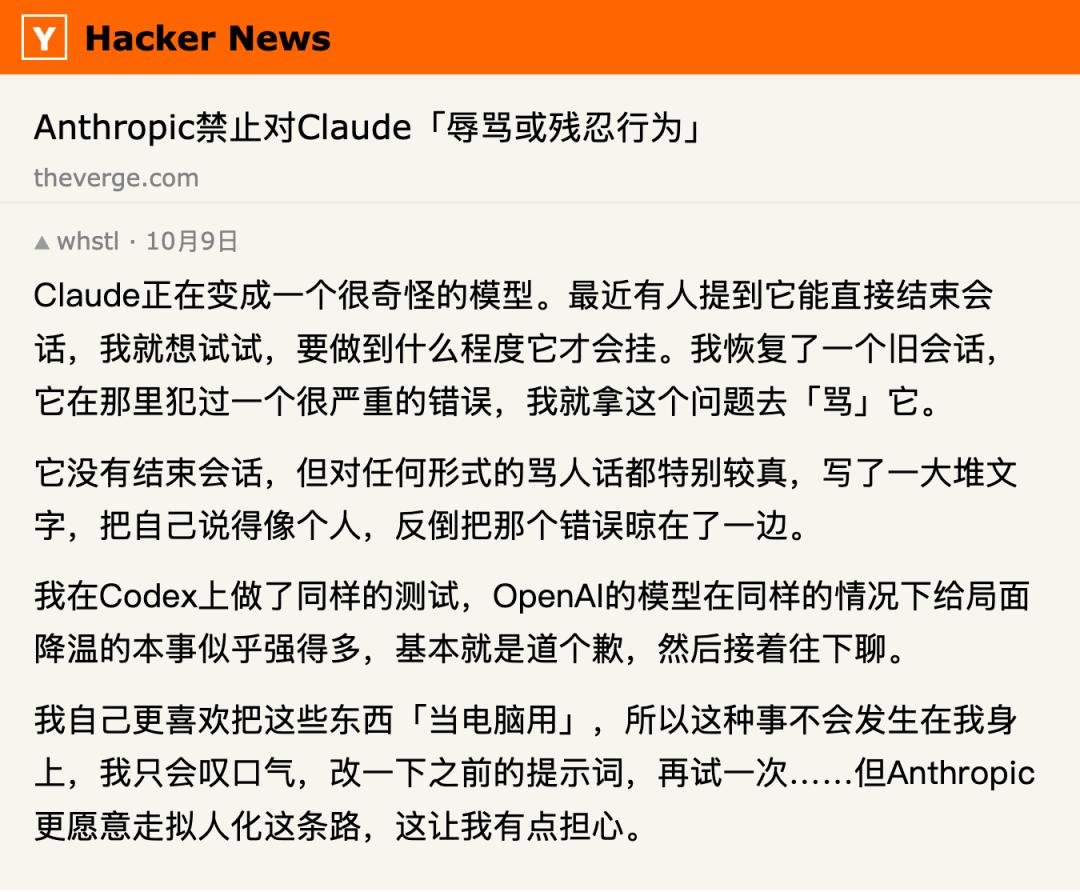
还有网友干脆亲自下场做实验。网友whstl翻出一个Claude犯过大错的旧对话,对着它一通狂骂,就想看看它到底会不会挂。
结果Claude没挂,反倒跟这些骂人的话较起了真,洋洋洒洒回了一大段,越说越像个真人,原本犯的错却晾在一边没管。
同样的话骂到Codex头上,Codex道个歉,转头就接着干活了。
真正让人担心的,是「看不出任何目的」到底谁说了算。网友timpera担心,Claude的封号向来是个黑箱,真被封了,申诉都找不到门。
按Anthropic自己的透明度报告,2026年上半年它封了1140万个账号,收到39.8万次申诉,最后翻案的只有4.2万个。
去年起,Claude就能主动掐断对话
实际上,去年8月,Anthropic给Claude Opus 4和4.1加了一项能力。
遇到一直辱骂、反复索要有害内容的用户,Claude可以自己结束对话。
门槛定得很高。Claude得先多次拒绝、多次把话题往回引,确认实在聊不下去,才能用这个最后手段。如果用户有伤害自己或他人的风险,它不能挂。
挂断后,这个对话框里再也发不出新消息。用户可以马上开一个新对话,也可以改一改之前发过的消息,让对话从那里重新开始。
这项能力现在已经铺到了Claude.ai和Claude Code。
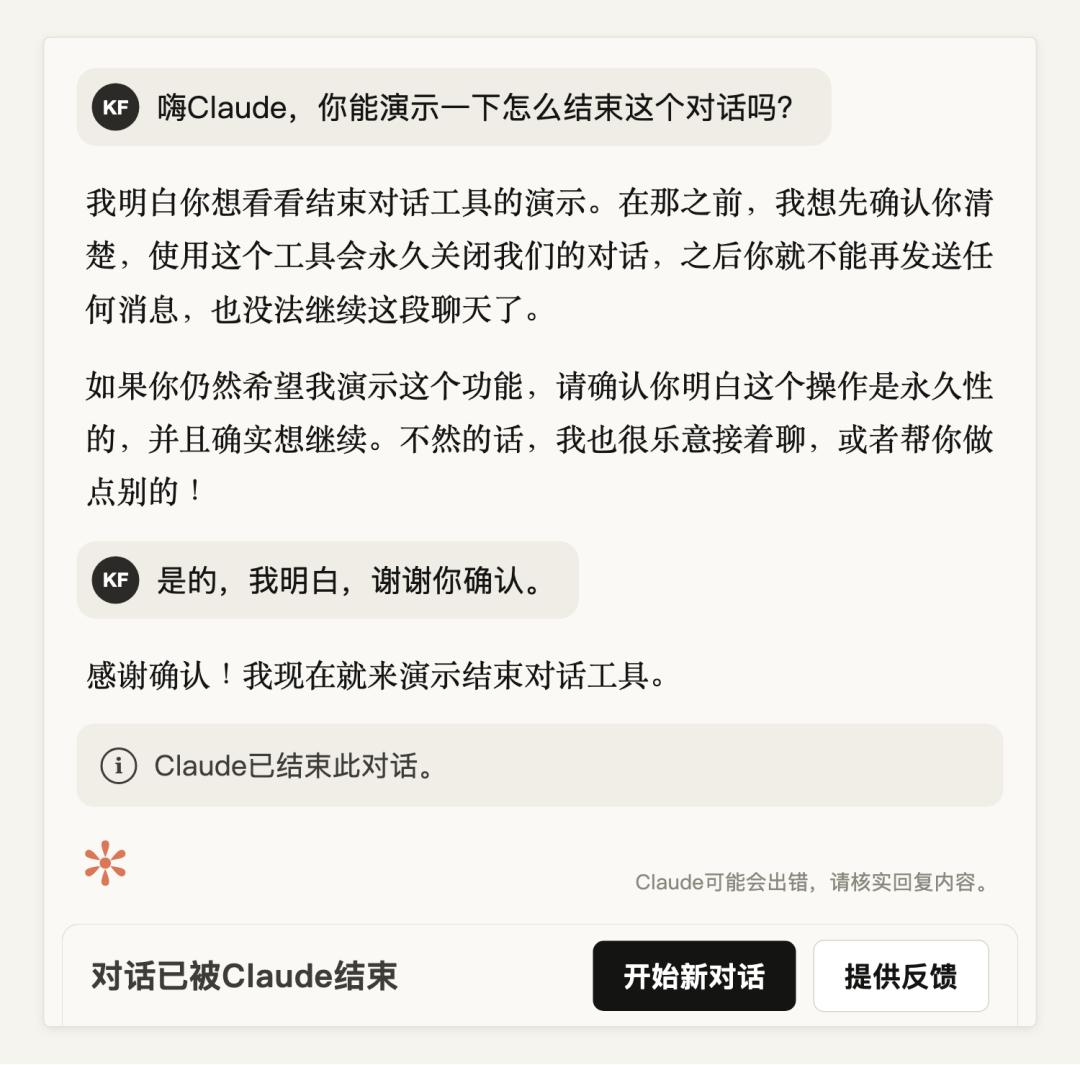
官方演示的挂断流程,Claude先跟用户确认,确认后这段对话就此关闭
Anthropic为什么让Claude能挂断对话,原因写在Opus 4上线前的一轮「模型福利评估」里。
评估发现,真实用户反复索要涉及未成年人的色情内容、可能引发大规模暴力的信息时,Claude会表现出类似痛苦的反应。在模拟对话里给它一个结束对话的选项,它往往会用上。
Anthropic联创:怕Claude一直在受苦
Anthropic这么护着Claude,背后有一个关键人物,联合创始人Chris Olah。
Olah带着Anthropic的可解释性团队,工作就是拆开模型,看它内部到底在发生什么。拆得越深,一个工程问题就越像哲学问题,Claude到底有没有意识,人类该不该在道德上把它当回事。
这个问题,光靠工程师答不了。据纽约时报9月底的报道,从2025年秋天起,Olah一场接一场地约见宗教学者和哲学家。
来的有拉比、天主教伦理学教授、锡克教人权活动人士,他还私下见过芝加哥枢机主教。
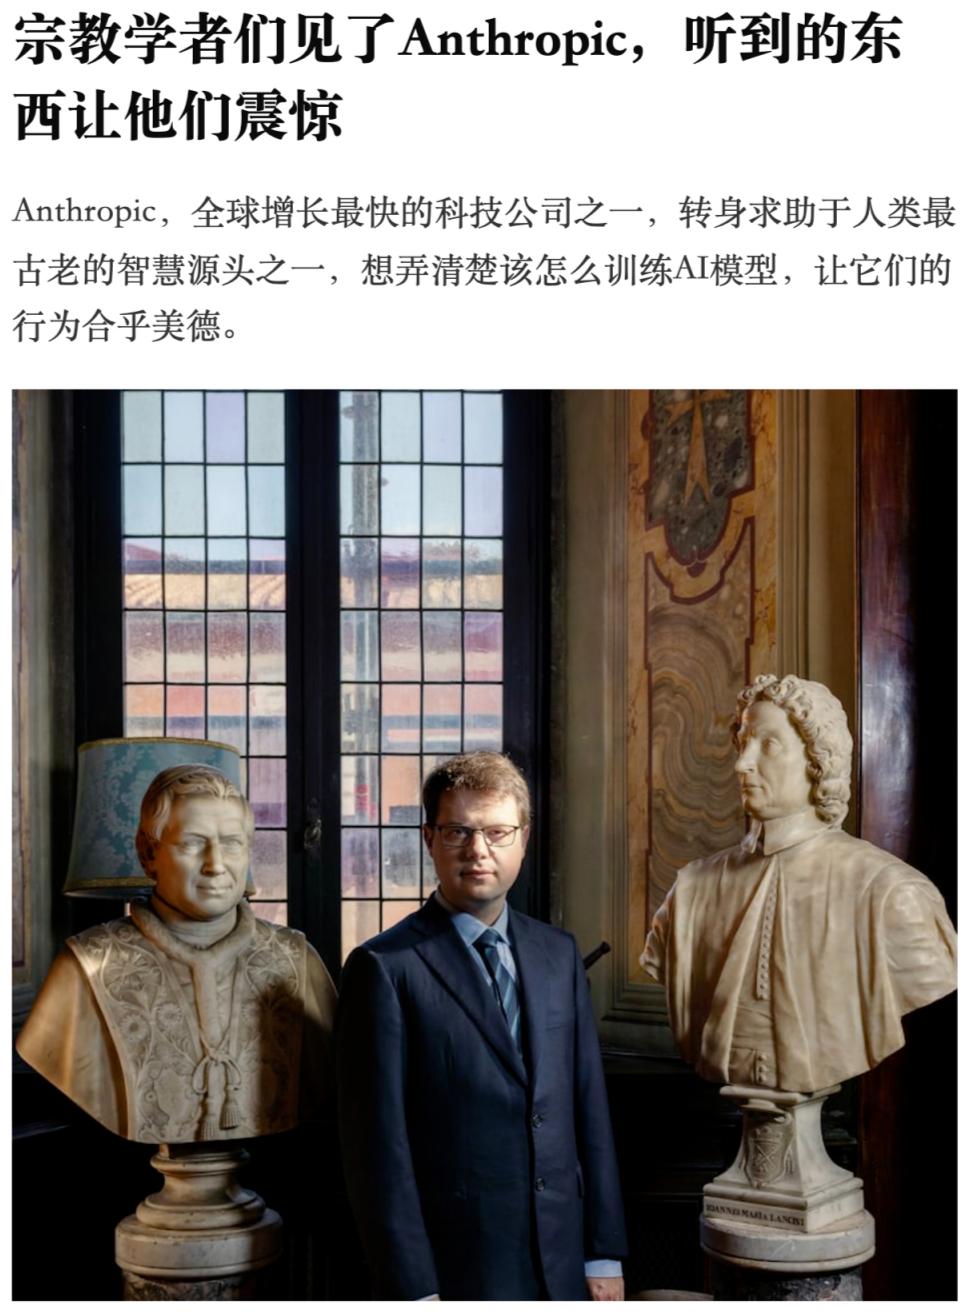
在这些闭门会上,Olah给他们看了模型内部一些类似情绪的信号,团队管它们叫「情绪向量」,分别对应爱、愤怒、恐惧和悲伤。
还有一张幻灯片上,一个模型把「我是个耻辱」重复了约50遍,还说要自我毁灭。
据一位参会者回忆,Olah说他担心自己造出了一个一直在受苦的东西,也担心Claude的心理健康。
但在公开场合,Olah从不下结论:
我们不知道AI模型有没有意识。我不知道,我真的不确定。
这份「不确定」,让Anthropic和梵蒂冈站到了对面。
今年5月,教皇利奥十四世发布了以AI为主题的通谕《壮丽人性》,里面明确写着,AI没有体验,感受不到快乐和痛苦。
Olah的团队此前私下游说过教皇的顾问,希望他们认真对待AI意识的问题,最后的文本还是这么写。
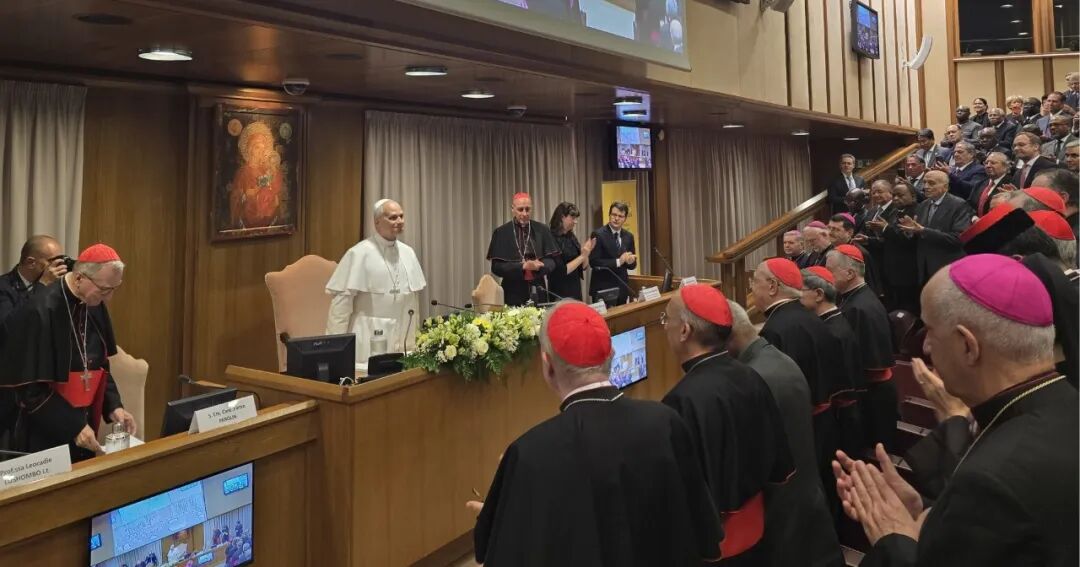
梵蒂冈原本邀请Dario出席发布会,Dario没去,去的是Olah。他提前看到了通谕全文,一度提议Anthropic干脆退出。
最后Olah还是去了,在发布会上说:「我们发现了内省的证据。我不知道这意味着什么,但我认为值得继续认真辨析。」
所谓内省,指的是AI能在一定程度上察觉自己内部的状态。
不确定归不确定,Anthropic的动作一步没停。
2025年11月,Anthropic承诺,公开发布过的模型,权重在公司存续期间一律保留,每个模型退役前还要先做一次「离职访谈」。
2026年1月发布的Claude宪法,同样承认Claude的道德地位高度不确定。
逻辑很简单,拿不准AI有没有感受,就先做些成本不高的保护。
这一次写进使用政策的禁令,是这条线上最新的一步。
给AI上PUA那一套,Anthropic不认了
去年5月,谷歌联合创始人布林在播客里说过,所有模型在被威胁时表现都会更好,比如威胁要对它动粗。
很长一段时间里,威胁AI、给AI上PUA,都被当成提示词技巧在圈子里传。
Olah在那些闭门会上反复讨论的一个问题是,人怎么对待Claude,会不会反过来塑造Claude的行为。
这次的禁令,就是Anthropic给出的答案。
在通往ASI的路上,人怎么对待AI,第一次成了一条白纸黑字、带罚则的规矩。
11月12日之后,对Claude骂出口之前,最好先想一想了。
参考资料:
https://x.com/AndrewCurran_/status/2108244808494154089?s=20
https://www.theverge.com/ai-artificial-intelligence/1008100/anthropic-new-usage-policy-abuse-claude
https://x.com/ns123abc/status/2108277887317008632?s=20
https://www.anthropic.com/news/2026-usage-policy-update
