

 搜索


近两年,视频模型和世界模型蓬勃发展,批量涌现出优秀创业公司,模型本身的进化也极快。模型的进步,带动了应用的进步,例如字节跳动的Seedance,已经成为它在AI领域的收入主力。
而应用的进步,又对基础设施提出了新的严苛要求。例如数字人直播,以及世界模型在仿真领域的应用,它们要求的不是单纯的内容生成,更要求与用户以及“环境”互动。
这让AI发生了根本性转变:AI不再仅是依靠提示词驱动的工具,而是演变为了用户可以置身其中并进行实时交互的体验。
实时性,成为AI模型和应用对基础设施提出的新要求,但目前市场上缺乏能够在生产环境中实时运行多模态模型的平台。
不过,一家叫Reactor的创业公司正在试图构建这个基础设施层,它希望能让开发者通过SDK与API,只需几行代码即可构建实时交互式应用,它的平台可支持60FPS以上、低于40毫秒延迟的实时模型运行。
这可能催生创业者在媒体娱乐、物理AI及机器人等领域构建新一代交互式AI应用。
Reactor此前获得由Lightspeed Venture Partners领投,WndrCo、Amplify Partners、Sky9 Capital、FPV Ventures及其他投资者参投的5900万美元种子轮+A轮融资,近日它又获得NVIDIA与Sapphire Ventures的A轮追加轮融资,总融资额达到7400万美元。
世界/视频模型走向实时交互,对基础设施提出新的要求
技术的变革首先出现在模型端,Google DeepMind的Genie 3能以24 FPS的帧率生成720p交互式世界;StreamDiT在单张H100上实现了16 FPS的文生视频,阿里、腾讯、包括NVIDIA也都发布了交互式的视频模型或世界模型。
在生成式多模态模型发展的早期,它生成的是一次性、被动的内容,大家都有用提示词批量化“抽卡”的经历。
但交互式视频模型,尤其是可交互的世界模型出现后,模型的形态变了,这些模型本质上是经过学习的物理引擎。通过观察数十亿个样本,它们内化了底层的物理规律,从而“懂得”火会蔓延、水会溅起、金属受击会凹陷。用户置身于环境中进行操作,模型则以逐帧的形式实时给出反馈。
新形态的模型,也催生了新形态的应用,实时视频、游戏以及数字人领域涌现出了大量新的交互形态。
模型对于基础设施的要求变了,但支撑这些模型在生产环境中运行的基础设施却未能同步跟上。原有的基础设施,是为批处理(batch)需求构建的,它在底层架构上与实时推理需要的基础设施有根本差异。
实时推理所需的基础设施:要在多次交互中保持状态持久化,具备低于50毫秒延迟(此前行业平均延迟普遍在400毫秒以上)的双向流式传输能力,支持实时控制输入处理,并具备能在数千个生成帧中保持一致性的会话编排能力。
算力需求也随之呈指数级增长。以前用提示词“抽卡”模型,每生成一次内容只需运行一次,而交互式世界模型和视频模型在每次会话的每一秒都在不间断地运行。
因此,推理需求的增长不再取决于请求次数,而是与用户的参与时长直接挂钩。用户在世界模型中停留的每一分钟,都对应着一分钟的GPU实时计算。这意味着,无论最终哪家模型或哪类应用场景脱颖而出,底层的服务层都将直接享受到该赛道增长带来的红利。
构建一个实时生成式视频推理平台就是Reactor的切入点,而这个需求,来自于Reactor的创始团队对于范式转换的敏锐洞察。
Reactor由Alberto Taiuti(CEO)和Bryce Schmidtchen(CTO)共同创立,两人此前均曾担任Apple Vision Pro的技术负责人。Taiuti此前还是Luma AI的联合创始人兼CTO,曾为这家3D与视频生成独角兽搭建了底层基础设施。Bryce Schmidtchen则在Apple干了7-8年,参与构建了visionOS软件。
Reactor由Alberto Taiuti和Bryce Schmidtchen共同创立,图片来源:Reactor
它们的团队还汇聚了来自Apple、Netflix、Meta、Google、Adobe、Replicate以及Microsoft的工程师与研究人员,在图形学、实时系统、交互式媒体以及扩展AI基础设施方面拥有深厚经验。
在Luma AI的经历,让Alberto Taiuti看到了模型研发与模型投入生产之间的鸿沟:研究团队把全部精力都投入到了模型训练上,这就导致他们没有多余的资源和时间去思考如何在大规模环境下运行这些模型、进行推理。
当两位创始人在Apple Vision Pro团队构建产品时,就会思考:如何让模型在端侧(on-device)的极低功耗限制下优化,如何确保它们能在10毫秒以内的延迟下以交互帧率运行,他们擅长对“把极其庞大的系统塞进极小空间”这种极端工程条件进行优化。
过往经历,让他们意识到,当多模态模型及应用的需求爆发,需要一个平台去填平模型研发与模型投入生产之间的鸿沟。
当他们真正动手去做时,就发现,从底层的推理层、GPU云架构、流媒体和网络层,一直到开发者体验、API设计,乃至整个系统的架构模式,多模态模型推理的每一个环节,从底层到顶层,都与大语言模型有着本质的区别。
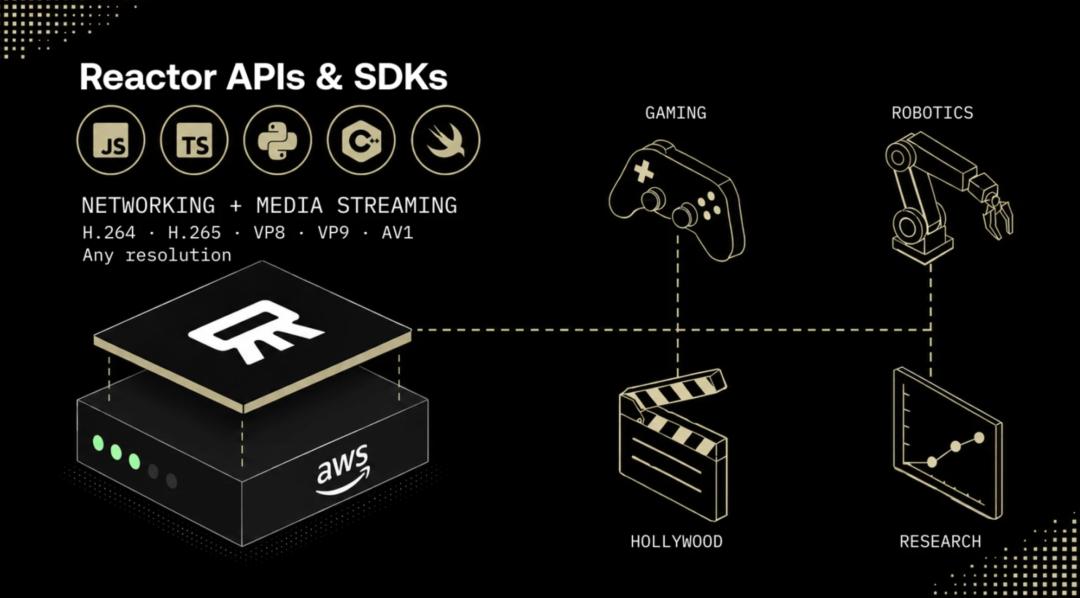
Reactor构建的平台。底层是可按需调度的全球GPU云,中间是针对视频和世界模型低延迟推理优化的自研推理引擎,上层再接低延迟流式传输,把模型输出以实时视频流的方式返回给应用。
这个平台能让开发者与企业以60 FPS以上的帧率及低于40毫秒的延迟运行模型。这一切均可通过统一的SDK和API实现,从而屏蔽了大规模部署与扩展这些系统的复杂性。
为了达到这样的性能,Reactor的团队必须重新思考机器学习系统的诸多细节:如何进行内核级优化(kernel level optimizations),如何设计云端控制平面。甚至需要讲模型进行机器学习层面的改进、定制CUDA代码以及Torch优化,转化为达到生产级可用标准的模型。
一个实际的例子是,Reactor与AWS Neuron Science团队合作,将实时自回归扩散视频模型部署到AWS自研AI芯片Trainium上。
与普通视频生成不同,运行实时交互类视频/世界模型的系统,其瓶颈不只在算力本身,还包括视频帧位置计算、注意力计算、缓存复制、显存占用和解码等环节。
双方通过Neuron Kernel Interface对底层计算进行重写和融合:例如将原本需要约5秒的3D-RoPE位置编码计算压缩到1.8毫秒,将每层约23毫秒的缓存复制降至1.9毫秒,并把原本容易爆显存的流程控制在11GB HBM内运行。最终,团队在单颗Trainium2芯片上跑通了实时视频生成。
Reactor的平台上,已经汇集了一批可实时运行的视频模型和世界模型。其中既有实时世界模型,也有支持动作控制的世界生成模型;还提供带同步音频的实时视频模型,以及面向视频编辑、数字人、直播生成和无限视频流的模型。其中有很大一部分,是中国的开源模型。
当基础设施平台实现实时推理,将解锁新的应用创业机会
Reactor现已在媒体与娱乐行业投入使用,好莱坞主流制片厂、广告平台及视频流媒体服务商均在Reactor平台上推进活跃项目。
图片来源:Reactor
它的创始人在博客访谈中,分享了一些他们的用户怎么利用交互式视频构建应用的例子。例如,教育方面,如果想向AI了解一个事情,相比读一段文字,实时视频的演示,显然是更好的方式。已经有不少创业公司在使用Reactor构建教育应用。
AI视频剪辑应用,会解锁准专业级(Prosumer)应用。用户在修改视频时,可以立刻看到效果,不用为了看一个修改效果干等5分钟(如果在PS里做一个修改,然后需要等5分钟,那它就没人用)。
可交互的影视游戏,拥有电影级的画质,同时用户又能进行实时控制和引导。开启了全新媒介——电影与游戏的混合体。
最后是广告营销:当用户在看电影或其他内容时,系统能够极其巧妙地植入一条专门针对用户生成的个性化广告。
物理 AI 与机器人技术是Reactor另一个自然应用场景。随着机器人策略与世界模型变得愈发强大,许多模型所需的算力已远超机器人或自主系统本身所能承载的极限。Reactor 能够在云端运行这些模型,同时在模型与物理系统之间实时传输观察结果与动作指令。
Reactor还能将世界模型作为闭环仿真环境运行,使机器人策略能够在逼真且具备响应能力的生成世界中进行训练与评估,而无需完全依赖物理机器人或手工搭建的模拟器。无论是开源模型还是客户专属的私有化系统,团队均可使用Reactor来部署、评估并训练机器人策略与世界模型,无需自行搭建低延迟推理基础设施。
以上这些应用,能够成立的前提是两个,交互类视频生成和世界模型逐渐成熟,以及有一个可以稳定的,能够实时推理这些模型的平台。模型和基础设施的共同变革,解锁了应用端的新可能性。
要打造这种新型的基础设施,对于创始人的要求不低:他既要懂得应用端/模型端的需求,又有搭建和克服基础设施问题的经验。这样的创始人,更可能发现和解决新的问题。
而在这种NeoCloud方向创业,模型的进步,芯片的技术突破,新形态的应用,对于他们都是好事。因为它处于整个生态系统的基础层,生态的发展,能够带动它发展。
而它的护城河,可能不仅是规模、算力储备和技术,更是提供给开发者和客户的极致体验,它是包含核心技术在内的综合能力,创始人要把它当成一个产品,而不是一项技术来打造。
