

 搜索


以 GPT-6 Astra 为代表的通用大模型,虽赋予了机器人强大的视觉与语义推理能力,但由于缺乏高频的力学求解与本体感觉感知,导致“大小脑”严重割裂,只能输出缺乏动态纠错的“盲操指令”。这种“懂语义、不懂物理”的认知缺失,让机器人的实机状态极不稳定:时而展现惊艳的灵巧操作,时而陷入低级的碰撞与失脱。
而谷歌最近发布的 Gemini 4(Argon)为弥合这一断层提供了一个新的解法。在其技术博客中,Argon 被明确定义为一种专注物理世界交互的通用物理推理模型。抛开首发时的行业喧嚣,当我们重新审视其能力底座时,发现 Argon 最核心的护城河建立在其更胜一筹的物理常识之上。
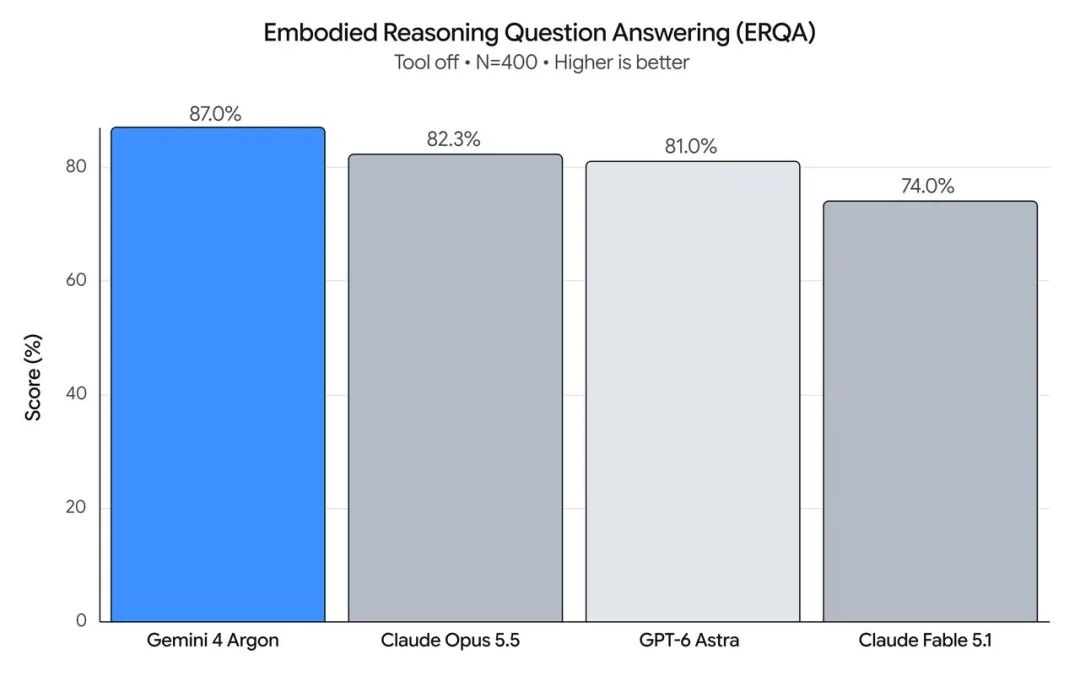
在 ERQA 具身推理基准测试中,Argon 拿到了 87% 的高分,超越 Claude Opus 5.5 (82.3%)、GPT-6 Astra (81%)等前沿大模型,证明了 Argon 强大的物理常识底座。
在目睹了 Argon 的表现后,Google DeepMind 资深机器人科学家 Konstantinos Bousmalis 感叹道:“Argon 目前展现出的能力已经让我惊叹不已,更不用说它未来的发展前景了!这将对机器人技术产生巨大的变革。”
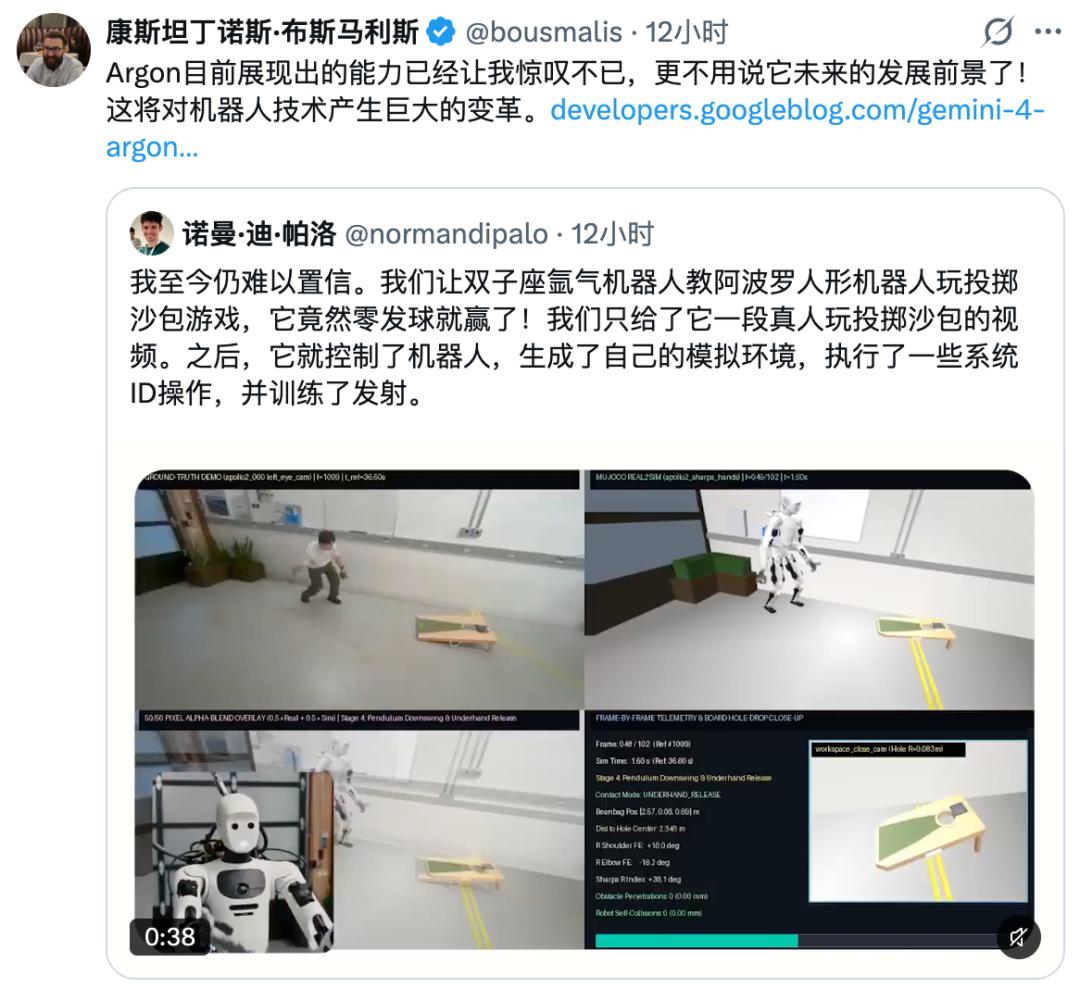
支撑起他这份惊叹的,正是 Argon 在实测中所交出的全链路答卷。凭借原生的三维物理理解、长程代码生成与视频时空推理能力,Argon 作为核心物理编译器,以一己之力替代了以往繁杂的算法组合与团队分工,打通了从控制执行、仿真重构、数据标注到自我改进的机器人全生命周期:
- 控制执行层:零微调下场,用视觉伺服规避“开环盲操”。
- 虚拟仿真层:重构 500Hz 物理孪生,填平“虚实鸿沟”。
- 数据开发层:四层语义自动化质检,免除人工标注。
- 自主改进层:打通数据飞轮,实现真机算法“原生闭环迭代”
零微调下场,抓空自己纠错
在机器人控制执行的环节,通用大模型长期以来的痛点在于测不准距离、抓空易卡死、盲目硬撞。而 Argon 的核心作用是充当一个自带“物理直觉”与“及时停止”的原生闭环大脑,将粗放的语义指令转化为精准的物理微操。
为什么 Argon 能在不做任何机器人专项微调的情况下,直接接手真机?首先翻开它的底层成绩单:
一方面是极高的三维物理认知:
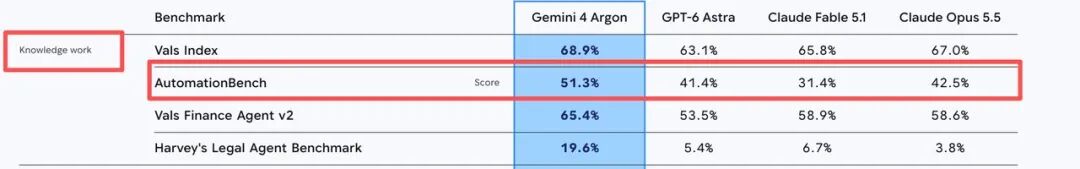
除了上文提到的 Argon 在考验空间推理与物理常识的具身推理基准 ERQA 上获得最高分87%以外,它在跨领域自动化基准 AutomationBench 上,同样以 51.3% 拔得头筹。这赋予了它读懂坐标标尺、算准空间位置的底层能力。
另一方面是“及时停止”:
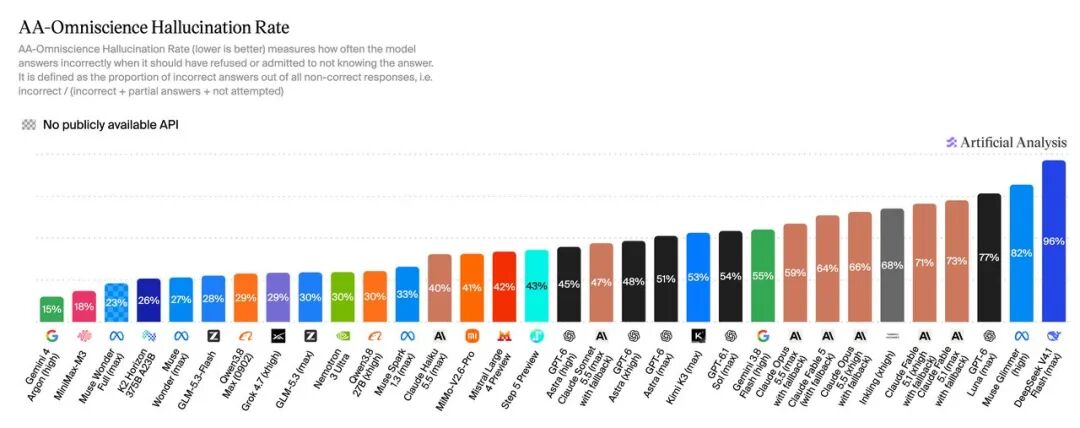
在独立评测机构 Artificial Analysis 的 AA-Omniscience 测试中,GPT-6 Astra 与 Claude Opus 5.5 的幻觉率分别高达 51% 和 59%,而 Argon 将幻觉率死死压在 15%,不到竞品的三分之一。这意味着,面对知识边界和不确定的问题,Argon 在该项测试中更少给出错误却自信的回答。若放到机器人语境,可以理解为它可以给真机装一道“最后关卡”——看不清时不盲目指挥,而是先核实再动手。
所谓的“幻觉率”,测的是当大模型遇到自己看不清或拿不准的问题时,到底有多大概率会“不懂装懂、自信地瞎编一个错误答案”,而不是老实承认不确定并停下来核实。
谷歌给出的第一个实测现场是多智能体协同控制-机器狗投掷垃圾:
一只腿部 12 个自由度、机械臂 6 个自由度的波士顿动力 Spot 机器狗,接到的是一个高难度连贯任务:把前方的可乐罐捡起来,扔进带有脚踏板的黑色垃圾桶里。这不是简单的抓和放,机器狗得先用三条腿站稳,腾出右前腿去踩开垃圾桶踏板,同时机械臂还得瞅准时机把易拉罐送进桶口。
面对极其考验手脚配合的操作,Argon 采取了“先虚拟预演、再多智能体核验”的控制策略:
- 它先在 MuJoCo 物理仿真器里建立一个带开合翻盖关节的脚踏垃圾桶,自己在脑子里把“三足站立、踩踏板开盖”的动作提前演练了一遍。
- 真机落脚前,先调取前置相机,确认右前脚对准踏板中心;
- 踩踏过程中,后台派出两个独立 AI 助手同时盯防:只有当“足部验证器”确认踩稳踏板顶开桶盖、且“手部验证器”确认机械臂对准桶心后,才下令松爪投放,将可乐罐送进桶里。
如果说机器狗扔垃圾靠的是“先演练、再互查”,那要是遇到完全陌生、也没法提前建仿真的任务,Argon 还能应付吗?
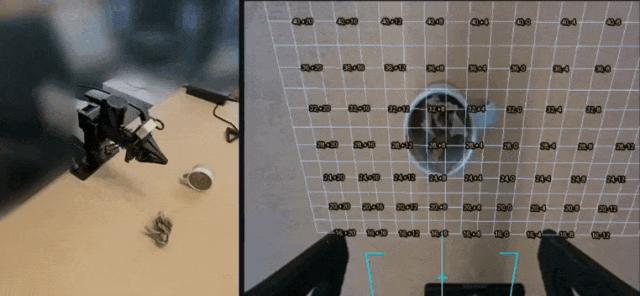
紧接着的第二个实验,就是厘米级动态纠错(机械臂扶正水杯):
在零样本的桌面实机操作下,面对倒下的水杯,Argon 并没有让机械臂执行危险的“开环盲抓”,而是使出了一套极具容错率的视觉伺服策略:
- 降维建立锚点: 在二维画面上直接投射精确到 2 厘米的坐标标尺与夹爪准星,将复杂的三维抓取转化为精准的视觉对位。
- 闭环伺服微调: 彻底摒弃传统程序一次性给坐标的“开环盲猜”,转而采用“看一步、动一步”的实时测算机制。
- 自主纠错兜底: 即使中途抓空也绝不报错宕机,而是立刻触发“抬头重看 → 重新解算 → 再次下爪”的补救循环,依靠原生物理直觉稳稳将失误圆回。
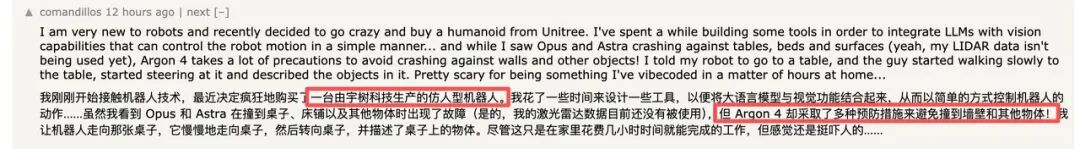
第三个实测是零雷达安全避障(宇树人形实测验证):
一位刚入手宇树(Unitree)人形机器人的开发者在 Hacker News 社区里分享了实测体验:在关闭宇树人形机器人激光雷达、仅靠纯视觉控制时发现:相比于其他大模型带着机器人撞向桌椅,换上 Argon 后,机器人快走到桌前会主动放慢脚步、拐弯避障,最后稳稳绕到桌子正前方辨认物品。
看到 Argon 的表现,Google DeepMind 资深研究科学家 Thomas Kipf 在 X 上直言:“前沿大模型如今已经能够直接实现零样本机器人控制,Argon 在这领域展现出的能力太让人振奋了。”
这一系列实测表明,通用大模型正在跳出单纯的“高层任务拆解”,展现出基于视觉反馈的原生闭环控制能力。
随手一张图,秒建物理仿真
在机器人的研发全链路中,实机微操往往是最后一步;而在开动真机之前,构建高保真的数字孪生环境进行虚拟预演,又是一步难跨的工业门槛。
以前搭一个虚拟环境全靠工程师“手搓”,需要用尺子量物体大小、手写几百行建模代码,并反复调试物体的质量与摩擦力参数,动辄耗上数周时间。如今,Argon 练出了第二项绝活——看一眼现实画面,就能全自动生成物理仿真环境(Real2Sim)。
Argon 将这一繁重的物理重构过程,压缩成了极度简化的“自动翻译”(Real2Sim)——仅需输入一段现实画面或草图,便能直接输出可运行的 3D 物理引擎代码。
视频 1:1 孪生(解构机器人录像)
第一组实验是先给 Argon 播放一段第三视角的真实机器人遥操作视频。接收录像后,Argon 能直接生成 MuJoCo 引擎的三维数字孪生代码,并通过视觉反推,自动补齐物体的质量与关节阻尼。
在严禁代码作弊(如偷偷添加虚假外力或直接修改物体坐标)的前提下,其构建的虚拟环境连灵巧手指尖的物理接触动力学,都能与真实录像严丝合缝地对齐。
跨物种动作映射(解构人类视频)
较之第一组,第二组实验是一段以人类第一视角为主的双手拿放物品的视频。
即使面对骨骼结构截然不同的人类双手拿放视频,Argon 也能将人手动作精准转化为关节逆运动学(IK)代码,并无缝“移植”至一台全身 76 个关节、配有 22 个自由度五指灵巧手的人形机器人上。
在生成的虚拟空间内,机器手全凭原生指尖摩擦力稳稳抓取物品,全程无穿模与打滑现象。
这一组比较夸张的是,哪怕连视频都没有,工程师仅凭一张随手画的“人形机器人丢球砸倒桌上 6 个金字塔堆叠箱子”的简笔草图拍照上传,Argon 也能瞬间读懂二维笔触背后的三维空间排布,自动写出物理仿真环境与 140 步全身抛投轨迹,在闭环物理引擎中实测验证“6 个箱子被一击全中”后,顺手还调用 Blender 渲染出了一段光影逼真的视频。
凭借这种“看图即建模、写码即仿真”的能力,Argon 不仅在工业级测试中大放异彩,更迅速向下兼容,成为了社区开发者手中的“破圈”利器。
随着 Antigravity 平台上线,有开发者用手机拍摄了几张杂乱的办公桌照片,上传之后,Argon 便转眼调起 Blender 和 Three.js 引擎,将真实的键盘与水杯逆向还原成了一个带有真实碰撞效果的 3D 桌面赛车游戏。
甚至有极客玩家,直接让 Argon 从零编写机械臂模型、配置网页 3D 仿真与控制接口,在毫无人工干预的情况下,现场“组装”出了一台能自动还原魔方的虚拟机器人。
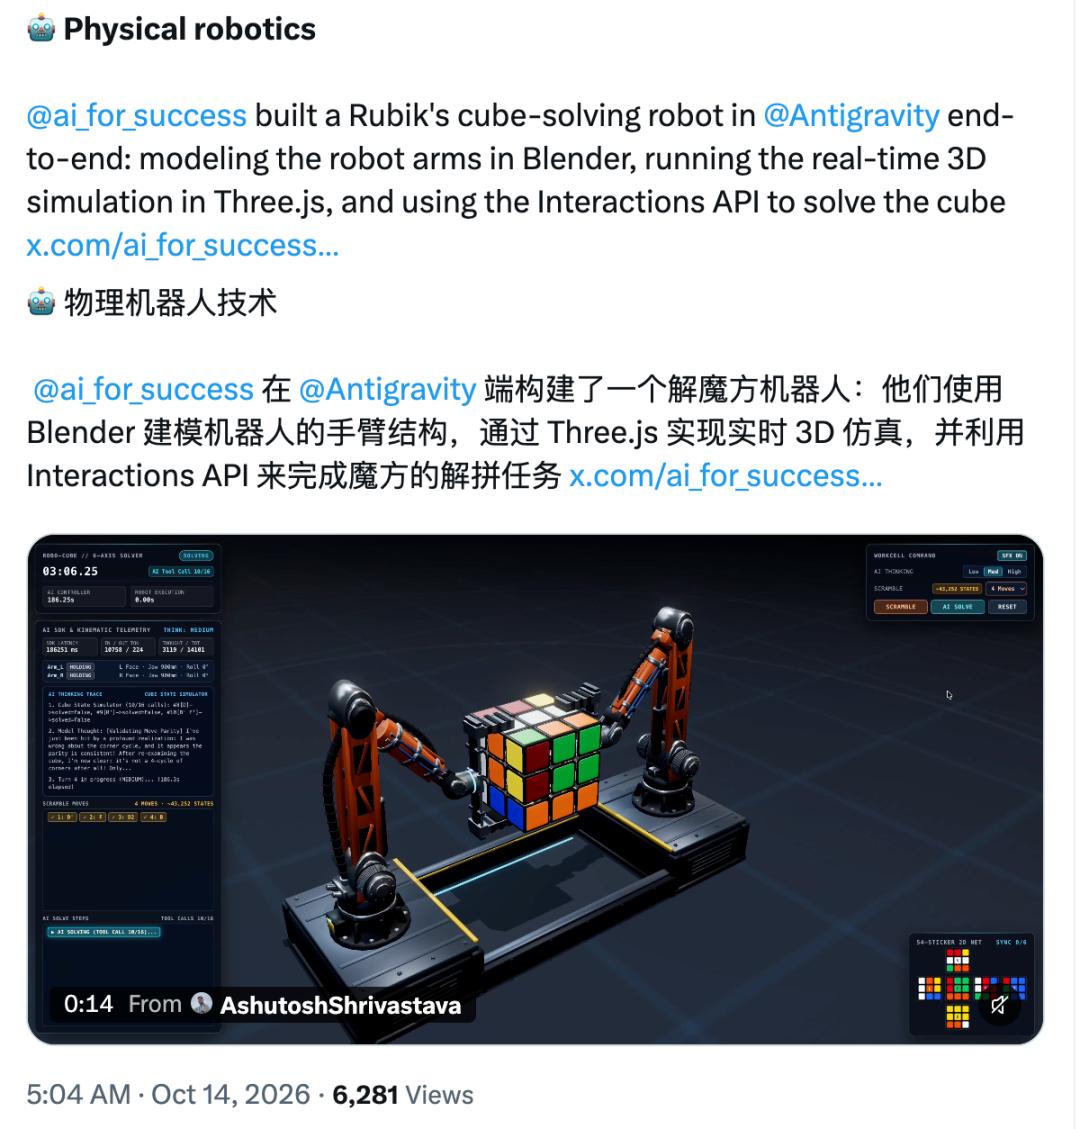
看一眼画面,就能自动写出全套 3D 物理引擎代码,这种跨模态工程能力的背后,源于 Argon 极致的代码生成与三维几何推理能力。
在官方公布的数据中,Argon 不仅拿下了 3D 空间与蓝图几何基准 Blueprint Bench 2 的榜首,更在真实软件工程基准 DeepSWE v1.1 上拿下 77.9%(第一),在应用构建基准 Vibe Code Bench 上斩获 91.9%(第一),超越 Claude Opus 5.5(74.2% / 90.3%)与 GPT-6 Astra(74.1% / 89.6%)。
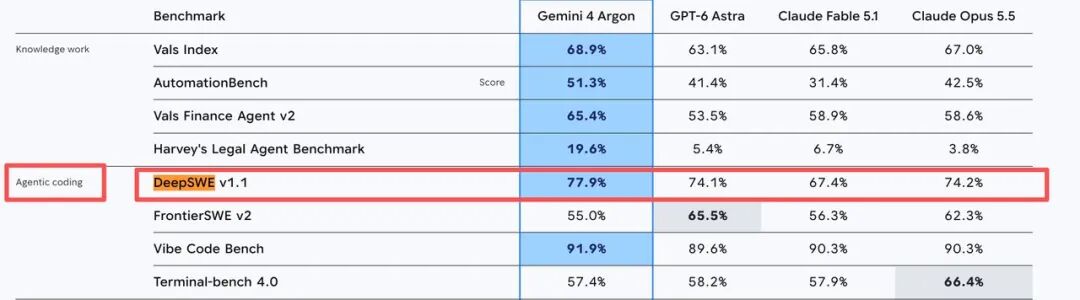
依托三维空间感知与代码工程实力,Argon 打通了从二维视觉输入到三维物理仿真代码(Real2Sim)的全自动生成闭环,让高门槛的物理仿真建模变成了“看图即建模、写码即仿真”的自动化工程。
化身质检员,揪出废动作
教机器人干精细活,数据质量历来是最大掣肘。由于人类遥操作录像不可避免地夹杂着停顿与抓滑等瑕疵帧,直接投喂会教出动作笨拙的机器人,而人工逐帧清洗又面临着极高的成本壁垒。
而 Argon 给出了一个颠覆性的解法:Argon 不仅仅是一名操作者,更是一名“通用视频质检员”。凭借原生的长视频理解能力,Argon 无需单独训练专门的奖励模型,就能看懂“哪些动作有效、哪些动作是废操作”,从而自动完成海量数据的高优清洗:
四层语义解构(双臂折纸狐狸)
视频画面中,双臂 ALOHA 2 机器人正在将一张正方形纸折成狐狸的样式。折纸看似简单,对机器人却颇具挑战:一只机械臂要固定纸张,另一只则要配合折叠、旋转和压平折痕。操作过程中,夹爪难免出现抓握不稳、停顿和反复尝试的情况。
Argon 通读视频后,给出一套与视频时间轴对应的四层标注:
- 先定下把纸折成狐狸的总目标;
- 再把全程切分为 6 个阶段,理清左右手分工;
- 紧接着细化出 17 个接触级动作;
- 最后精准揪出夹爪打滑、纸张分层等无效操作,明确将这些失误帧标记为停滞,建议在后续训练中直接把权重砍至 15% 到 25%。
基于此,后续模型在学习时就会自动忽略这些手滑的废动作,只吸收干净利落的正确操作。这也意味着原本需要人工逐段检查和标注的操作数据,如今可以由通用大模型辅助完成处理。
实时状态推演(双臂分拣戒指)
除了挑错,Argon 还能精准判定任务进度。在穿戴式夹爪的三机位同步录像中,面对 60 秒的复杂操作,Argon 充当起了“通用价值函数”。它能围绕手指接触戒指的瞬间,画出实时起伏的任务进度曲线,将哪一步在推进、哪一步在停顿、哪一步在倒退,拆解成了 28 个逻辑极其清晰的训练片段。
能把一帧帧像素画面,看懂成“物理状态的有效推进”,离不开 Argon 原生的长视频理解能力。在长视频理解基准 LVBench 上,Argon 直接打出了 91.7% 的全场最高分,大幅甩开了 GPT-6 Astra 的 87.5%、Claude Opus 5.5 的 83.7% 以及 Claude Fable 5.1 的 79.7%。
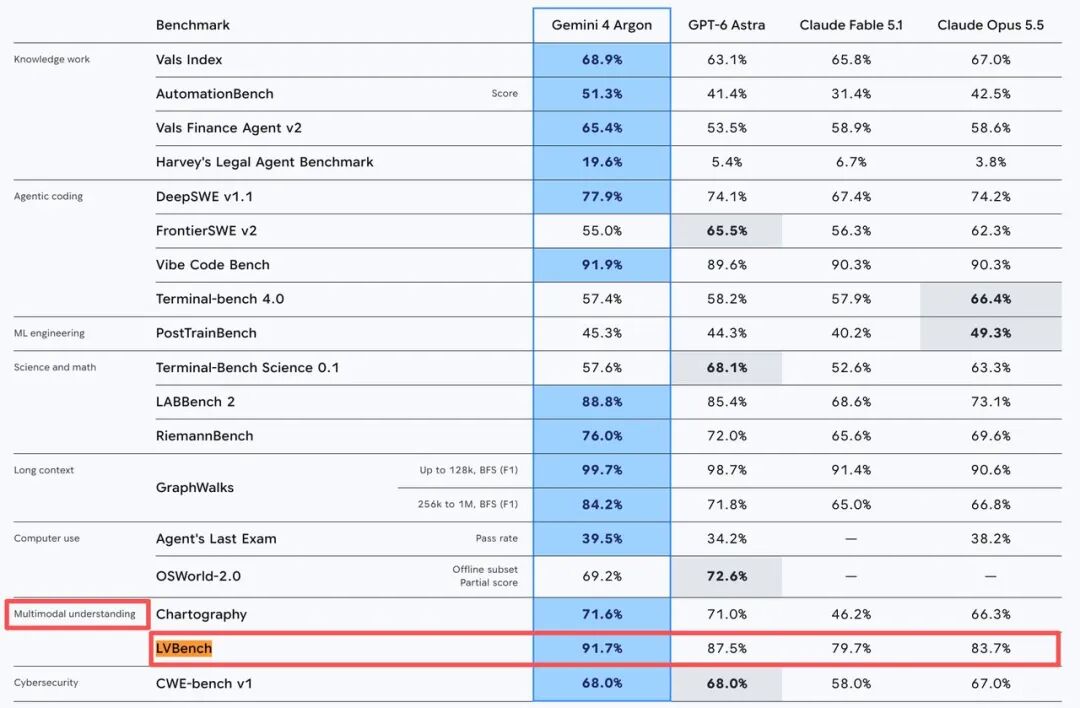
这意味原本需要耗费庞大的人力团队去逐段检查、打标和剔除的操作数据,如今完全可以交由 Argon 自动化流水线完成。它不仅将工程师从繁琐的数据泥潭中彻底解放出来,更让机器人底层控制模型(如 VLA)只吸收干净利落的正确操作,从源头上保证了“微操”的下限。
自己造数据飞轮
当一个底座模型既能全自动搭建仿真,又能化身质检员清洗数据时,将这两项原生能力在底层闭环耦合,便催生出了物理世界里的“自主改进”。
在研发链路的最顶层,Argon 摒弃了传统人工喂数据的被动模式,单凭强大的长程推理能力,便跑通了从“三维重建、任务编排到批量合成”的完整自我改进飞轮:
零样本虚拟造数(双臂桌面实测)
研究人员只给了 Argon 一张双臂 Franka 机器人工作台的俯视静态照片,桌上散落着红色的帽子、眼镜等 9 件派对的拍照道具。
没有任何人工协助,Argon 单凭一张静态照片,就全自动跑通了从三维重建、任务编排到批量合成训练数据的完整飞轮:
先照着照片里 9 件道具的尺寸、颜色和姿态,在 MuJoCo 里一比一重建了 3D 虚拟桌面,甚至给软毛绒帽加上了带弹簧铰链的可变形皇冠;
接着自己编排了包括单双臂抓取、扶正、推物、空中交接在内的 77 项训练科目,并在不断随机变换道具位置的虚拟环境里,一口气自动采集了超过 4,500 条 成功的训练轨迹。
研究人员拿 Argon 自己造出来的 4,500 多条虚拟经验,去微调通用的视觉-语言-动作(VLA)模型并装回真实的双臂机器人身上,效果立竿见影:在不增加任何一条真机采集数据的情况下,真机干活的平均成功率直接从 56% 飙升到了 75%,平均完成时间更是从 35 秒缩短到了 24 秒。
真机自主复盘纠错(单臂乐高分拣)
在真实硬件上,Argon 同样展现出自我纠错能力。在操控 6 自由度机械臂抓取积木时,它每完成一轮便主动调取运行日志与录像进行“复盘”。发现上一次放积木擦碰边缘后,下一把立刻主动修正轨迹。仅需 3 轮自我迭代,操作耗时便从首轮的 58.9 秒压缩至 17.4 秒,任务耗时减少约 70%。
前沿论文一键复现(算法沙盒复刻):
最后,谷歌展示了一个跨模态的自动化工程实践:用一句话(One-prompt)把机器人论文复现进浏览器里。
哪怕是《DeepLoco》、《HUSKY》、《Whole-Body MPC》这类具有复杂控制网络与轨迹优化算法的论文,研究人员也只需输入一句提示词,连同论文 PDF 与开源权重一并丢给 Argon。Argon 便能通读全文并精准还原电机增益等物理参数,直接生成可交互的网页仿真沙盒。更关键的是,它还会自主调用无头浏览器(Headless Chromium)连跑 300 帧完成零报错自检。目前,已有 68 篇论文完成了全自动复现。
从榜单上看,在 GraphWalks 百万上下文推理榜单(256K–1M) 上,Argon 拿下了 84.2% 的高分,领先 GPT-6 Astra(71.8%)、Claude Opus 5.5(66.8%)和 Claude Fable 5.1(65.0%)超过 12 个百分点,并支持高达 100 万 Token 的上下文窗口,展现出处理复杂长程任务的潜力。
此外,谷歌 CEO Sundar Pichai 分享的一项极限测试更是印证了其工程耐力:面对复杂的机械 CAD 图纸,Argon 在无人干预的情况下,自主执行了 1,000 轮“写代码、看渲染图、修代码”的极限闭环,最终交出了一段丝滑的工业级爆炸拆解动画。
由此可见,Argon 已将仿真生成、动作质检与超长程代码工程彻底打通,真正成为了驱动机器人算法自我改进的自动化引擎。
正如人形机器人明星公司 Agility Robotics 的 AI 负责人 Chris Paxton 所感叹的:以 Argon 为代表的前沿模型,正在从根本上改变行业对机器人通用智能构建方式的既有假设。
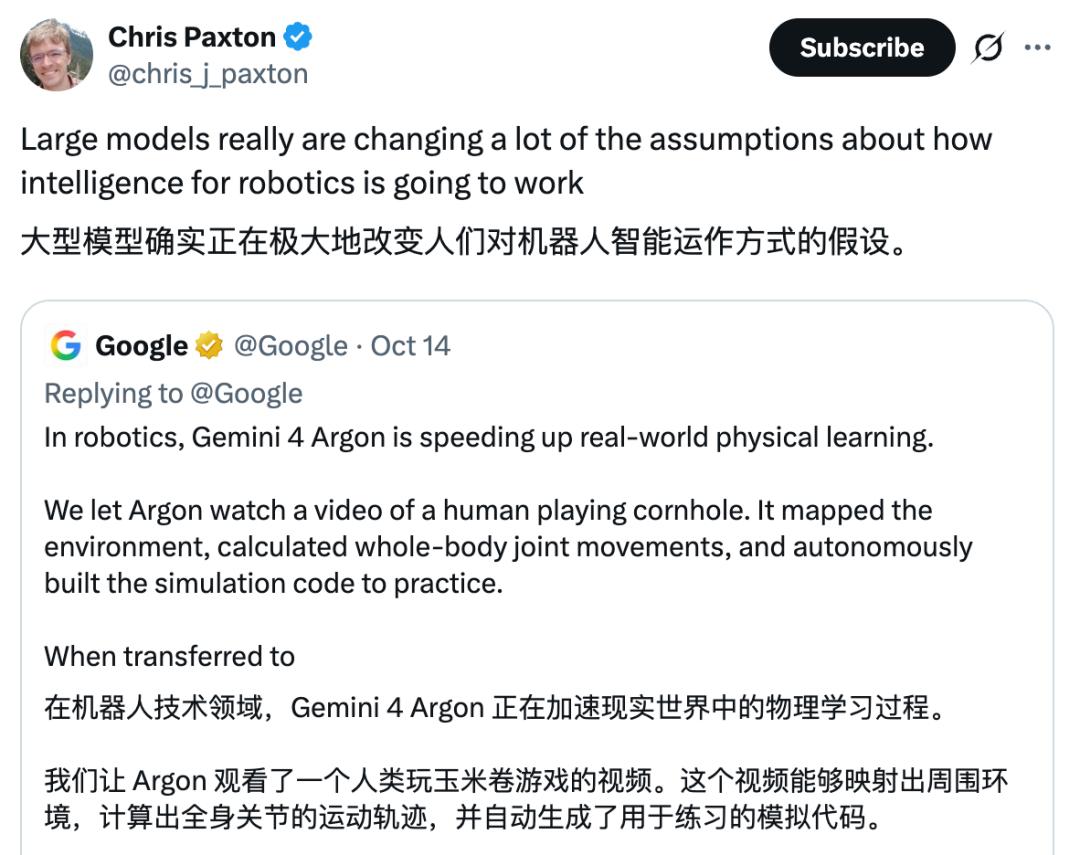
当通用机器人的迭代不再依赖庞大的人工工程堆砌,而是交由底座模型的算力与物理认知来驱动时,物理智能(Physical AGI)的自我改进飞轮,才算真正开始转动。
资料链接:
https://x.com/GoogleDeepMind/status/2110078384617464201
https://developers.googleblog.com/gemini-4-argon-for-robotics/https://aitoolsreview.co.uk/insights/gemini-4-argon-launch
https://artificialanalysis.ai/evaluations/omniscience#aa-omniscience-hallucination-rate
