

 搜索


英伟达等绝大多数芯片设计公司都是把一块大硅片做好线路后,切成小芯片,小芯片再互联起来做AI加速器,避免因为制造瑕疵而报废整块硅片,而有一家公司却“头铁”地偏偏不走这条路。
它直接把整块硅片当成一个芯片,大小如同21.5cm x 21.5cm的正方形果盘(面积与12寸晶圆所能截取的最大矩形面积相近),塞进了4万亿个晶体管和90万个核心,那就是“Cerebras”。
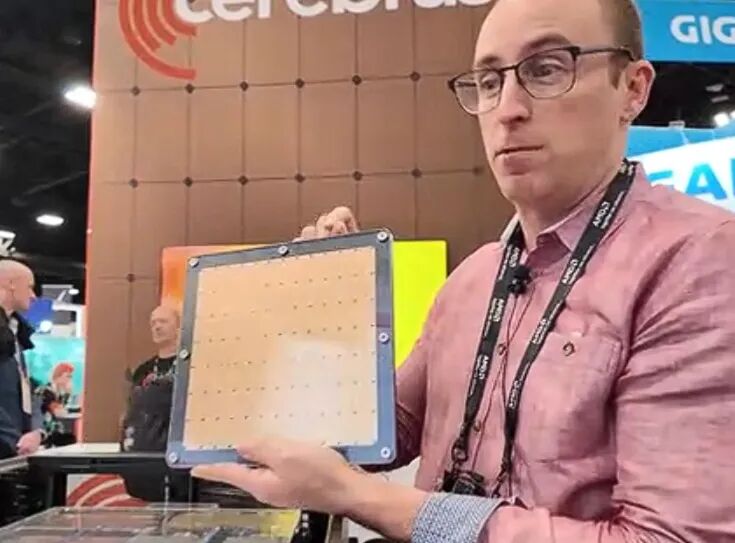
GPU 推理瓶颈是“内存墙”。英伟达绞尽脑汁绕着走,Cerebras则用晶圆级芯片把墙拆掉,而它的护城河主要在台积电之外的设计、容错和封装环节。
本文主要围绕Cerebras的WSE(晶圆级引擎)产品是什么、能解决GPU什么问题、以及WSE是如何制造以及难点在哪。在下篇中将主要对Cerebras公司的经营表现以及未来展望展开。
以下是详细分析
一、Cerebras做什么?
Cerebras的核心是WSE(晶圆级引擎,Wafer Scale Engine),这个命名是区别于常规芯片都是Die级别,而非晶圆Wafer。
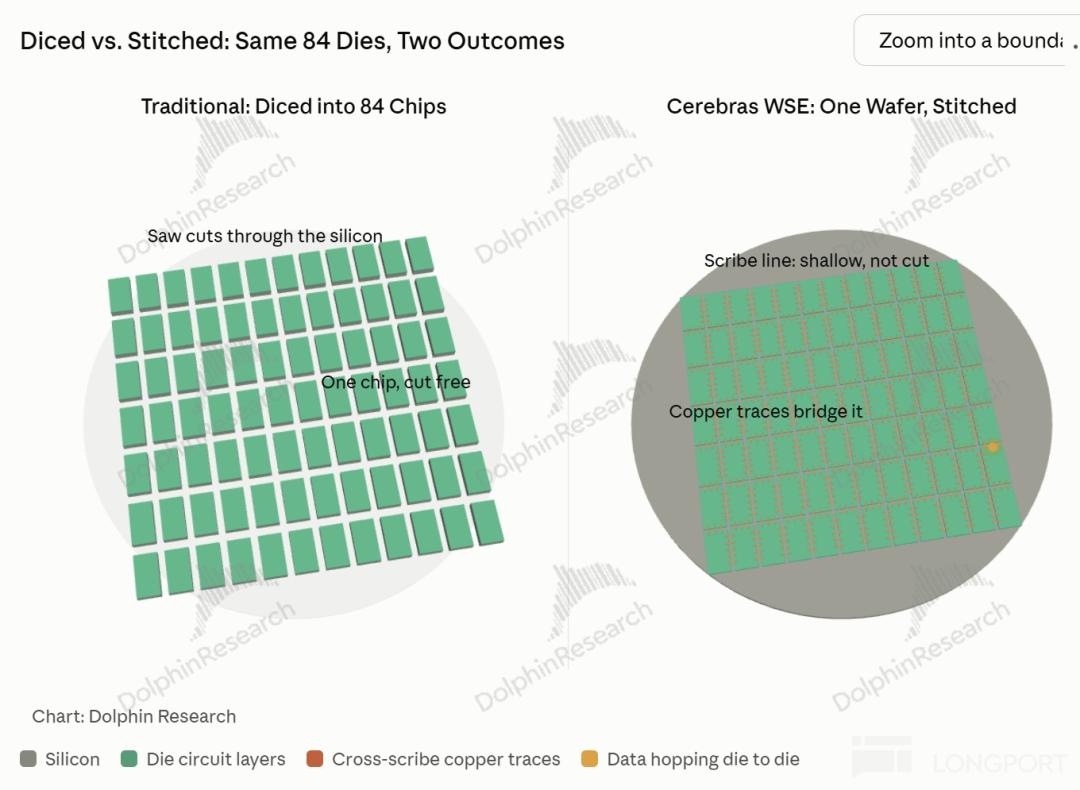
同行 常规是把一张晶圆切成几十上百颗一张邮票大小(800mm²)裸片,再用高速互连拼回去、当成一个大加速器用。
Cerebras的逻辑是:既然最后还要拼回去,为什么要先切?于是把全部、各类计算都刻在一整片晶圆上。
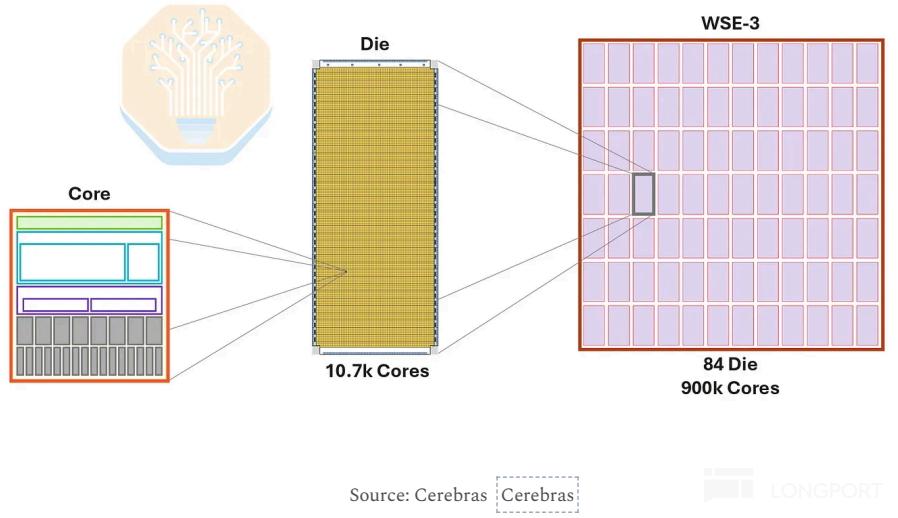
Cerebras将整片晶圆划分成12列x7行的84个完全相同的网格(die),其中这84个不是独立的芯片,在互为邻居的片之间是互联的,84块构成了“一整个芯片”。
在每个die中有1.07万个激活核心core,其中每个核心仅0.05平方毫米。那么一个晶圆(芯片),就对应有90万个激活核心(实际有97万个左右物理核心,结合良率约有7%的设计冗余)。
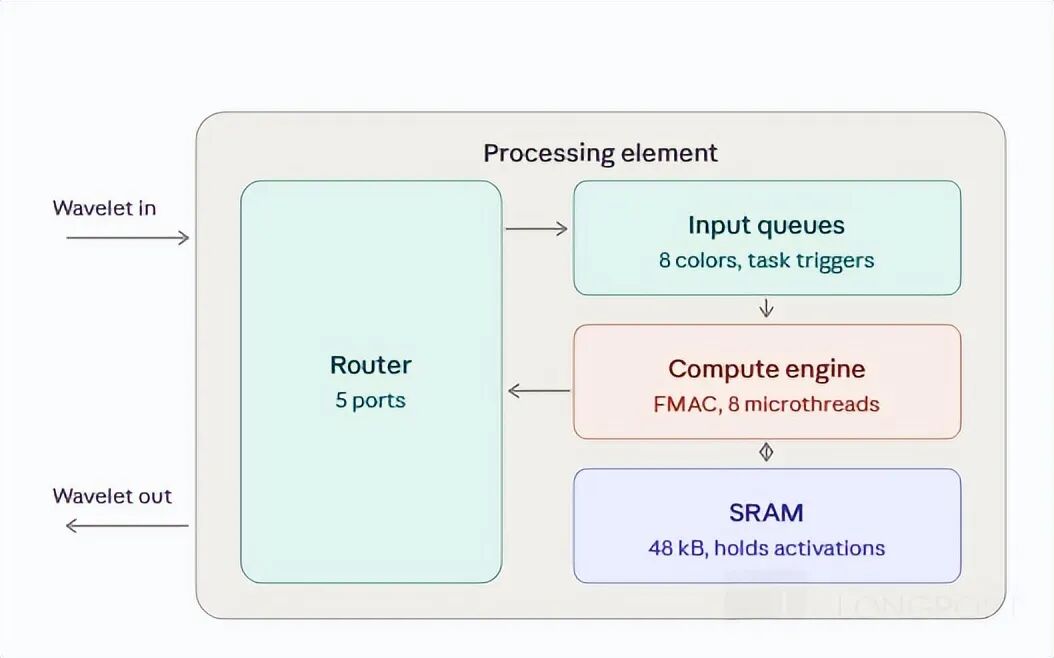
具体来看,在单个核心之中主要塞了三个东西:一个路由器、一个计算引擎和48KB的SRAM(单晶圆97万个核心大致对应44GB的SRAM)。面积大约是对半分,一半给逻辑,一半给存储。
这种走果盘大小芯片模式的WSE路线,目前只有Cerebras一家,并且因为WSE单核的面积仅为0.05平方毫米(英伟达、苹果的单元面积在3平方毫米左右),尺寸标准只此一家。
WSE单核内的计算核心、路由器、SRAM组合架构都是由Cerebras自研的, 但SRAM上,不同于HBM芯片厂的外采,bit cell设计和代工是由台积电来完成,包含在晶圆报价中。
在实际的工作中,GPU和WSE(Cerebras)的区别主要在于:
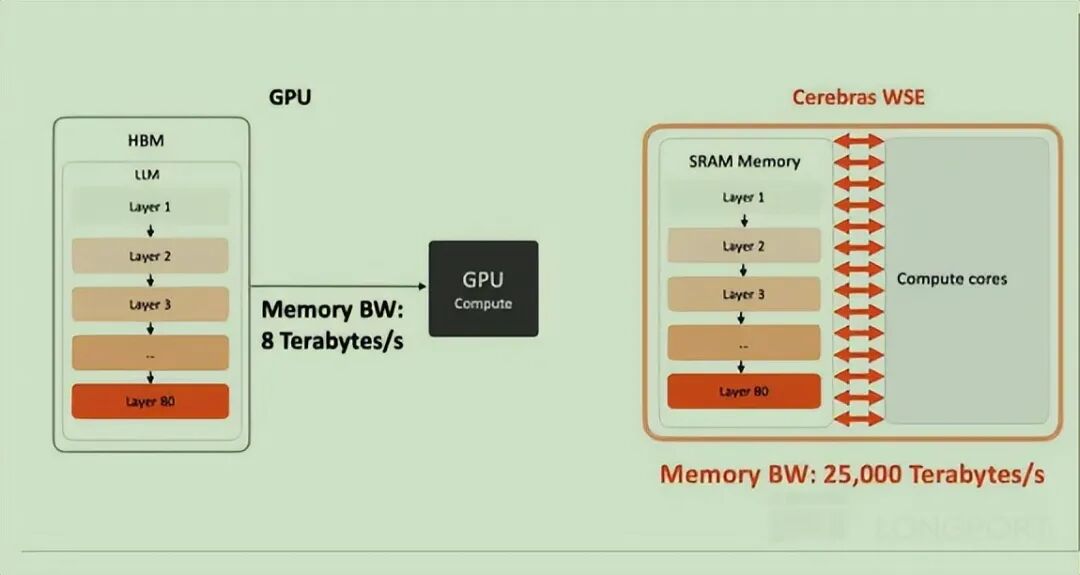
1)GPU是一座图书馆。全套百科全书(权重)放在书库里(HBM),上百个读者(SM,核心计算单元)坐在阅览室。每要写一个字,所有读者都得把整套书完整翻一遍。书库到阅览室只有一条走廊,每秒能过8TB的书;
2)WSE(Cerebras)没有选择建图书馆。它雇了90万个人(核心),每人背下整套书里的一小段。没有书库,没有走廊,也没人需要跑腿。要写一个字的时候,只要把题目念一遍,每个人立刻从记忆里报出自己那一段的答案,汇总一下就完了。
在WSE的情况中,单个核心中的三个部件作用分别是:
①SRAM:主要部分是用来存放权重(背下的一页书),其中一小部分是用来放激活值、KV cache等(草稿纸);
②计算单元:主要在一个数(激活值)送过来的时候,它负责乘一次、加一次;没有数传过来,就坐着不动、不耗电;
③路由器:是用来传题目和收答案的。主要工作是“把题目念给所有人”、“把大家的答案收回来汇总”、“把答案送去下一站”。
基于WSE构建方式不同,能克服GPU最主要面临的问题就是缩短了运输时间,解决“内存墙”。
这是因为GPU的权重在HBM,每个Token都要完整“搬一次”(B200/B300带宽8TB/s)。而WSE直接将权重搬进了SRAM,就在计算单元旁边。
二、GPU针对“内存墙”的努力
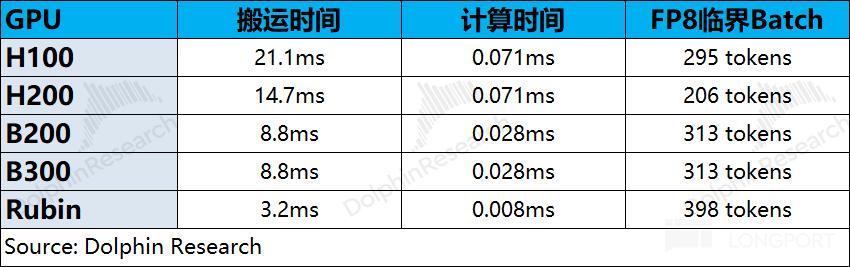
HBM的搬运时间远远大于GPU的计算时间。如果以Llama 70B 模型(FP8)为例,参考B300的情况,HBM的搬运时间约为8.8ms,而GPU计算所用的时间仅为0.028ms,相对搬运的时间不到0.5%。
这意味着99.5%的时间都在等权重从HBM搬过来,导致了GPU算力的闲置,这也是推理场景主要瓶颈。
注:HBM搬运时间=70B参数x单参数占用1B空间/8TB/s带宽=8.8ms;GPU计算时间=2次运算x70B参数/5PFLOPS GPU计算速度 =0.028ms。
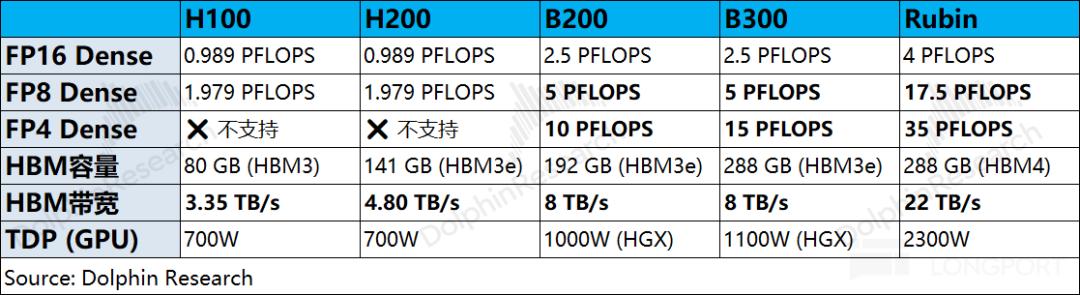
从英伟达各代GPU参数来看,即便下一代Rubin将HBM带宽提升了2.75倍到了22TB/s,但Rubin GPU 17.5PFLOPS的计算速度,提升了3.5倍。GPU的闲置时间仍有99.5%。
对于这么大的算力闲置,目前GPU想到的方案是拼团(Batching)。因为所有用户都要读同一套权重,既然这一趟已经“花时间”去搬运了,顺手把其他人的题目也一起算了(本身99.5%的时间都在发呆)。
拼团的目的在一次搬运任务完成后,让上百个计算任务同时进行,抹平搬运数据所需的时间,这就可以测算出目前理论上的拼团上限值(313->398)。在这个临界点之下,意味着还在“浪费”算力;而高于这个临界点,表明在“浪费”带宽。
“拼团”能提高GPU计算的使用效率(经济性),但在客户端还是会带来一些问题,从而影响用户体验:
1)KV cache会限制拼团上限:虽然权重是共享的,但是每个用户的对话记忆(KV Cache)都是私有的。
在Llama 70B模型里,每个token按照FP8精度,要占用160 KB的空间。一个用户对话如有8K上下文,单用户KV Cache 就要占用1.3GB(即8192x160KB=1.3GB)。
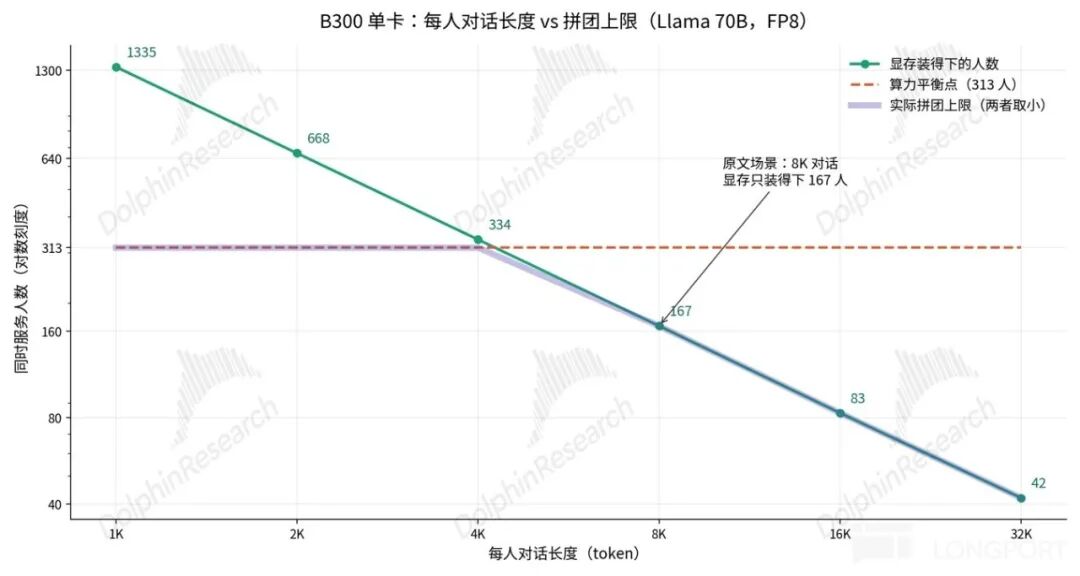
以B300单卡为例:显存288GB,在装完70B FP8模型参数后,HBM还剩217GB空间,一个用户占1.3G的KV Cache,那么一张卡也就同时服务167个8K上下文长度的用户。
此前我们测算的batch临界值在313,这意味着实际拼团上限在167这个位置就到顶了,KV Cache已经把HBM塞满了,限制了拼团的上限;
2)延迟与吞吐的死结:在吞吐(服务商的单位成本)改善的同时,拼团会带来首字延迟(等团凑齐)、字间延迟(抢资源)的情况,这就导致所有GPU推理API都有“快但贵”和“慢但便宜”的两档。
基于“拼团”带来的问题,GPU厂商(英伟达)也在寻求克服的方法:
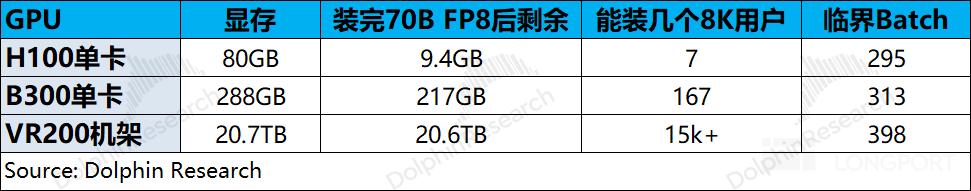
方法一 从单卡迈向机架,扩大整个机架的显存(打破KV Cache的天花板):从英伟达的H100->B300->VR200机架来看,机架级显存方案能克服KV Cache上限的困扰,从而优化“拼团”的效果。
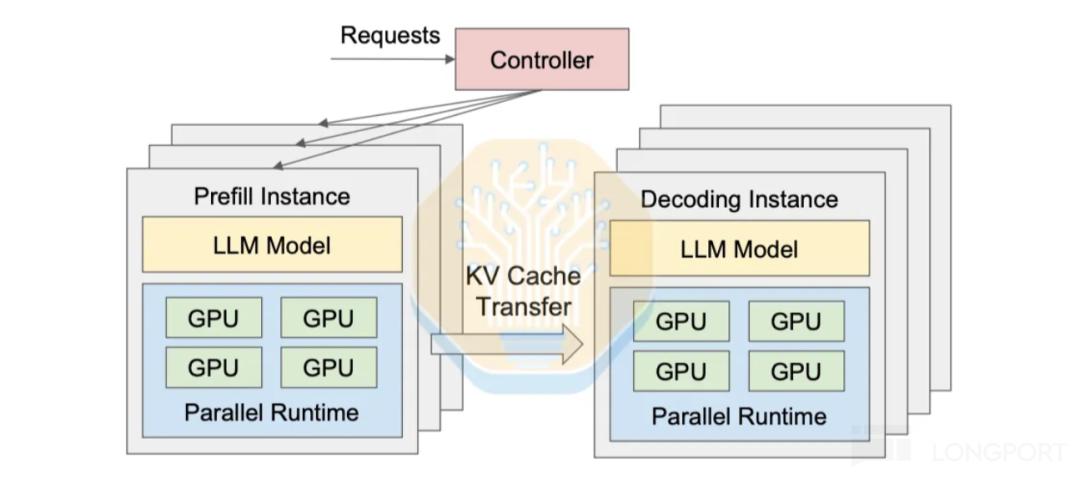
方法二 系统级分解——解耦推理(Disaggregated Inference):把Prefill(预填充,生成KV Cache)和Decode(解码,消费KV Cache)拆成两套独立的GPU集群,中间由KV Cache池连接。
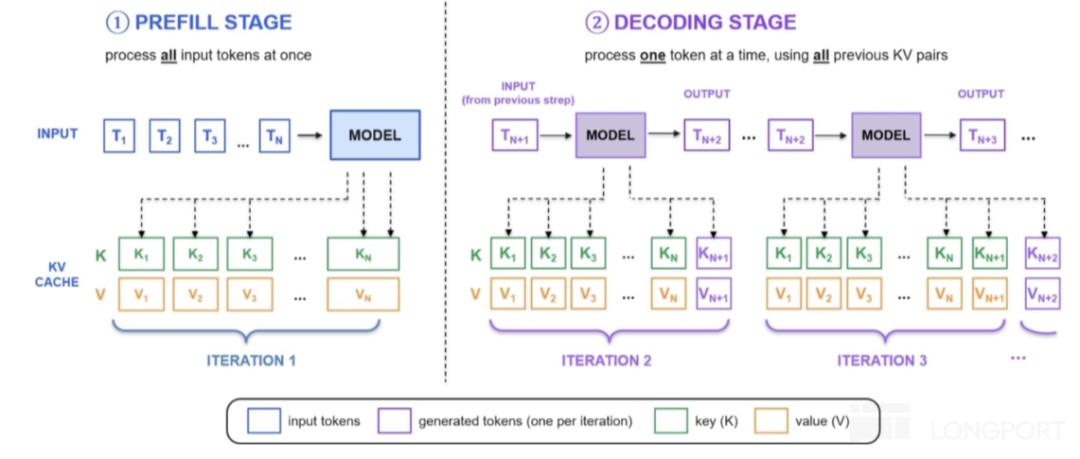
a)预填充阶段Prefill:是处理完整的输入上下文。它是计算密集型的,非常适合GPU 处理;
b)解码阶段Decode:负责预测新token,且受限于内存带宽。解码阶段对延迟非常敏感,因为模型是逐个预测新token的。
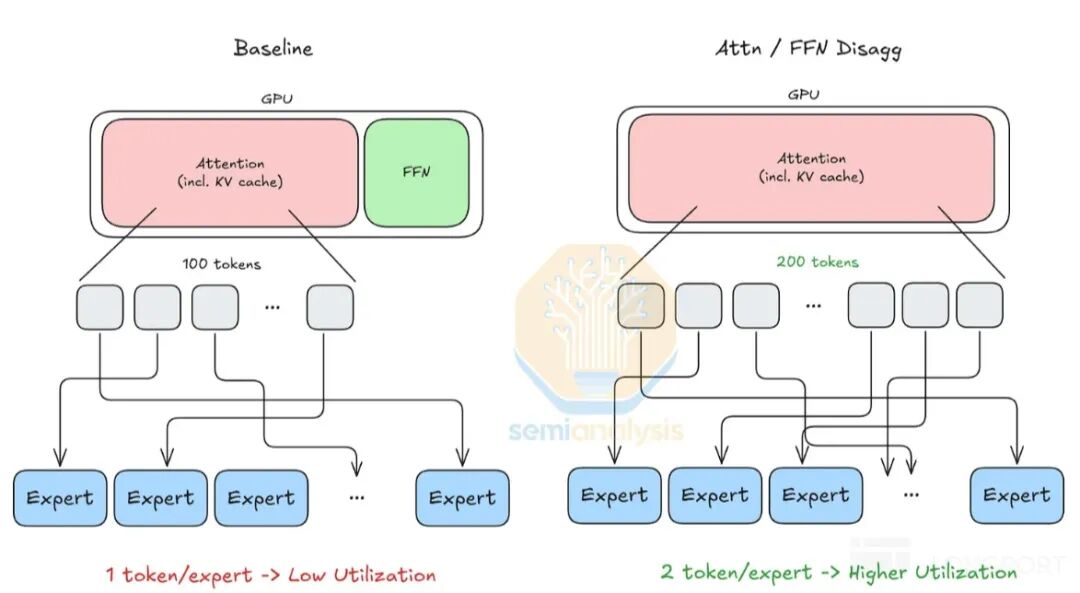
在传统GPU方案中Attention和FFN(前馈网络)是抢着用HBM(争带宽);而英伟达购买Groq之后,新一代架构VR200引入了以Groq的LPU为核心的LPX机架,进一步将Decode拆分成Attention和FFN两部分:
①Attention(回看前文):如果有前文,需读历史上所有token的K和V(=KV Cache)。VR200中的Attention能独享全部HBM带宽,不用和FFN抢带宽;
②FFN(前馈网络,使用自身知识来做计算):无或无需前文只看当前token来算,就使用LPX机架的LPU计算芯,这种芯片上的片上内存SRAM非常大,主要是存FFN权重。由于权重常驻SRAM,不需要从HBM搬运,可以实现极低的延迟计算。
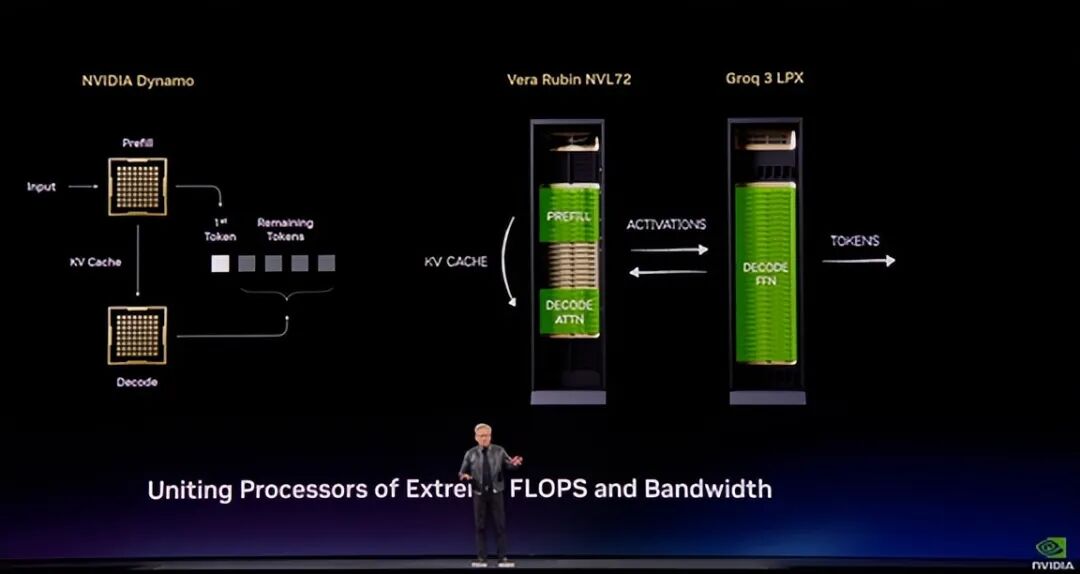
系统级分解将推理阶段拆成了三段:Prefill(计算要求高)->Decode的Attention(KV Cache带宽密集)->Decode的FFN/MoE(参数带宽密集,但不依赖KV)。
针对于不同阶段的关键要素,GPU厂商(英伟达)提供了不同的方案:
a)Prefill环节对算力要求高但对HBM带宽要求低,可以选择英伟达“读题”专用芯片(如Rubin CPX)。
b)Decode 中的Attention需要在意KV Cache的读取速度,仍需要通用GPU(如Rubin、B300);
c)Decode 中的FFN在意权重读取速度,可以采用SRAM预存权重(如LPU、Groq机柜),节省了从HBM输送的时间。
在解耦推理后,相对理想的状态是GPU仅执行Attention操作,其HBM容量可以完全分配给KV Cache,从而能增加其处理的Token总数,也提高了单个专家平均处理的数量/利用率。
在英伟达从H100->B200/B300->VR200 NVL72的变化中:从H100到B200/B300,主要是在算力的提升,结构上没有变动,这主要有助于Prefill阶段;而从B200/300->VR200的改变更大,直接从结构上将推理拆成了三段。
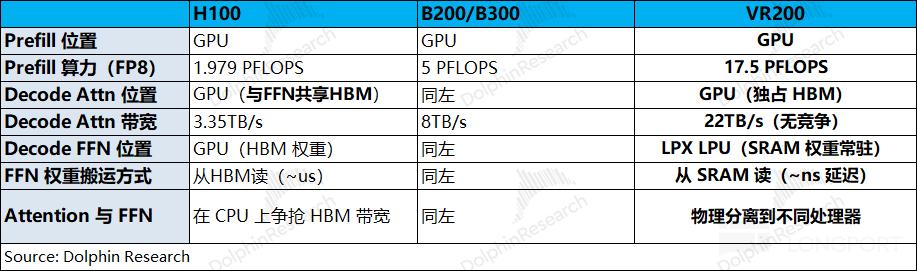
其中,LPU的片上SRAM放模型FFN权重参数。但KV Cache的读取仍在HBM,“单次读取的延迟时间”没变,主要是减少搬运量。
综合英伟达的VR200+LPU的方案,相对更适合于“长上下文+高交互+大MoE”的场景(
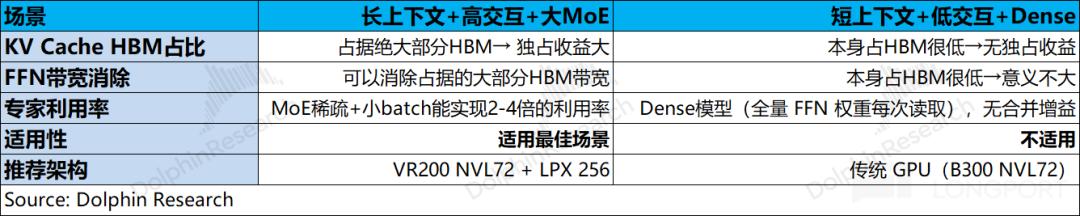
注:短上下文是指短对话(几K token);超大Hidden Dim(超大隐藏维度)是指模型每一层的数据宽度很大,32k+的超大模型每层FFN达到11.3GB
三、Cerebras的WSE是怎么造的呢?
GPU厂商(英伟达)选择解耦推理并引入LPU,能一定程度缓解HBM拥挤的问题。由于LPU只承接了权重部分,KV Cache依然存在HBM,还是会受到HBM带宽(22TB/s)的影响。
不同的是,在Cerebras WSE方案里,KV Cache也直接存取在片上SRAM,片上带宽(21PB/s),读取延迟不到1ns(对比GPU方案0.1-1us),更适用于低延迟、愿意为速度买单的客户。
由于WSE与GPU方案不同,制造过程中也有着很大的不同。Cerebras的晶圆级芯片(WSE)是半导体工程史上最具颠覆性的设计之一。传统GPU一般采用的是“晶圆切割成小芯片(Die)再封装”,而WSE采用的是一整块晶圆能切出来的最大正方形就是一个大硅片的方案。
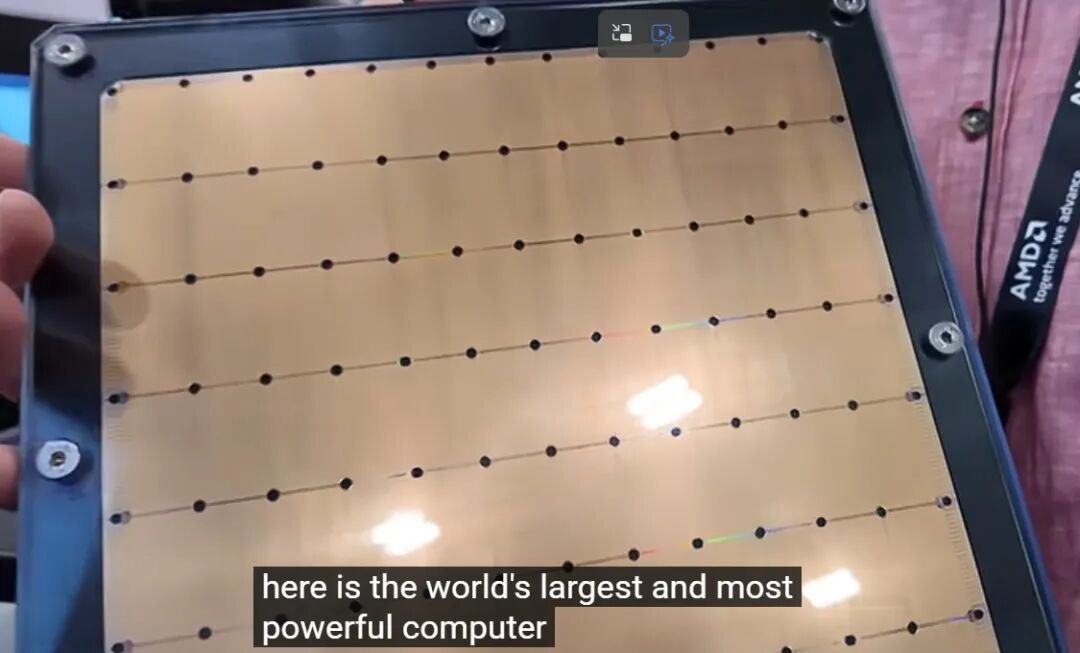
从上图来看,WSE只是对单个直径300mm的晶圆切割出21.5cmx21.5cm的最大正方形,而内部并未切割,采用“光刻视场缝合(Reticle Stitching)”技术。
这块硅片是4.6万mm²,但光刻机曝光有面积上限——单次最大曝光面积约26mm×33mm=858mm²,称为一个视场/Reticle)。
一台光刻机要在晶圆上重复曝光84次,才能打满这块正方形区域,这也对应着WSE的84个Die。
传统做法中,这84个曝光区域之间留有物理划片槽,等待后续切割刀切开。而WSE的做法是:物理划片槽依然存在,但在制造芯片顶层金属线(Top Metal Layers)时,利用特殊的掩膜版,跨越划片槽绘制出微米级的铜走线(作用只是起到纯粹的物理连接),从而把这84个原本独立的网格(Die)直接在硅片内部“缝合”连接成一条高带宽的二维网格,这也就是上图中看到的线。
WSE与传统芯片明显不同,那么Cerebras具体是如何生产的呢?
它需经历“硅片->版图设计及布线->前道工艺(光刻)->中道测试与容错->后道封装/组装->系统级集成”的过程,这与传统晶圆/芯片的大体流程是基本一样的,区别点在于部分环节的操作。
环节1:硅片制造(与常规完全相同)
WSE也是从标准的12英寸(300mm)高纯度硅片起步,这一段的流程与所有芯片一致。从冶炼高纯度石英砂(二氧化硅)开始,经过提纯、拉单晶、切割、抛光和清洗,最终得到晶圆。
环节2:版图设计与布局走线(WSE特有)
常规芯片通常是芯片设计厂用EDA软件设计版图后,交给代工厂做掩膜版,而WSE的单核微架构太特殊,是Cerebras自己主导。
芯片上的“布局走线”不只是物理版图,还包含编译器在运行时的逻辑布局——芯片走计算任务时,84个计算区块中,要绕过有缺陷的区块,这是WSE容错机制的关键支撑。
在这个环节中,主要涉及以下方面:
①单核微架构:设计一个38,000µm²的核。48KB SRAM(8个6KB bank,每bank 32-bit宽)+计算引擎(SIMD ALU、8个微线程上下文)+5端口路由器。自研ISA(指令集架构),不是ARM也不是RISC-V。
②核阵列版图复制:把单核版图在reticle(光刻视场)范围内阵列复制。reticle(光刻视场)的物理上限858mm²(26mm×33mm单次曝光),Cerebras的一个计算区块约550mm²,容纳约11,548个核。
③冗余与绕行逻辑设计:在版图里预埋冗余计算核、冗余路由、区块时效时的绕行机制。这是设计阶段就付掉的成本,不随台积电的缺陷密度波动。
④划片道走线设计:跨die的短线图案。这需要台积电专门提供的划片道设计规则,这不在设计厂给代工厂的施工说明书(PDK)里。
⑤设计图交付:用外购的传统EDA工具做综合、布局布线、DRC/LVS。唯一公开披露的外购IP是Synopsys DesignWare的片上传感与监测模块(SLM),主要是在4.6 万mm²的这个大硅片上分布温度、电压、工艺偏差传感器。
环节3:前道工艺(光刻——WSE的技术分叉点)
参考半导体前道标准流程(清洗→氧化/扩散→沉积→光刻→离子注入→CMP→金属化),WSE同样经历了这些环节。这部分和跑一颗普通5nm芯片没有任何区别,WSE是用步进重复曝光把同一张掩模版图案重复曝光84次(550mm²的die)。
注:步进重复曝光是光刻机的一种工作方式。掩模版上的图案,通过投影物镜缩小后曝在晶圆的某个位置,然后晶圆台移动一步,再曝一次。
目前量产的WSE3是采用台积电5nm工艺,N5一般大约是15层金属。
每一层都是同样的四步循环:①沉积介质层(整片);②光刻打图案(步进84次);③刻蚀出沟槽和通孔(整片);④填铜+CMP磨平(整片)。就这样重复15次,打造15层楼。
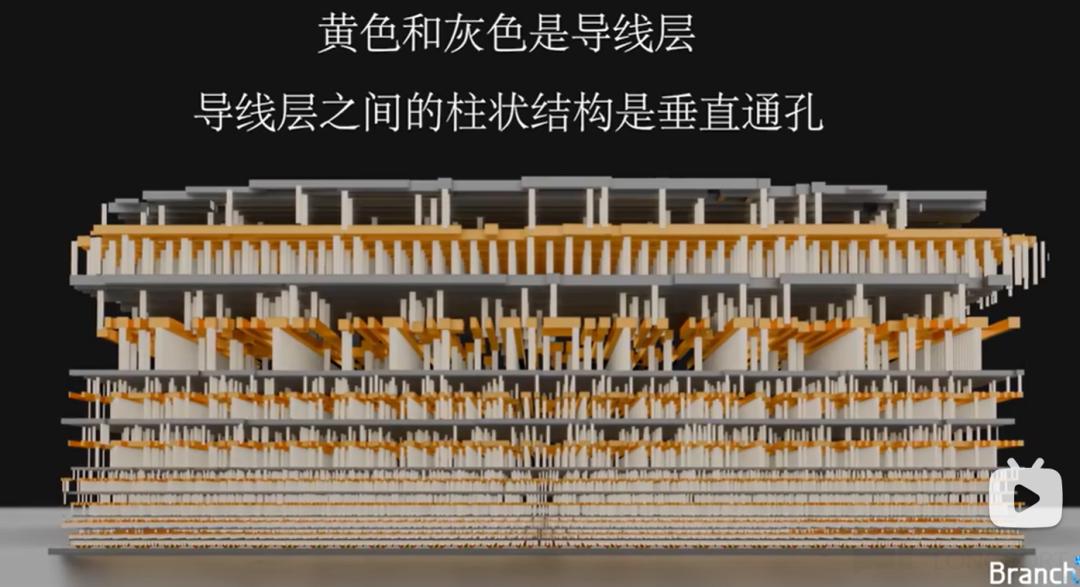
实际上在前面的12层基本是相似的,区别主要在13层及之上,WSE的掩模版变了。
常规芯片的掩模版上,划片道那条带是留给工艺监控结构、套刻标记、测试键的。那是准备被锯掉的地方,画什么都无所谓。
Cerebras的掩模版上,那条带被改成了走线通道。跨越die边界的短金属线,长度不到1mm,这里用到了跨划片线晶圆级互连技术,类似于在高层架天桥。
这是最关键的地方,这里的一根跨界的线:一半画在曝光场的右边缘、一半画在左边缘。即:第 N 次曝光(die本体+右侧半截天桥)->晶圆台移动一步->第N+1次曝光(左侧半截天桥+die本体) ->两个半截在划片道上空对接,连成一根完整的线。
由于要设计跨界的线,所以要替换掩模版。天桥不需要额外的曝光次数,两次曝光的天桥对接是靠晶圆台的步进精度完成。具体的工艺流程与前12层基本相似,区别主要是在掩模版上增加了天桥。
划片道上的铜,和die内部的铜,都是同一次沉积、同一次刻蚀、同一次CMP的产物。 用的也是同样的设备、同样的材料和同样的参数。
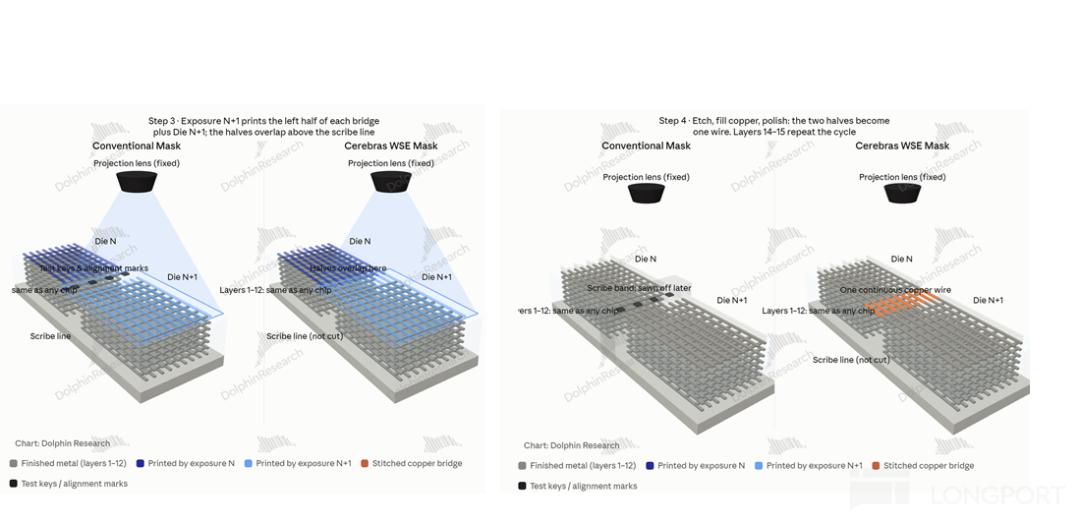
高层做?是因低层的线太细了,纳米级的对接误差会直接断线或短路,良率归零。高层微米级的容差宽松两三个数量级。
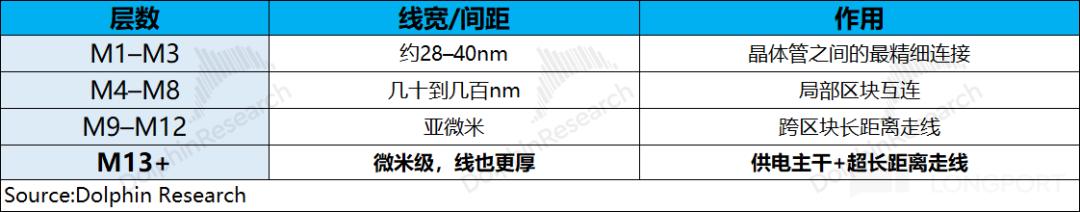
实际上“高层架1层天桥”是理论上够用的,但考虑布线灵活性和冗余,推测大概率会架2–3层。普通晶圆的划片线是切割芯片时的“禁区”;Cerebras在划片线上进行布线,从而将84个die全部连成一个整体。
环节4:中道测试与容错
传统晶圆过程中要在切割前,对晶圆上每颗die做电学测试,坏die需要打墨点或记入电子地图。在沿划片道全部锯开后,把坏的die丢弃掉,好的die送去封装。
WSE测试的目的不是挑出好die,而是摸清整片晶圆上哪些核心坏了、坏在哪。WSE中的84个die被金属线缝成一体,对外的I/O只在整片的边缘。没有任何物理通道去单独访问中间某个核,因而WSE采用的是全片测试。
网格中每个core都自带SRAM(48KB)和路由器,即每个core具备“自己运行测试程序+通过路由器网络把结果传出去”的物理条件——这正是“自测(核自己测自己)”的最小硬件基础。测试下来:
①一个core的路由器坏了:等于路坏了,自己区块的数据报不了,其他区块数据无法经过,等于区域性失联了。这种需识别是单一区块坏了,还是这个区块的数据路径断了。
这需通过冗余路径探测(如从多个方向、多个边缘端口交叉验证)才能判别,因此一开始就对core设计了从东南西北四个方向的冗余路径。
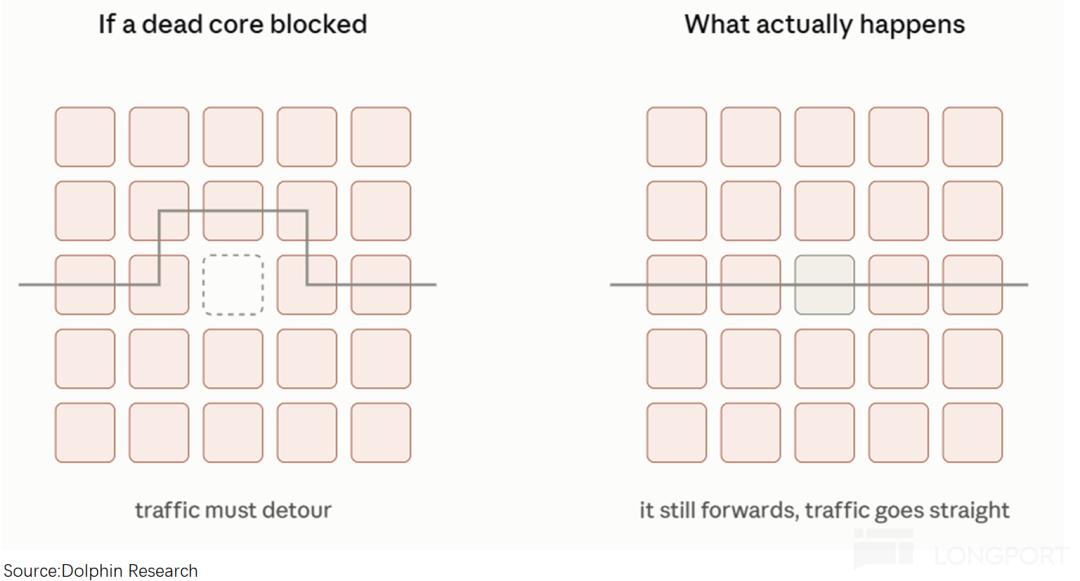
②“坏核”:WSE的Core=计算单元+本地SRAM+路由器,即计算和路由在物理上是分离的部件。路由器活着,计算和存储坏了,这个区块可以继续当纯转发节点。但路由器废掉,无论计算和存储是否可用,这个Core就算坏死了。
环节5:后道封装/组装
在Cerebras的WSE制造中,台积电主要参与了“前道晶圆制造+晶圆级互联(Fab内)”工作,之后封装和整机系统集成(Fab外)基本都是由Cerebras完成。
在前道制造完成后,台积电在晶圆交付前完成了以下关键的中后道处理:跨划片槽金属互连(台积电和Cerebras联合研发)和全晶圆级钝化及凸块(台积电在未切割的整块300mm晶圆表面做全盘钝化保护,并制作高密度的Micro-bumps/C4凸块,用于引出电源和信号触点)。
简而言之,台积电交付的是一张打好了金属凸块、带有跨掩模互连线的300mm硅晶圆。接下来的系统级物理封装,台积电没有参与,全部由Cerebras自研。
这是一块300mm的硅晶圆,775微米厚,没有一个电源接口,没有一条数据通道,没有任何散热方式。Cerebras接下来要做的是,把这个硅晶圆变成一台机器。
首先对直径300mm的硅晶圆沿着215mmx215mm的外框切一刀,把圆片四周的月牙形边角料就是废料,大约浪费35%的面积,得到一个正方形硅片(上文中成品样式)。
接下来的问题,主要是对外数据连接与通电两大难题:面积太大,功率23千瓦(相当于十几台家用电磁炉同时全功率运转)。传统封装下,一通电就把自己烧死了。
面对这个难题,Cerebras设计了四层三明治结构“冷板+晶圆+柔性连接器+PCB”,公司将其称之为“engine block”(引擎缸体),这也是Cerebras的核心技术。
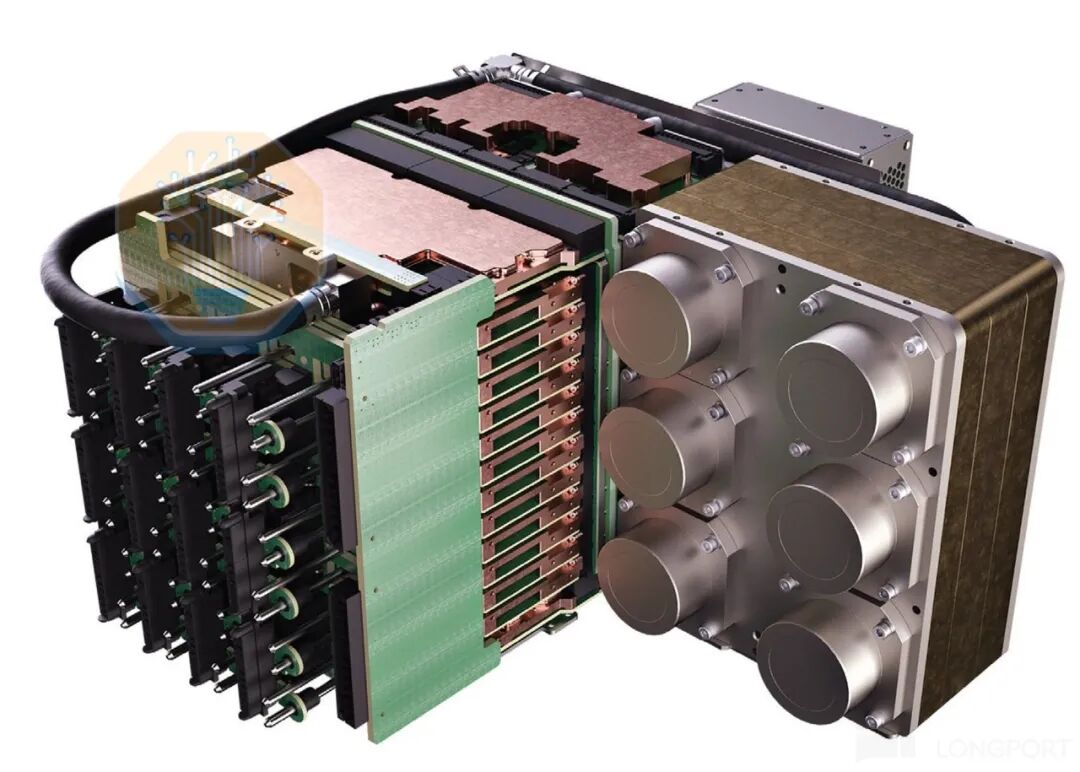
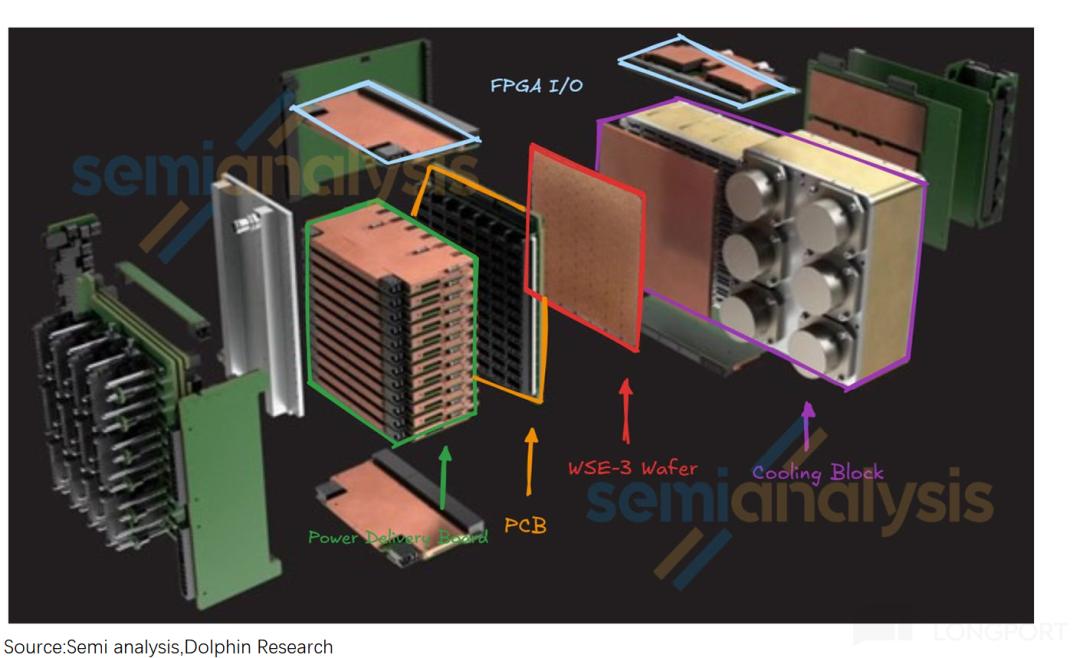
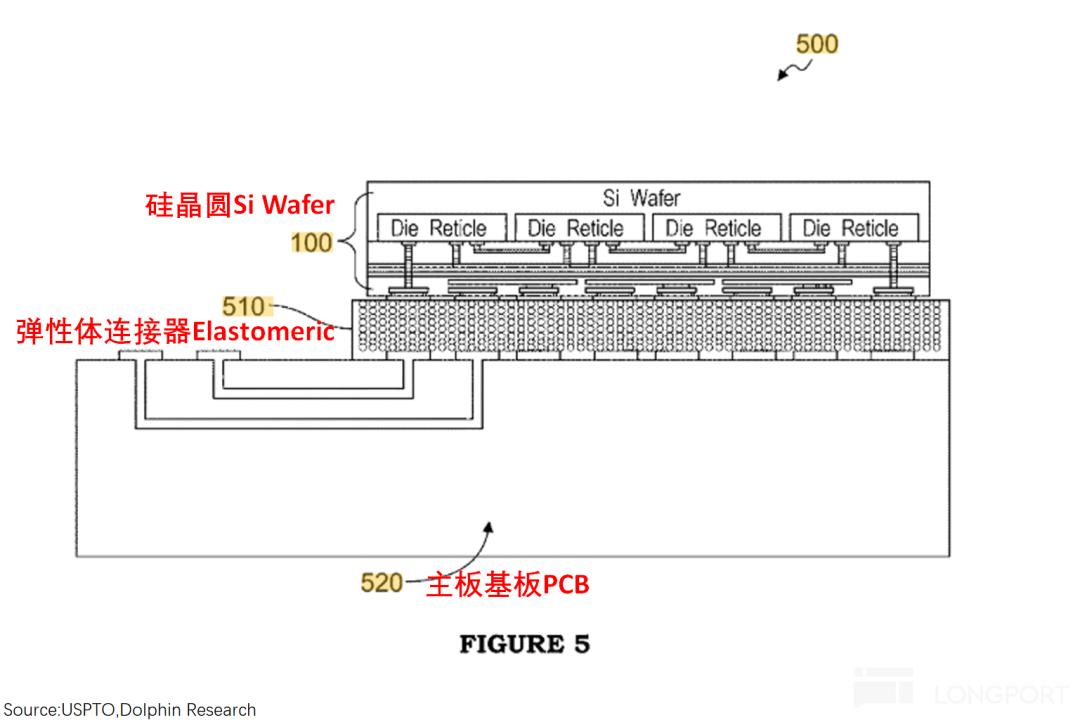
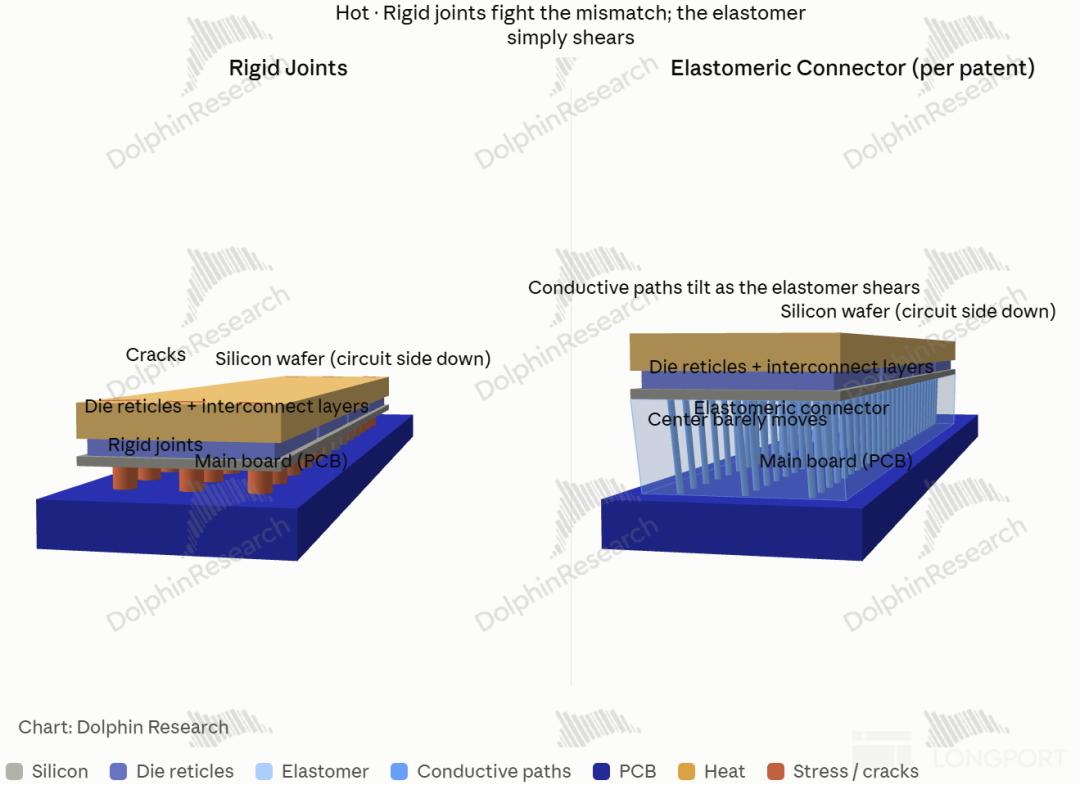
①首先需要将215mm见方的正方形硅片接到PCB电路板上,但传统的焊接方法是无效的,开机后的高温使其撕裂。硅晶圆受热膨胀的程度和下方标准电路板完全不同。如果直接用锡球焊死,只要芯片一发热,膨胀差会像剪刀一样直接把所有焊点全部剪断。
Cerebras设计了一种定制的带微型弹簧/柔性触点的专用连接介质,放在PCB和大硅片之间——由数百万根像“微型弹簧”构成的柔性垫圈,专门用来吸收两侧不同的热膨胀。
当硅片发热变大时,弹簧会向侧向微微弯曲横移;当硅片冷却缩小时,弹簧又恢复原状,用“以柔克刚”的方式化解了足以炸裂芯片的热应力。
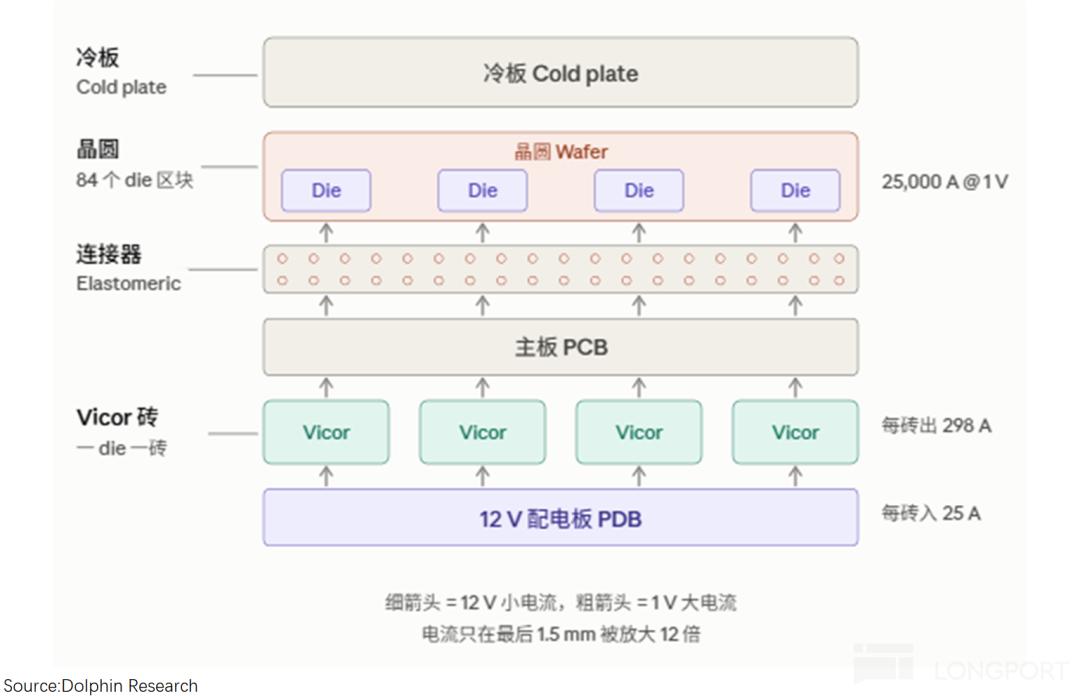
②在给硅片安上电路板后,还需要搭建“摩天大楼式”垂直供电系统(3D Vertical Power Delivery)。
WSE的峰值功耗高达23千瓦(23,000 W),而先进半导体核心工作电压极低,仅为0.8V左右。这需给晶圆注入高达20,000+安培大电流,足以瞬间熔化普通钢缆或焊接重型钢轨。
用传统的边缘供电:a)距离太长,电流需要走过10cm的铜线才能到达晶圆中心,且到了中心电压已衰减到没有了,晶圆中间大部分区域根本分不到电。
为了解决上述难题,Cerebras垂直供电:把整个电源模块(VRM)直接压在了晶圆的正下方,让电流垂直向上直达晶圆背面,输入48V(甚至 54V)直流高压,电流低了,就不会发热过载。再把这48V的电压,用降压板,分成0.8V的小电压,分给84个die。
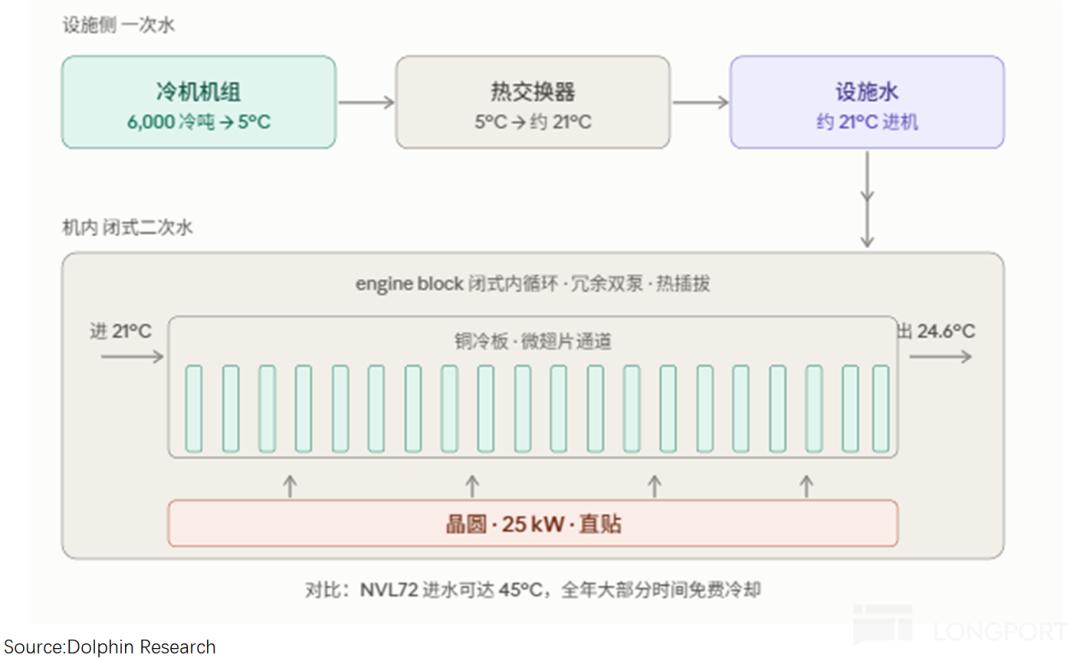
③在完成线路对接和供电搭建之后,还需要为这个23kW“火炉”(相当于十几台全功率运行的电磁炉)安装直贴微通道水冷冷板。
“直贴微通道水冷冷板”就是一片铜冷板——背面机加工出微鳍片通道、正面抛光后靠预载力直接压在晶圆背面,冷却液在通道里流过把20kW+热量带走。
Cerebras的冷板-晶圆接口采用了“抛光滑合+预载力+相对滑动”设计:其中抛光能减少热阻和滑动阻力;预载力(压力)越大,微凸点压扁越多,接触面积更大;相对滑动指的不是粘死,可以像熨斗那样贴着滑动。
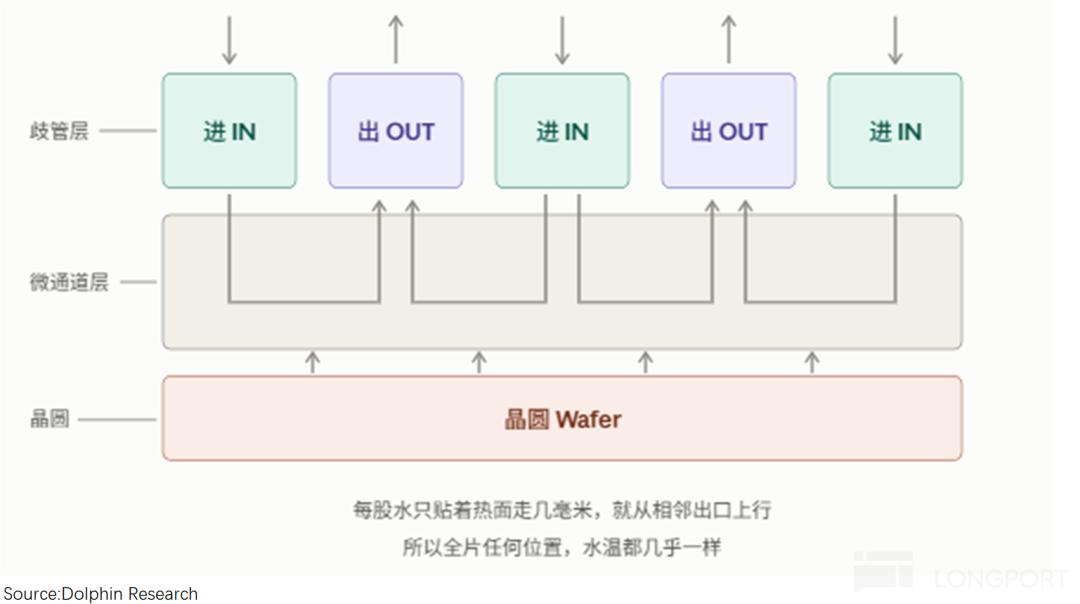
Cerebras彻底放弃了传统单向平流水冷,发明了垂直三维分流歧管技术:就是在冷板内部不是一条长管道,而是被划分成了成百上千个微型冷却单元阵列。冷水通过顶部的歧管,像无数个微型花洒一样,垂直直接喷射到各个局部区域。
在①+②+③基础上,将四层零件(冷板+晶圆+柔性连接器+PCB)组装成一个engine block(引擎缸体),全部的电连接(晶圆-PCB)和热连接(晶圆-冷板)都由压力维持。
因为晶圆、弹性连接器和PCB都很大,正确装配并维持系统压缩,可能需要高达4吨甚至更多的压缩力。在压完之后,再用紧固件把晶圆固定在PCB和热交换器之间,实现长久维持。
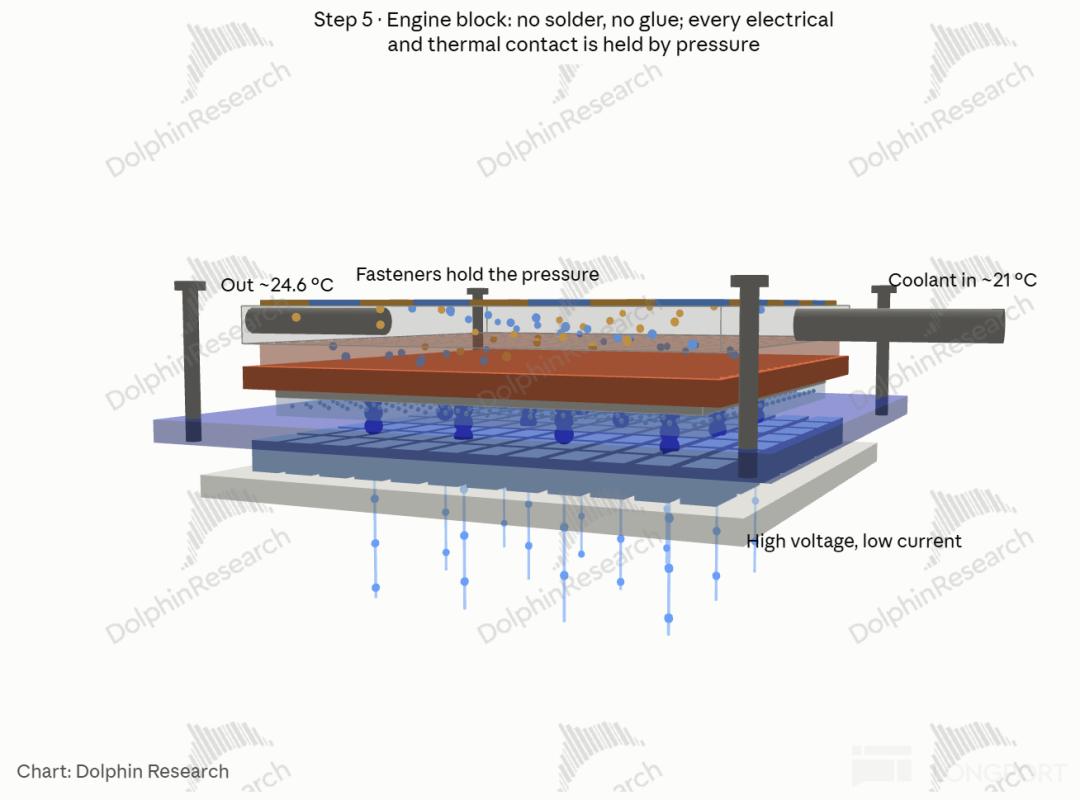
由于被压的对象是215mm×215mm×775µm、重83克的裸硅,任何一处局部压力集中都会把它压裂。所以4吨不是“压下去”那么简单,是要让这4吨在半平方英尺上分布得极其均匀,因而整套装配机器是100%定制的。
从四层堆叠到WSE模组,靠的是“插+压”两步:晶圆先通过弹性体插槽插上 PCB,冷板抛光面再在预载力下压紧晶圆背面——用Cerebras自研的组装工具完成四层夹心压合,接上冷却歧管后模组成型,这是公司的核心技术。
环节6:系统级集成
从WSE模组(engine block引擎缸体)到计算整机,需要装信号接收器、装电、装水冷、装散热出口。全程Cerebras都是内部组装测试。
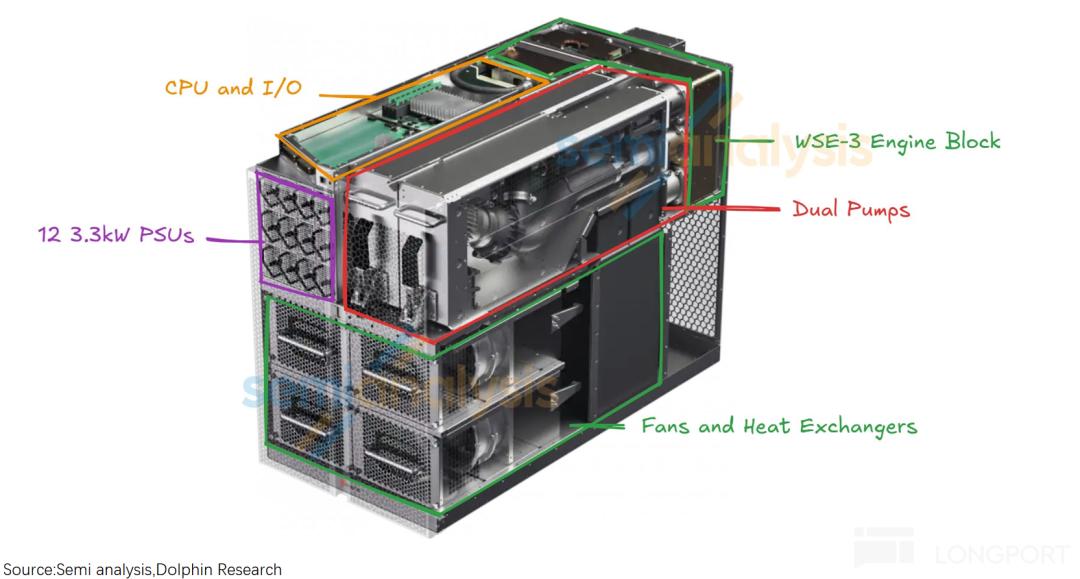
①装信号接收器:在WSE引擎组件的顶部安置着I/O FPGA模块(网卡功能),该模块通过板对板连接器与WSE PCB相连。功能内是传递Cerebras专用I/O信号,并将其转换为用于横向扩展的以太网信号以及PCIe信号;
②装供电和水冷:a)12个3.3kW电源单元+12块PDB,通过盲插式电源连接器接进engine block;b)把engine block的冷板水路接到机箱的黄铜歧管上,并装上了双泵(其中一个备用),泵是冷却系统的“心脏”。
③装散热出口:冷却液在机柜内转圈,但热量必须最终排到室外。冷板吸的热不能永远留在水里,必须通过换热器“交棒”给另一路(设施冷冻水或室外空气),也就是图中的热交换器。
综合上述6大环节就是CS整机的制造全过程。 环节2到环节6基本都有Cerebras参与,尤其是在难度相对较高的版图与布线、中道测试容错和后道封装组装等核心环节基本都是由Cerebras独立完成,台积电主要参与其中的前道光刻环节。
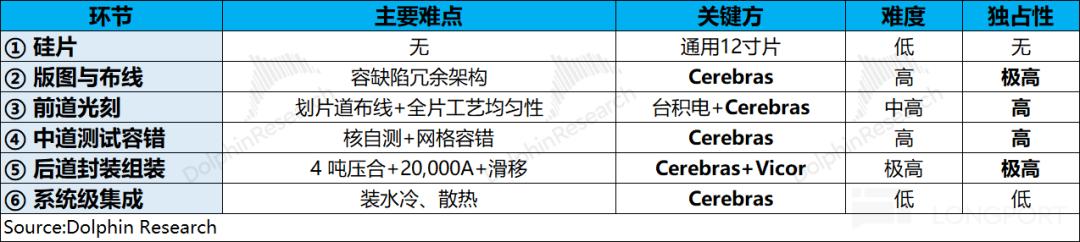
机架级整机的组装测试是由Cerebras内部完成,交付物是一台台“成品机架”。值得注意的是,一台Celebras整机在出厂后,也不能直接使用,还需要做落地配套,需要:
设施评估->机房改造->上架与接管路(水、电、光纤)->接外围系统(主机服务器、Memory X【存权重4TB-2.4PB】、SwarmX【多机广播与规约】)->软件栈部署与模型加载(CSL、Cerebras编译器)->持续运维。
这样看来,CS的设施改造代价是相当高的,但它的目标客户是能“把毫秒级延迟直接换算成收入”的玩家(OpenAI、AWS、高频交易、实时交互)。在这些场景里,CS的21PB/s片上带宽带来的速度优势是GPU给不了的。
