

 搜索


10月25日,熵旋芯智在公众号发文,正式提出了首代MRAM存内计算架构——MITA(MRAM In-Memory Tensor Architecture),并以此为架构基础,提出存算一体处理单元——MPU(MRAM-based Processing Unit)——的定义。
它们的用途,是为AI推理构建更低延迟、更高通量的算力。
一个月前,DoNews与熵旋芯智创始人雷坤进行了深度交流。那时北京正下着大雨,他刚刚参加了在上海举办的AI芯片峰会,并做了有关MRAM存内计算的报告。差不多同一时刻,在杭州的云栖大会上,阿里平头哥发布了AI芯片真武V900,性能是前代M890的三倍,216GB的显存和1200GB/s的片间互联被放到最显眼的位置。
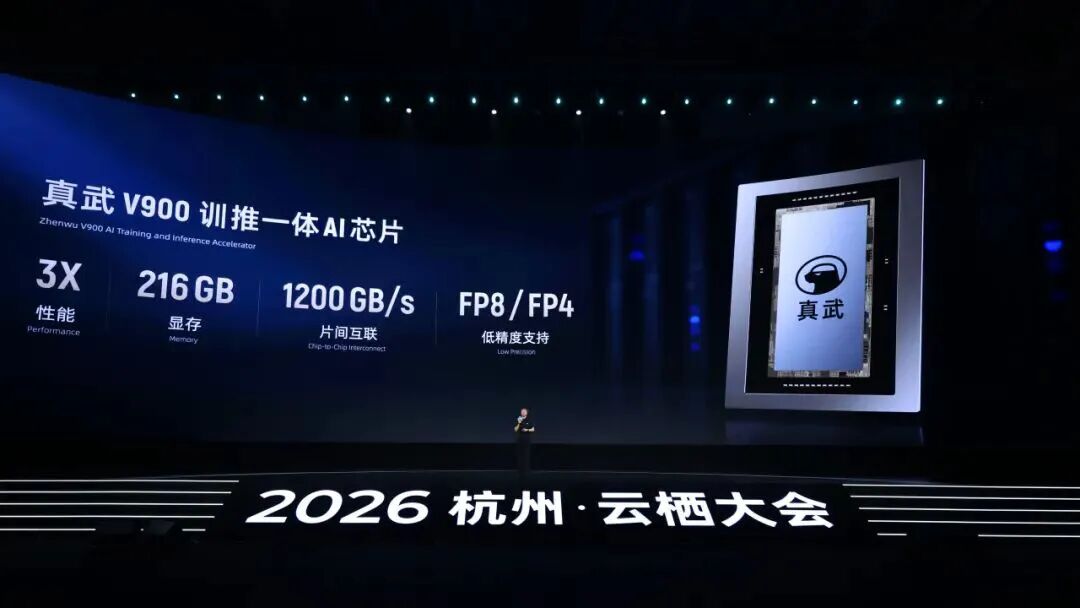
图片来源:阿里云
还有一个热词,在AI芯片峰会和云栖大会上都被反复提及,就是“超节点”,在几天前的华为全联接大会上,超节点集群也被视为AI时代的重要基础设施。
紧迫感,从一场场行业发布会中溢出。而有关这些名词的讨论,在采访的一开始,雷坤就给了一个基调:“大家的目的都是为了解决这样一个事——算力增长很快,但数据跟不上。”
前几年,我们焦虑的是算力的不足,今天中国日均Token消耗量约500万亿,但限制AI发展的瓶颈,正从单纯的算力不足,转向存储容量、数据带宽、数据搬运功耗和整体系统成本等更加复杂的系统级问题。传统AI芯片通常采用“存储与计算分离”的架构,大量模型参数需要在HBM、片上缓存和计算单元之间反复搬运。
在AI推理中,数据在“存”与“算”之间的流转效率,直接决定了芯片的真实吞吐与能效。随着模型规模持续增长,AI芯片需要更高的存储带宽,功耗和硬件成本也不断上升。
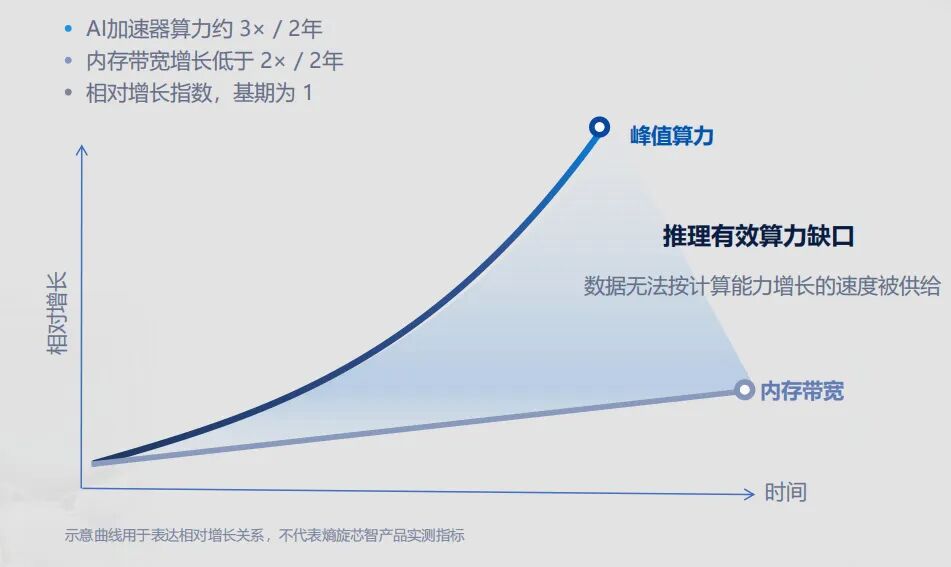
图片来源:熵旋芯智
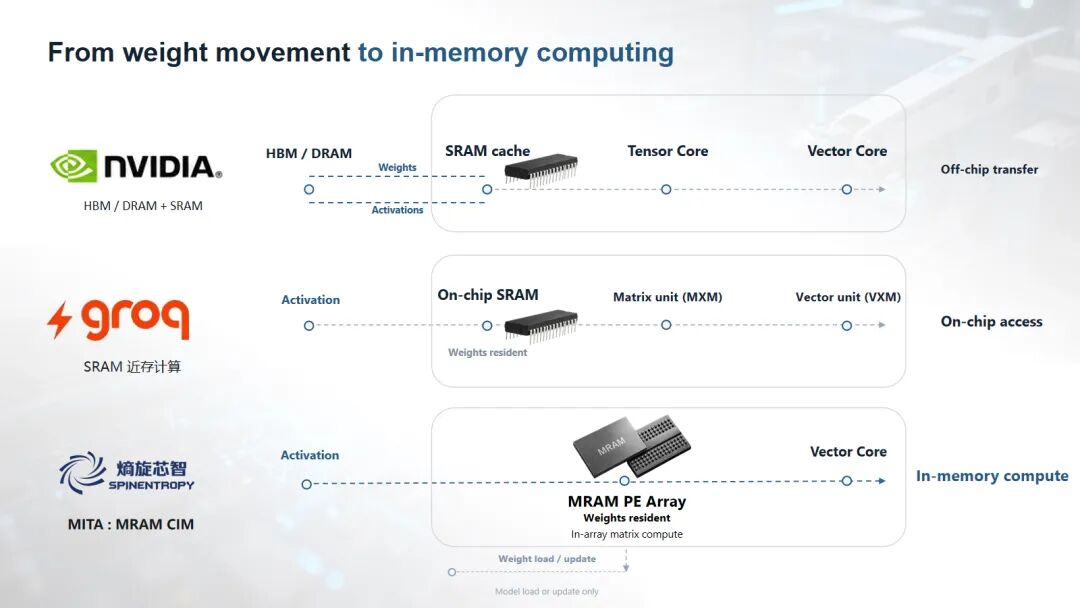
打个比方,GPU就像一个图书馆,第一层是阅览室,二三四层放书(存储)。想看书(计算)你就要跑到楼上一本本去拿,然后拿到一楼的阅览室才能看,看完还要放回去。以NVIDIA GPU为例,数据需经过完整长链路(片外存储→片上存储→计算单元),多层搬运导致延迟和功耗双高,拿书(数据搬运)的时间比你看书花的时间还多。
今天,这个问题已经越来越紧迫了,这一点从内存高企的价格就可略见一斑。
科技公司自然在尝试解决,超节点是一条路径,从AI芯片的源头解决也是一条路径。而熵旋芯智选择的MRAM,就是AI芯片层面一条尚在前沿领域的小路。
01 搬得更快,不如不用搬
目前行业的主流解法,是让数据搬运的速度更快,让数据存的更多。雷坤解释道:“显存增大的目的是为了把模型装下,如果显存比较小就装不下。互联是因为单张卡的显存有限,所以很多时候需要多张卡来装下,无论是华为的超节点还是阿里真武的多卡互联协议,本质上就是这个。但是装下之后,多卡之间是有通信的,所以要通信带宽达到一个可以接受的水平,多卡的收益才是正的。”
按照这个解法来看,显存就非常重要,但这就是雷坤觉得问题的所在。首先,是目前HBM的带宽不够;其次,由于每张卡的存储器都需要把完整权重放一份,就导致了重复存储的浪费;最后,MoE里大量的权重其实是静态的,但放在HBM里却必须refresh。
就算如此,HBM还是因为供应紧张而不断涨价,反过来说,谁能找到降低对高带宽存储依赖的新型计算架构,谁就在下一轮算力竞争中占得先机。
去年12月,AI芯片领域有一件大事,英伟达通过非独家授权协议的方式,获得了Groq芯片技术的使用权,据报道交易额在170亿至200亿美元之间,是英伟达有史以来最大的一笔交易,同时,Groq的创始人乔纳森·罗斯及总裁桑尼·马德拉也加入了英伟达。
如此优厚的条件,自然是因为物有所值。据报道,单颗的Groq3(LP30)LPU芯片集成了500MB片上SRAM(静态随机存取存储器),单芯片的SRAM带宽可达150TB/s,完整的Groq3LPX机架搭载了256颗LPU芯片,能够提供128GB的总SRAM容量,整体带宽高达40PB/s。
这个架构将模型权重直接驻留在片上SRAM中,SRAM替代传统的HBM/DRAM作为推理的核心存储介质,避免了传统GPU依赖HBM的跨芯片数据往返延迟。在测试中,Groq3LPX每秒可处理约3400个Token,比同类平台快约4倍。英伟达则强调Groq3LPX是对GPU的补充,GPU负责训练与通用推理,LPX负责延迟敏感的智能体任务。
“我们的芯片其实就非常类似Groq的芯片,”雷坤说:“我们的做法就是,把权重像Groq那样放在片上,然后就不用等了直接算。”
“之前英伟达没有推出Rubin(全称VeraRubin,是英伟达接替Blackwell架构的下一代AI超级计算平台,专为智能体AI和大规模长上下文推理场景设计),其实这个事有点难解释,”雷坤笑了一下,反问道:“但是英伟达推出了,然后和LPX构建了一个集群,并且已经量产售卖,那这个事对我们来说,解释成本就小很多——你看英伟达都做了,那我们做是不是也很挺合理的?”
这是雷坤对外的宣传口径,但为什么,熵旋芯智没有真的走Groq的路,而是选择了MRAM(磁随机存取存储器)的技术路线?
理论上来说,相比SRAM,MRAM采用更紧凑的存储单元。熵旋芯智方面提供的资料显示,在同等制程下,以bitcell和阵列核心区为口径,可以实现约2到4倍的存储密度优势,STT-MRAMbitcell面积可缩小至SRAM的约三分之一,包含外围电路后的完整存储阵列面积约为同容量SRAM的一半。而且,MRAM具备非易失的物理特性,模型权重完成写入后,无需维持电压即可保存,在大模型推理中能显著降低大容量权重存储带来的静态功耗。
此外,MRAM器件阻态的变异系数(CV)在2%以内,极低的CV使得同一权重状态下的电流分布高度收敛,阵列输出具有更好的统计一致性和可预测性,从根本上减轻了器件离散性对计算精度及ADC读出裕量的要求。低离散性和稳定阻态使MRAM更适合构建大规模、可预测、可校准的模拟存算阵列。
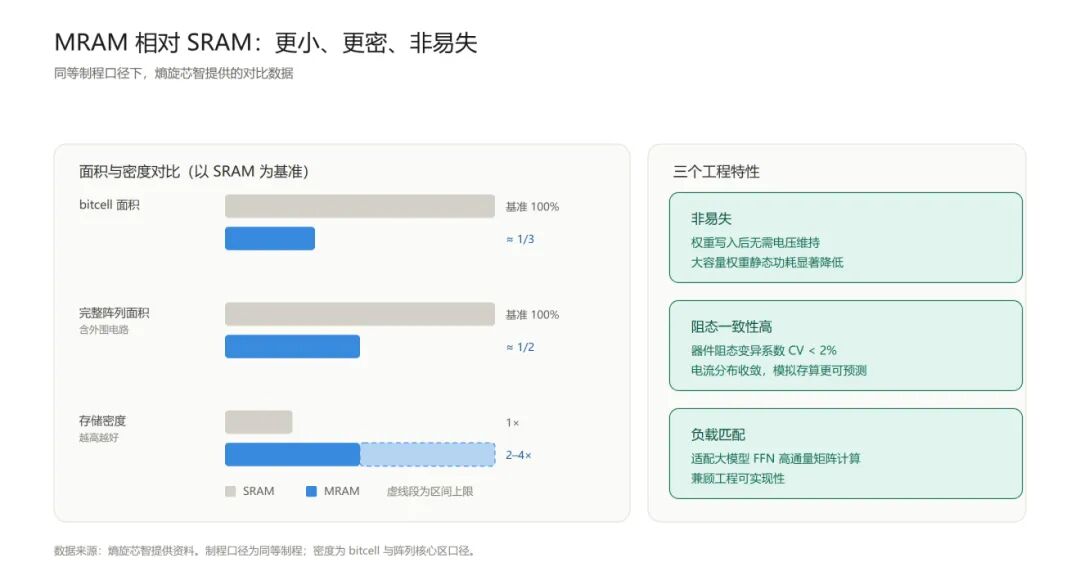
对大模型推理而言,MRAM就成为一条兼顾负载匹配与工程可实现性的平衡路径。将模型参数缓存于MRAM阵列,矩阵运算可在MRAM原位(In memory compute MPU)完成,也可由就近的数字tensor core(Near memory compute MPU)执行。而存内MPU不需要数字tensor core ,能够让更多片上面积用于MRAM阵列与参数缓存;权重存储与矩阵计算在同一位置完成,简化调度层级,通过软硬件协同,理论上存内MPU能够发挥出阵列的最大利用率,将原位计算的物理优势转化为低延迟、高有效吞吐的系统收益。
图片来源:熵旋芯智
02 从学术界到产业界
熵旋芯智注册于2026年2月,而雷坤在2020年进入中科院半导体所硕博连读,2021年在实验室接触到MRAM。
“做的事情是比较Demo级的,很多都是非量产的,来源上也比较杂,其实就是做一些小的,实验室手搓。”雷坤回忆,当他意识到阵列密度、良率、工艺偏差这些不是高校能解决的后,他就萌生了离开实验室的想法。2022年底,他申请去了产业界,2024年回到北京时,他和老师商量搭建了一个4人的小团队,成员是4名清华的实习生——后来其中3名保研到课题组,1名加入了他的公司。
他创业的想法是“算账算出来的”,“这玩意做成一个芯片的话,比传统的SRAM更优”。在产业界,三星早在2019年就实现了28nmFD-SOIeMRAM的商业量产,2026年已经实现14LPU 和 8LPUFinFET先进工艺,并计划在2027年将eMRAM进一步扩展至5nm;台积电方面,22nmeMRAM已经量产、16nmeMRAM完成认证进入客户导入,这些实打实的进展也是他创业的前提。
熵旋芯智专注在芯片设计环节,重点面向云端大模型推理,首款产品定位于面向大模型FFN计算的专用加速芯片,希望在现有GPU或AI加速器体系中承担部分高频、规则化的矩阵计算任务。公司内部按数字前端、数字后端、DFT、模拟前端、模拟后端、软件算法、验证七个部分划分。
1998年出生的雷坤,还是一位年轻人,但创业让他迅速成长。他自述将时间分成三块,最大的一块是拉齐团队认知、跟项目抠细节,第二是融资、宣传、路演这类对外沟通,第三才是除工程之外的团队管理。
“搞数字的不懂模拟,搞模拟的不懂NPU,搞算法的不懂噪音。”团队中,有做模拟的成员做过存储也做过存算,但很少接触Transformer,他要让对方理解“我们在做Transformer的FFN,我需要的是高通量、低错率”,做算法的需要做比特重建,他要让对方理解“数是怎么出来的,多少拍出来,怎么做重建”,而做架构的对SRAM很熟,他要告诉对方MRAM“这边map完几个周期出几个数”。
“大家自己在之前的领域上其实都是很专业的,但是来到我们公司,大家都会涉及一些新领域,因为毕竟我们在MRAM做存算这一块,还是一个先行者。”雷坤说。
相比之下,对外沟通反而顺利得多,目前熵旋芯智第三轮融资接近收尾,雷坤表示资金储备“比较充足,足够我们支撑到量产阶段”,除了资金外,投资方也在帮他们对接产业方,“但这是一个比较中长周期的过程”。在熵旋芯智成立7个月后,2026年9月15日发布的《电子信息制造业发展“十五五”规划》点名了“加快存算一体”和“新型存储技术”,对融资也起到了一定的推动作用。
客户拓展要困难一些,雷坤把这个区别说得很直白:“融资的话,你这个思路大家觉得认,而且也是符合国家战略,OK,那可以投。但客户不是这个样子的,你片子还没回来,大家不可能因为你存算一体的概念去为你这个概念买单,最终还是要落实到PPA(Power、Performance、Area三个维度的缩写)上。”
但这都需要时间。“你后来者做的话,需要多次流片迭代,这个时间成本是省不掉的。”当被问到,目前最大的困难是什么时,雷坤停顿了下,说:“我觉得更多的是时间问题。技术的卡点其实都是工程问题,工程问题就面临着流片周期跟Fab的沟通,以及流片回测等一系列事情,我觉得这些都不是实质性的卡点。我们需要的是时间,以及通过这个时间所需要的资金。”
当下的芯片热和内存热,在这位年轻人看来,是行业在做当下收益高的事情,而他想做的,是往前走一步,做下一个收益更高的事情,也许,是不止200亿美元的一个未来。他计划中的那颗芯片,要等到明年3月才能流片,6月才能回来,在那之前,无论是行业还是这个世界,依旧会充满AI带来的狂热和焦虑。
