
 搜索

2019年3月,英伟达以69亿美元的价格击败英特尔、微软、赛灵思等巨头,将服务器与网络芯片厂商Mellanox收入囊中。
一年半以后,英伟达正式将Mellanox的BlueField“智能网卡”命名为DPU,与CPU、GPU并列为数据中心“第三颗主力芯片”:CPU负责通用计算,GPU负责加速计算,DPU负责数据搬运与处理。
根据黄仁勋公开给出时间表:五年内,全球每个数据中心都会部署DPU。
有了这套宏大叙事,各路芯片企业迅速跟进:英特尔在2021年推出IPU产品线,AMD在2022年收购DPU厂商Pensando,国内的中科驭数、星云智联、云豹智能等DPU创企纷纷拿到大额融资。
就结果来看,黄仁勋的预言只兑现了一部分。
DPU确实在超大规模数据中心普及了,可跑出规模的主要是云厂商的自研芯片:AWS在2017年就规模化上线了Nitro卡、谷歌联合英特尔定制了IPU E2000、微软收购Fungible后推出了Azure Boost DPU......英伟达与AMD的商用DPU长期“叫好不叫座”。
直到2026年的智能体浪潮。
按照AMD的预计,2026年全球约60%的AI算力将用于模型推理。随着长上下文推理和智能体的普及,怎么将庞大的KV Cache和实时记忆快速喂给GPU,直接关系到一座数据中心的实际产出。
当数据搬运与处理成为制约Token产能的关键环节,DPU终于等来了“抢班夺权”的机会。
01.“以存代算”焦虑:为什么CPU成了梗阻?
DPU再次被推上台前,离不开大模型推理的“内存墙”与“经济账”。
在自回归推理过程中,大模型需要保存已经计算过的KV Cache,避免每生成一个新Token,都要重新计算全部上下文。问题在于,模型的上下文窗口越长,需要保存的KV Cache就越多。
2023年到2025年,主流大模型的上下文窗口从128K跃升至百万Token级别。以部分大参数模型为例,单个百万Token序列的KV Cache,就可能占据10GB至100GB的存储空间。
按微软在72-GPU机架上演示的每秒110万Token吞吐量推算,在特定模型配置下,单颗GPU每天对应的KV Cache数据生成量可达92TB。简单做一个换算的话,80GB HBM显存仅够存约1.2分钟,即使是1TB的DRAM,也仅够约16分钟。
智能体进一步加剧了“存储压力”。
智能体执行一次任务,通常涉及模型思考、调用工具、等待结果、再思考、再调用等循环,每一步都在GPU生成和CPU、I/O工具执行之间来回切换,每一轮都要带上系统提示词、工具清单和返回结果。
据美光科技的测算,智能体场景对内存容量的需求可能是普通推理的10至40倍。
既然显存和内存都装不下,行业开始转向:把暂时不活跃的KV Cache卸载到NVMe SSD,需要时再拉回显存。
按照Omdia在2025年统计的介质成本,HBM3E约为每GB 14美元,DDR5约为每GB 8.50美元;按部署后的单位字节成本计算,DRAM约是NVMe SSD的44倍。
vLLM团队进行了一场测试,在2×H100、PD分离的环境下,当并发会话超过128个、CPU内存被填满后,卸载至存储层仍能维持高命中率,使Prefill吞吐量翻倍。
问题恰恰出在“把数据从SSD拉回GPU”。
在传统服务器架构中,CPU长期扮演着数据流转的中枢:GPU要读取外部存储中的数据,通常要经过主机操作系统、文件系统、存储协议栈和内存管理机制,才能最终完成数据搬运。
不同实现路径有所差异,但在常规I/O模式下,元数据查询、协议处理、加解密以及多次内存拷贝,都可能消耗大量CPU资源。对于传统企业应用,开销尚且可以接受。
遇到分秒必争的推理需求,则成了瓶颈:推理并发不断提高,海量KV Cache读写请求会持续冲击CPU和主机I/O系统。原本负责协调数据流转的CPU,反而可能成为拖慢GPU的瓶颈。
早在2020年10月的GTC期间,英伟达就曾示范GPU Direct加速存储的可行性:通过减少CPU参与的数据搬运路径,在特定测试中实现最高2.8倍的带宽提升,将CPU相关开销降低3至5倍。
当“每兆瓦电力能产出多少有效Token”成为AI工厂的核心经营指标,如何让数据绕过CPU参与的冗余处理环节,成了架构师们必须面对的问题,也给了DPU重新上位的机会。
02.巨头纷纷下场,DPU加速“抢班夺权”
试图重构CPU权力边界的玩家中,英伟达可以说是最激进的一个。
2025年10月,英伟达发布了BlueField-4系列,进一步模糊了传统智能网卡与独立计算平台间的界限。
标准BlueField-4 DPU拥有约1260亿颗晶体管,集成64核Grace CPU、最高128GB LPDDR5X内存、PCIe 6.0 x16总线、最高800Gb/s网络接口.....已经很难再用传统的“智能网卡”定义。
在存储节点侧,英伟达还准备了不同形态的方案。
例如OCP 2026展示的STX版本,采用Vera CPU架构;Hot Chips 2026展示的双BlueField-4 Vera方案,将存储访问带宽推向3.2Tb/s,宣称可实现10倍IOPS和5倍能效提升。
背后隐藏着英伟达更大的野心。
过去,DPU主要负责卸载网络、安全、虚拟化和部分存储任务,让CPU从重复劳动中解放出来;现在,英伟达希望DPU进一步接管大模型推理过程中最关键的数据流转环节。
DPU正在从CPU的辅助处理器,向GPU与存储之间的新中枢演进。
为了实现目标,英伟达准备了两套相互配合的方案。
第一套:重新定义存储层级。
传统的数据中心存储架构,大致可以分成四级:G1是GPU内部的HBM显存,速度最快、成本最高;G2是主机DRAM;G3是本地SSD;G4则是容量更大、但访问延迟更高的共享存储。
这套体系在传统计算场景下运行多年,到了大规模智能体推理时代,逐渐暴露出局限。
本地SSD虽然速度快,却难以在不同计算节点之间灵活共享;远端共享存储虽然容量充裕,但访问延迟和网络开销,又可能影响GPU的响应效率;特别是多个智能体共享同一套知识、工具和历史上下文时,如果每个节点都要单独保存、重复加载KV Cache,就会产生大量冗余的数据搬运。
英伟达给出的答案,是在传统存储层级之间插入一个新的G3.5层,也就是上下文内存层(CMX)。
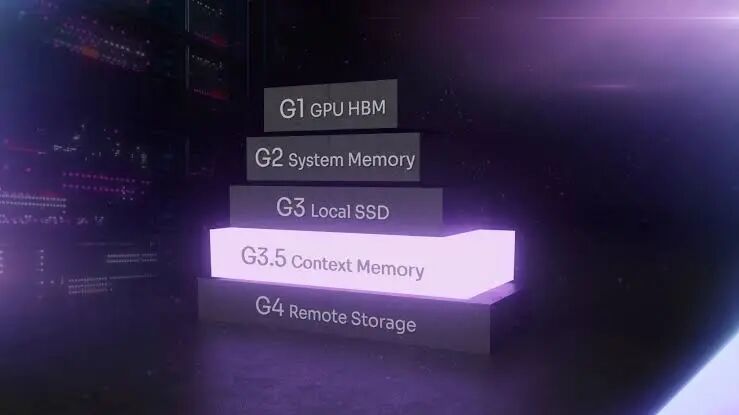
按照英伟达的设计,CMX通过BlueField-4将机柜级闪存资源组织成共享存储池,专门承接大规模推理产生的KV Cache,让GPU不再需要关心某一段上下文究竟存放在哪块SSD、哪个存储节点。
第二套:DOCA软件生态。
熟悉英伟达历史的人,很容易联想到CUDA。英伟达通过CUDA构建起覆盖开发工具、编程框架和应用生态的软件体系,逐渐将硬件性能优势转化为平台竞争力。
类似的思路正在DPU领域重演。
在BlueField-4的架构中,DOCA Memos等软件组件负责连接推理框架与底层存储系统:上层推理引擎决定什么时候需要哪些上下文数据,底层DPU通过硬件加速和软件卸载,处理NVMe-oF、RDMA、加解密、校验以及跨节点数据流转等任务。
CUDA已经帮助英伟达建立了GPU计算生态,DOCA承载着英伟达向数据通道延伸平台能力的野心。一旦越来越多的推理框架和存储厂商围绕DOCA进行深度适配,英伟达就有机会把竞争优势从GPU计算环节,延伸到整个AI数据通道。
有同样想法的,显然不只有英伟达。
在2026年推出的Helios机架级方案中,AMD将EPYC Venice CPU、Pensando Salina DPU和Vulcano 800G网卡组合起来,试图构建基于开放以太网的AI基础设施。
同样是通过DPU和高速网络扩展GPU可访问的存储资源,让大规模KV Cache摆脱本地显存容量的限制。
华为则提供了另一种思路。
在2026年全联接大会上,华为发布了OceanStor M900,进一步将计算、网络与存储控制能力融合进系统架构,并通过UnifiedBus等技术缩短昇腾NPU与SSD之间的数据访问路径,减少传统主机I/O链路中的冗余开销。
三家巨头的技术路线不完全相同,但形成了一个共识:下一代AI基础设施的竞争,数据流转效率将成为与计算性能一样重要的变量。网络、存储乃至上下文调度中的大量高频任务,正在逐渐摆脱CPU,交给DPU或其他专用硬件处理。
沿循这样的逻辑,DPU的“抢班夺权”,本质上是CPU长期掌握的数据通道控制权,向专用处理器转移。
03.替代路线与TCO拷问:非买DPU不可吗?
站在云厂商和大型企业的角度,答案恐怕没有那么简单。至少有三个变量,正在对DPU的商业价值形成挑战。
第一个变量是模型侧的“瘦身”。
KV Cache带来的存储压力,取决于模型架构、上下文长度、并发规模以及缓存数据的组织方式。如果能够通过模型架构创新减少KV Cache的生成量,自然也就不需要投入同等规模的外部存储资源。
第二个变量是CXL内存池化。
不同于将KV Cache卸载到SSD,CXL提供了另一种思路:让多个计算节点灵活访问和共享内存资源。北京大学团队的一项研究显示,在
第三个变量是最现实的TCO账本。
要搭建一套完整的机架级KV Cache存储系统,除了SSD,还可能需要采购DPU、交换机、高速光模块,并承担额外的机柜空间、功耗、软件授权及运维成本,目前仍缺少足够透明、跨平台、同口径的TCO账本。
比技术变量更难回答的,是商业问题。
DPU最早一轮商业化浪潮,已经证明了一件事:技术先进,并不意味着云厂商一定愿意采购。
如果云厂商将KV Cache管理能力整合进下一代自研网卡或专用处理器,DPU作为一种技术架构或许会加速普及,但留给独立商用DPU的市场空间,未必能同步扩大。
与上一轮商业化浪潮不同的是,英伟达已经获得了不少存储厂商的支持。
2025年底到2026年初,多家AI原生存储厂商陆续宣布拥抱BlueField-4:WEKA宣布将下一代NeuralMesh存储软件运行在BlueField-4上;DDN计划结合Infinia与BlueField-4打造下一代平台;VAST Data也将VAST AI OS引入BlueField-4生态,切入CMX相关市场......
也有不少厂商试图从底层协议和存储介质寻找突破口。
譬如华瑞指数云推出的原生分布式KV存储WQS,尝试绕开传统文件系统中的部分冗余I/O路径和内核开销,直接管理NVMe裸盘;针对高并发KV Cache写入可能引发的QLC闪存写放大和尾延迟问题,慧荣推出了面向KV Cache卸载的MonTitan参考设计。
当上下文内存成为新的基础设施需求,究竟由DPU厂商、存储厂商、主控厂商,还是云厂商自己来主导,目前远未形成定局。
英伟达最大的机会窗口,可能还是智能体。
正如黄仁勋对Vera Rubin平台的角色分工:Rubin负责智能体的思考,Vera负责执行,BlueField承担治理任务。
随着企业开始部署大量自主智能体,基础设施正面对新的安全挑战。
一个智能体可能同时访问企业数据库、调用外部工具,并与其他智能体共享上下文。不同租户之间的权限边界、数据隔离和行为审计,都需要更加细粒度的管理。
通过BlueField Astra及DOCA相关安全组件,英伟达正试图将身份权限、数据访问控制和行为审计等能力下沉到基础设施层,利用DPU建立一个独立的安全控制点。缺乏自研能力的AI云厂商,急于补齐安全短板的数据中心,可能直接采购整套基础设施。
04.写在最后
回看DPU过去七年的发展历程,颇有些戏剧性。
英伟达最初收购Mellanox时,DPU承载的是数据中心网络与基础设施卸载的想象空间。一直到AI工厂开始计算每一瓦电力、每一美元投入究竟能创造多少有效Token,数据搬运和记忆调度终于从幕后走向台前,才给了DPU重新证明自己的机会。
遗憾的是,黄仁勋的离职给DPU增加了新的变数。
从收购Mellanox到推动Vera Rubin整机柜架构,黄仁勋一直是英伟达向数据中心基础设施延伸的关键推动者。新管理层能否延续这套长期战略,尤其是如何平衡BlueField的商业回报与DOCA、Dynamo的软件生态扩张,将影响DPU的未来。