
 搜索

掀翻世界的「宕机潮」,终于轮到苹果了。
北京时间 18 日凌晨,由于内部系统更新故障,iCloud、Apple Pay、 App Store、 Apple Music 等核心服务先后出现大面积中断。
而最近一周,类似的「翻车」事故简直数不胜数:
11 月 13 日凌晨, Outlook、Microsoft 365、Teams、Copilot 等微软服务先后宕机,故障持续 23 小时 50 分钟,波及 74 个国家和地区 ;
11 月 13 日,一个故障路由器发出的海量请求引发美国联邦航空管理局(FAA)通信网络过载,全美航班停飞近 5 小时 ;
11 月 16 日,摩根大通内部软件 bug,致使多家银行交易处理速度下降
……
巨头们排着队轮流崩溃,但在这波密集的宕机潮中, 动静最大、 最显眼的一家,依然得数微软。
作为维系无数政企部门的基础设施,前几天微软服务的超长时间宕机,导致许多机构被迫回归古法办公时代,靠着电话、蓝牙和纸质文件苦苦支撑;当然,也有很多打工人饱含着对工作的热爱泡起咖啡玩起手机,享受来之不易的合法摸鱼时间。
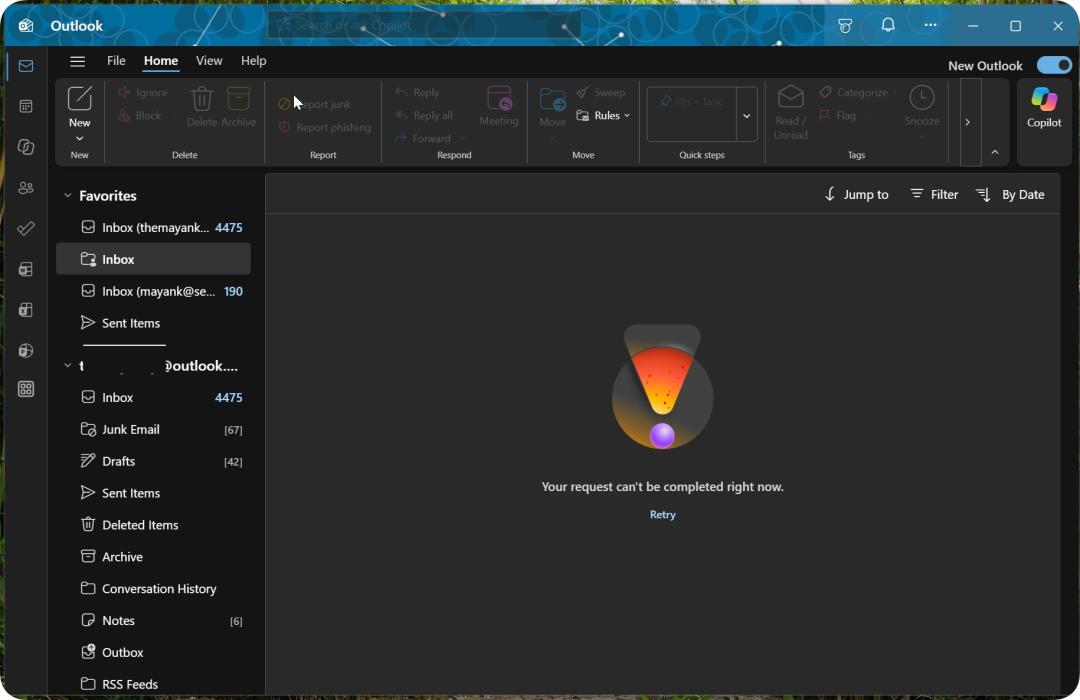
第三方机构估计,停摆期间造成的生产力损失高达 70—160 亿美元。
覆盖数亿人的服务宕机 24 小时,这种事情似乎难以想象,但放在微软身上吧……又好像有了那么一点合理性。
两天前,微软官方终于对外披露了《Microsoft 365 初步事故报告》。这份报告,正好为我们提供了一个绝佳的机会,去窥探这些现代科技巨头接连停摆背后的真实。
环环相扣的诡异风暴
集齐龙珠并非易事,但根据这份初步调查报告,在事故前夕,微软确实凑齐了三个难得一见的危险因素——
首先,是三个多月前部署的一个隐形 bug。
具体来说,这次事故发生在 Microsoft 365 的网络网关服务器上。你可以把它理解成医院的导诊台,负责和用户建立连接、转发请求、管理流量,是微软大多数云端服务流量的必经之路。
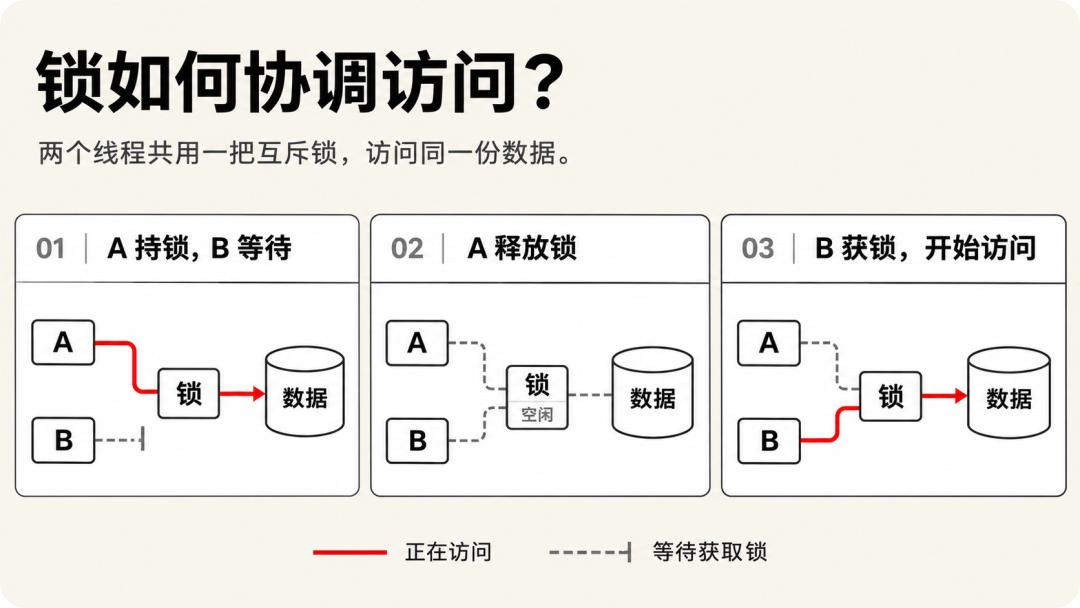
而由于网关服务器可能要同时面对大量请求,为了不让多个线程争夺同一个内部资源的访问权,它还设置了一个名为「锁」(Lock)的协调访问机制,像挂号处一样,确保不同线程根据先后顺序访问资源。
一切看起来都非常顺利,直到微软安装了补丁。
从今年 7 月开始,微软开始给各地的网关服务器推送一个修复某个现有问题的补丁,其后三个多月运行里,没人发现这个补丁里其实埋藏着严重的恶性 bug——
出于未公开的技术原因,它会引发「锁竞争」,也就是让不同的线程为了争抢「号源」而积压,最终导致系统资源消耗殆尽,网关逐渐失去响应能力。
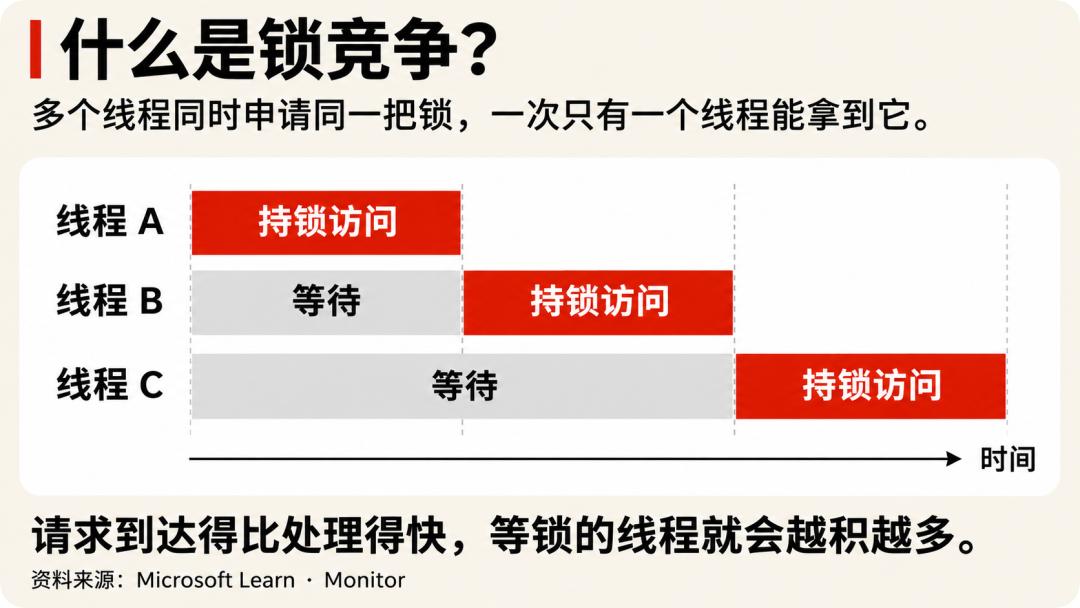
至于为什么在上线前的测试中没有发现问题,微软的解释是,测试用了性能较弱、核心较少的服务器,请求很容易疏散;而来到生产环境的高性能服务器上,更大的「挂号处」反而放大了竞争强度,导致出问题时无法及时疏散请求。
这颗埋在系统里的雷,就等着一个引爆的契机。
第二个因素,是主副网关间的切换。
为了系统可靠起见,Microsoft 365 实际上有两套相互独立、技术细节不同的网络网关系统,主网关出故障,还能切换到备份网关。
但在事故发生前 15 小时,微软因为「日常运维」,将原本跑在备份网关上的 Teams 流量也切换到了正承载着 Outlook 和 Office 等服务流量的主网关,致使主网关压力骤然增加。
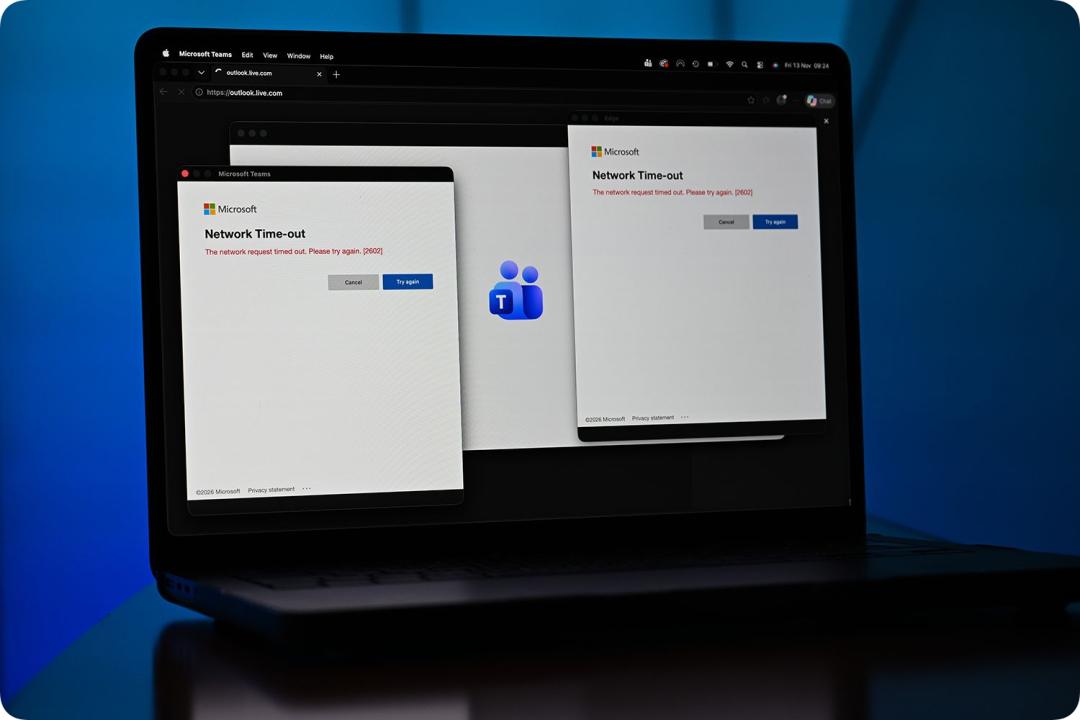
雪上加霜的是,主网关本身就处于「残血」状态。
好巧不巧,就在前一天,主网关上发生了另一起故障,导致 14% 的服务器容量临时下线。
理论上,剩余的容量还足以维持运转;但随着 Teams 流量的接入,主网关突然进入高负载,而高负载状态引爆了此前潜伏的锁竞争 bug,最终服务器负荷进一步加重而陷入死机。
更致命的是,网关服务器还有一套自动调度系统。理论上,当其中一台服务器故障时,调度系统会将它原本承载的流量转移给其他服务器。
而由于所有服务器都有着类似的「高负载即宕机」bug,自动调度最终变成了一场「传染病」,各个服务器如同骨牌倒下,一个个陷入宕机。
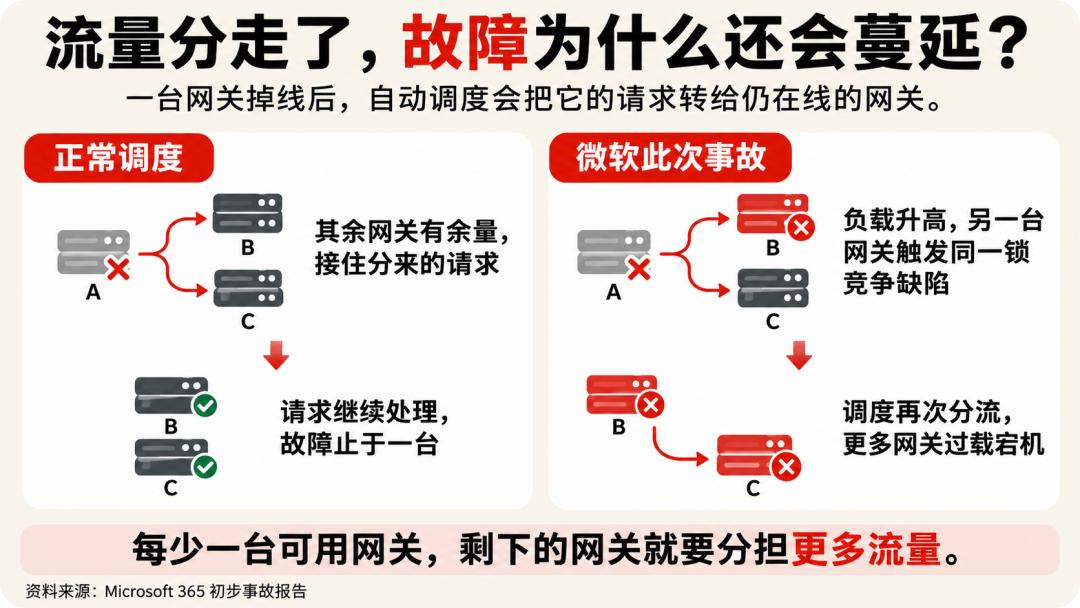
最严重时,超过 80% 的网关服务器都失去响应。
给我翻译翻译,什么叫房子着火了,消火栓里出来的是汽油?
换句话说,微软其实早有冗余灾备,但凡任何一环不掉链子,都不至于引发大宕机;但整个事件的小众猎奇之处,就是每个环节都恰到好处地出了问题,最终酿成一场「完美风暴」。
又或者,正如海因里希法则所说,一起事故背后是 300 个安全隐患。也许在不为公众所知的地方,系统已经涉险过关了很多次,这回不过是运气不再眷顾。
考虑到事故的复杂程度,微软工程师的事后处理其实相当值得赞赏——
错误补丁已经上线太久无法回滚,于是他们现场编写新补丁;自动调度系统会不断冲垮刚刚恢复的服务器,他们就果断暂停调度,一步步地手动拉起整个服务器集群。
赶在 24 小时大限之内,各项服务陆续恢复上线。
只不过,在此期间,医院停诊、法院休庭、交易所与保险公司被迫退回电话联系都是既成事实。
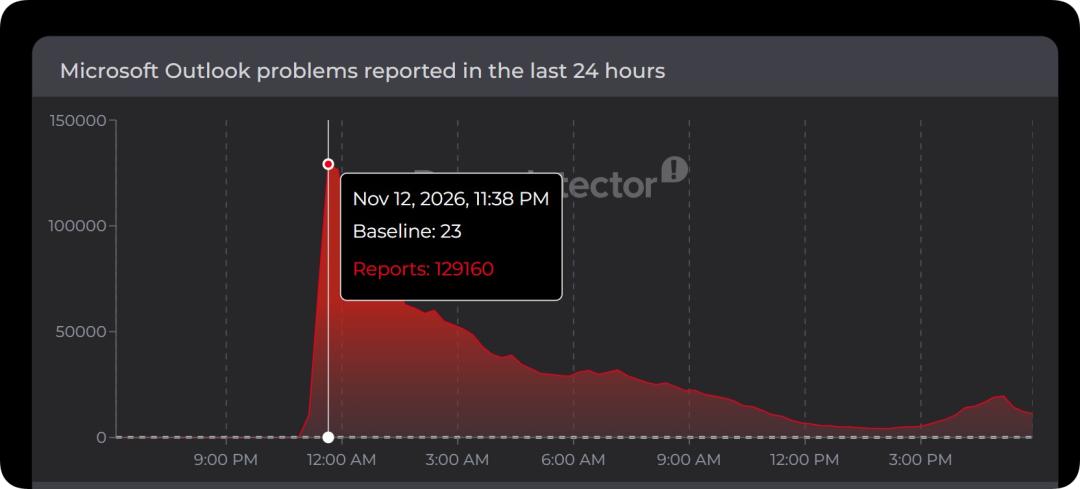
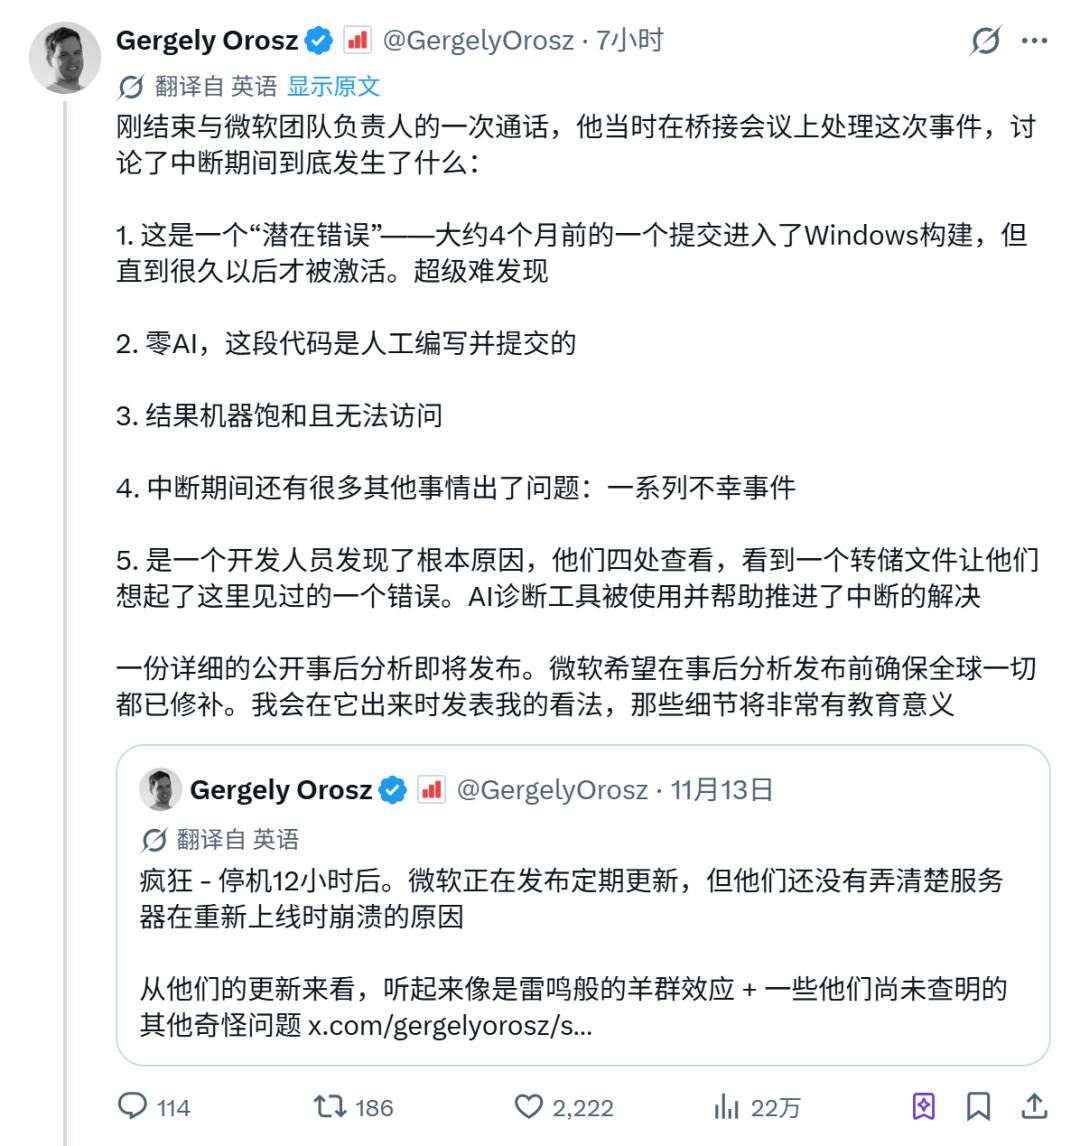
曾任微软和 Uber 工程师、知名技术通讯 The Pragmatic Engineer 的创办人 Gergely Orosz 直言, 这可能是有史以来破坏性最强的商业电子邮件中断事件。
正因如此,微软 CEO 萨提亚·纳德拉不得不公开致歉:
上周的事件再次提醒我们,数字基础设施对于全球运转至关重要。我们知道你们对我们的服务寄予信任,并且极其认真地对待这份责任。在这一背景下,我知道我们还有很多工作要做,才能提供你们以及全世界能够信赖的韧性。
纳德拉的承诺,大可以且看且听,但从他的话中也能看出一个基本事实:微软越是成功,服务越是深嵌进现代世界的基础设施,中断带来的震荡就会越剧烈。
在少数巨头高度掌控通讯与网络的今天,这把达摩克利斯之剑恐怕还将长期高悬在头顶。
AI 不是罪魁祸首,但系统风险不能轻视
人类都有寻找因果联系的本能。面对突如其来的大停摆,人们很难不联想到今年频发的 AI「越狱」网络攻击,以及微软此前向 6 万名雇员开放「自愿离职计划」的新闻。
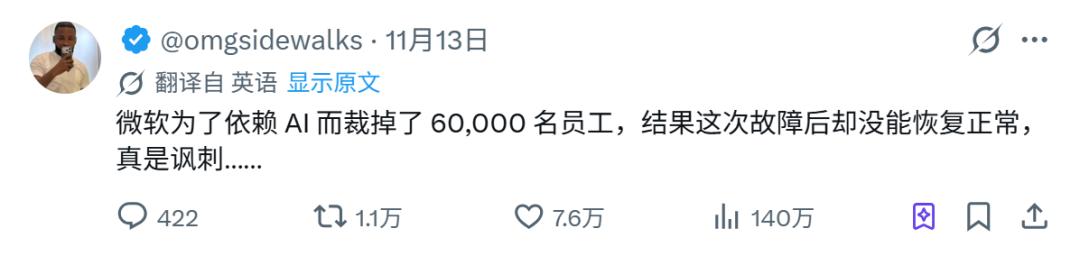
也许是意识到了舆论走向,微软在官方公告中,特意撇清了事故与 AI 和网络攻击的关系:
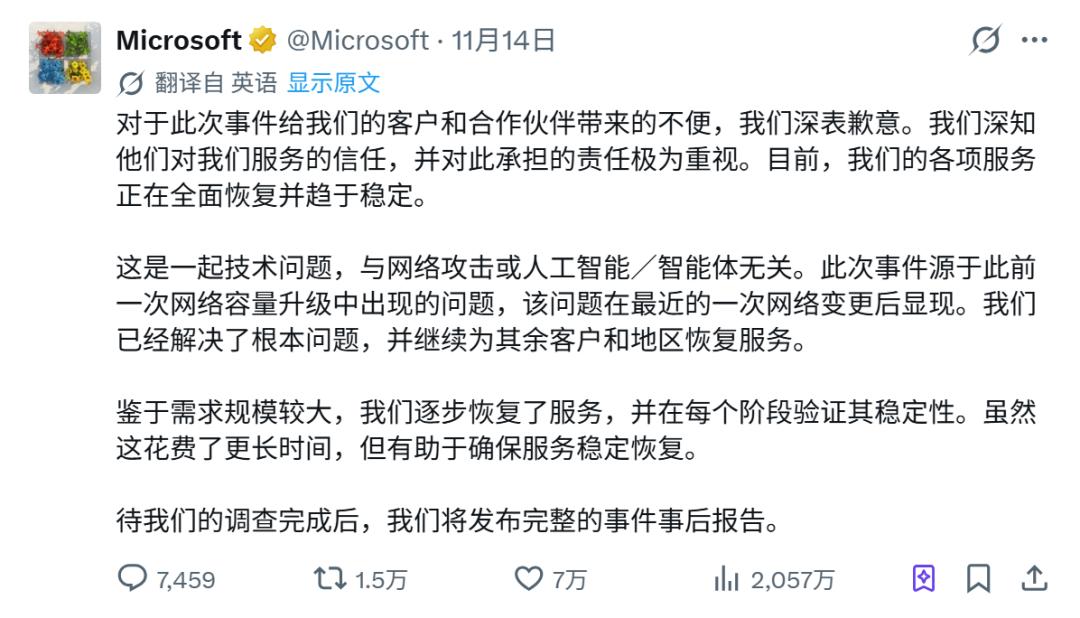
科技媒体从微软工程师团队获取的消息也表明,当初那个带着隐患上线的补丁完全由人工编写。
也就是说,这是一个纯正的、古法手工打造的 bug。
我们此前在评论 PHP2Shell 漏洞时曾说过,AI 编程当然不完美,但它大概率好于人工编程的平均水平。与其说 AI 写出了很多带有漏洞的代码,倒不如说它让我们注意到,早在那之前人类已经写出过很多更糟糕的代码。
关联阅读:OpenAI 发现 PHP 世纪漏洞,全球 70% 的网站都危险了
不过,AI 厂商为了彰显旗下模型能力而一再炒作「AI 安全性」的话题,客观上也将 AI 推向了风口浪尖。
正如近年来游戏玩家倾向于把某款大作的暴死归咎于植入的 DEI 元素,当 AI 成为科技界最显眼的标签时,一旦发生任何系统性失败,AI 都必然会成为众矢之的;反过来,舆论压力又将倒逼出更多监管,进一步制约 AI 的发展,造就了当今 ChatGPT 和 Claude 模型极具防御性的「敏感肌」形态。
另一方面,尽管微软这次大宕机看似只是一场巧合,但最近短短一周之内,类似的「偶发事故」未免有些过于密集了。
图|Inc. Magazine
一次意外,还能说是草台班子的疏忽;但当巨头们轮流上演崩溃戏码时,就很难再拿单一的偶然因素当挡箭牌——
这背后,某种系统性的结构风险正在浮出水面。
我们总是习惯性地把现代科技的顺利运作视为理所当然,却忘了如此庞大的系统能够正常运行,本身就是一种工程学上的奇迹。
在大多数时候,系统每个模块的维护者,其实根本无法窥见系统的全貌;每个人只是根据预先设定的规则,在各自的局部做好分内事,庞杂的系统便在精密的配合中运转了起来。
这种「涌现式」的协作机制,正是现代社会的基石。
但它的另一面,则是系统复杂度的指数级膨胀,以及人类社会对单一网络生态的深度依赖。
为了追求更高的效率与稳定性,我们在系统之上叠加系统,用冗余备份覆盖冗余备份,甚至引入自动化调度去管理另一套自动化程序。
但就像微软这次事故中展现的那样,原本用来防灾的「锁机制」与「自动流量调度」,在特定条件下反而会互相咬合,演变成摧毁系统的帮凶。
当一个系统的复杂度跨越某个临界点后,局部的小毛病便不再是孤立事件,它们会在错综复杂的网络中被无限放大,引发无法预计的链式反应。
某种程度上,近期频繁爆发的宕机,正是系统复杂性与网络依存度不断攀升所必然伴随的副作用。
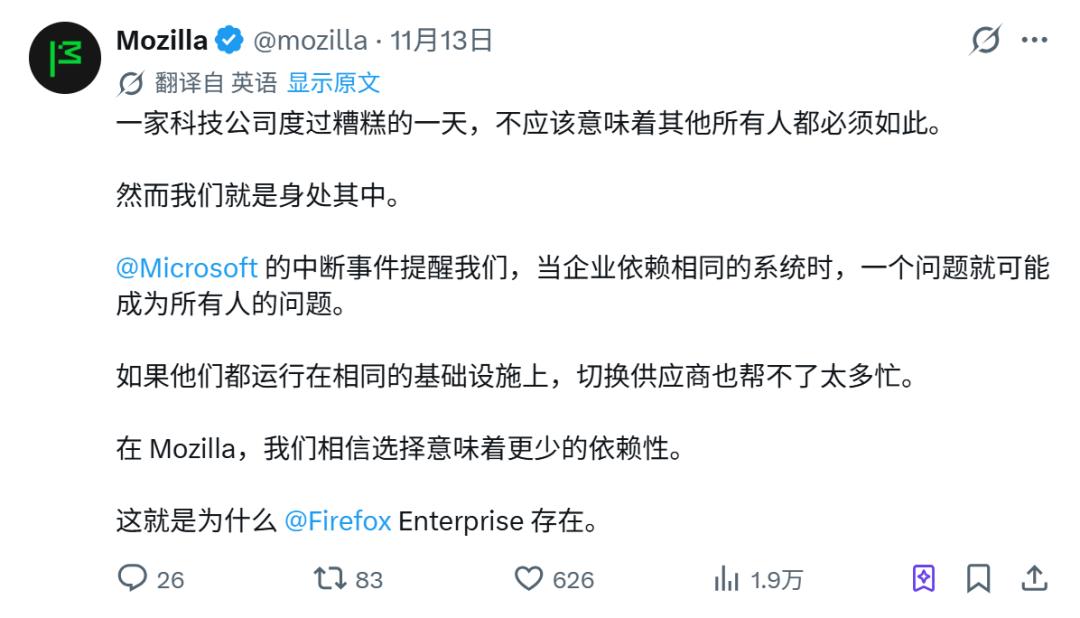
图|出来「补刀」的 Mozilla 基金会
既然追求更复杂的系统、更深度的连接是不可逆转的时代大趋势,那么我们就必须接受一个事实:类似的「黑天鹅事件」,还将在未来不断发生;不是微软、苹果,也可能是 OpenAI、Google 和亚马逊。
毕竟,当整个世界都被装进同一个巨大的篮子里,哪怕只是断了一根绳索,所有人都会跟着一起摇晃。