

 搜索


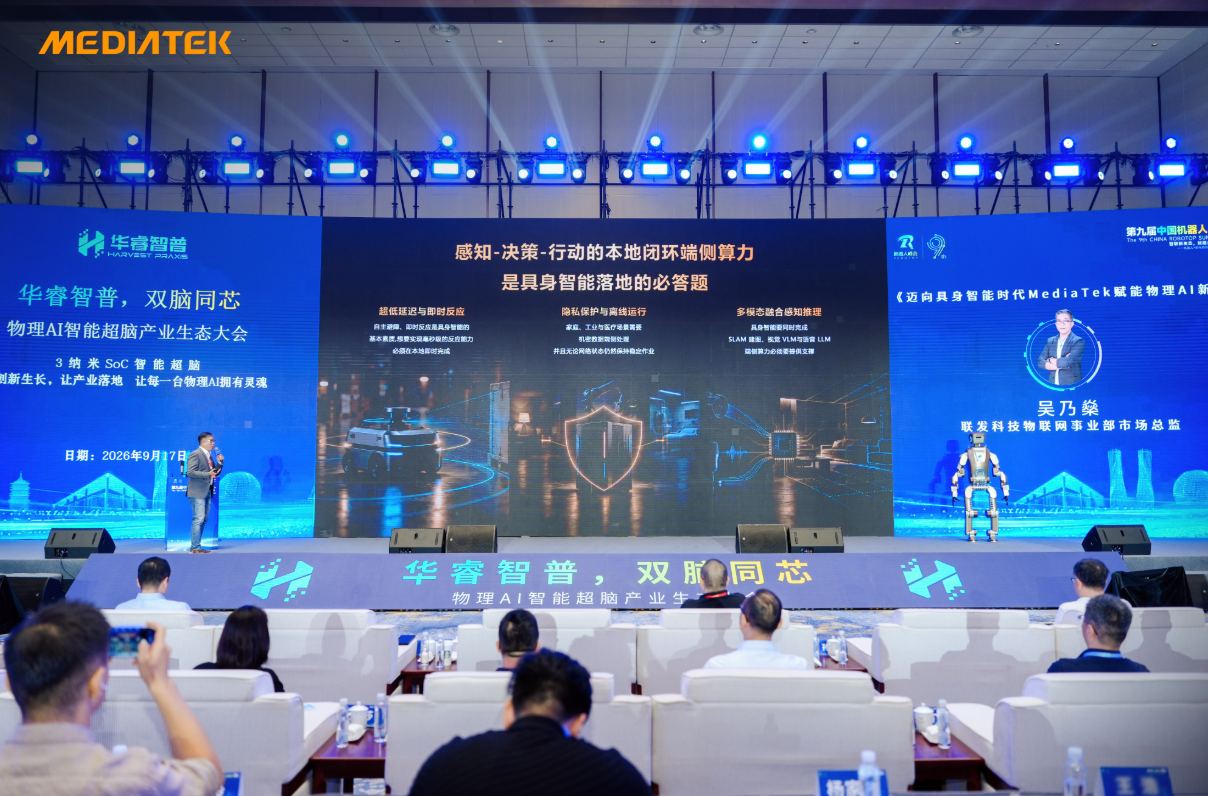
9 月 17 日,第九届中国机器人峰会期间,华睿智普举办专项产业生态大会,正式发布搭载大小脑单芯片融合架构的 Praxis One 具身智能超脑算力底座。该平台基于联发科技旗舰级 SoC Genio Pro 5100 打造,聚焦物理 AI 与具身智能产业化过程中的落地难点,展示端侧算力在推动具身智能从实验室样机向规模化产业应用落地过程中的核心价值。
当前,AI 技术正逐步从数字世界延伸至物理场景,具身智能被视为机器人产业的重要发展方向。业内普遍认为,实体机器人要实现可靠落地,无法完全依赖云端大模型支撑,其核心的感知、决策、行动全流程需要形成本地闭环,这对端侧芯片提出了超低延迟响应、数据隐私保护与离线运行、多模态融合感知推理三大核心要求。
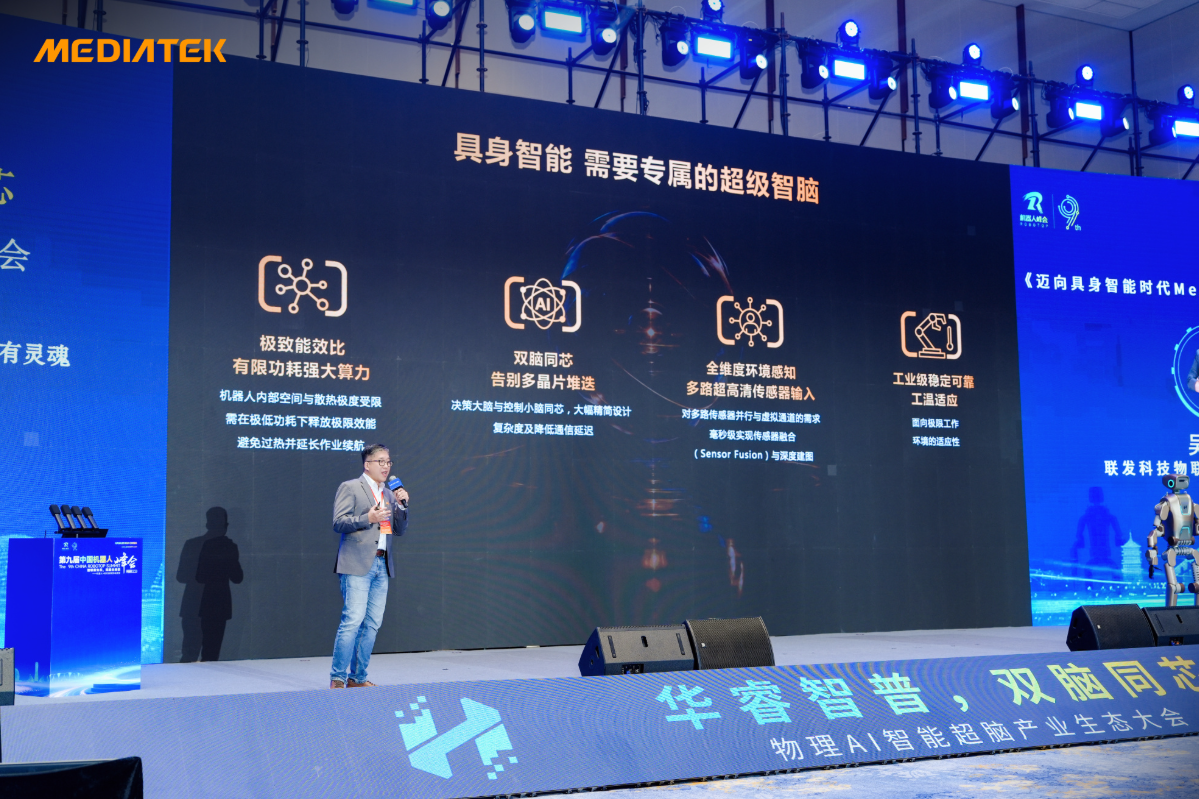
而传统工控芯片多采用多芯片堆叠方案,难以同时兼顾能效水平、感知能力、实时控制与工业可靠性等多维度需求,成为制约产业落地的技术瓶颈之一。针对这一行业现状,联发科推出面向具身智能场景的 Genio Pro 5100 芯片,定位机器人专用算力核心,从多维度匹配产业落地的技术需求。
在基础算力层面,Genio Pro 5100 采用台积电 3nm 先进制程,搭载基于 Arm v9.2 架构的 8 核全大核 CPU,具体配置为 1 颗 Cortex-X925、3 颗 Cortex-X4 与 4 颗 Cortex-A720,搭配 12MB 三级缓存与 10MB 系统缓存,运算性能可达 260K DMIPS,能够承接机器人运动学计算、动态环境规划等高负载任务。其“决策大脑 + 控制小脑”的同芯集成设计,可减少多芯片堆叠带来的硬件复杂度与通信延迟问题。
AI 算力方面,芯片内置联发科自研第 8 代 NPU 890,AI 算力达到 106 TOPS,搭载 Transformer 专用计算引擎,可在端侧本地运行 Qwen3 7B 大语言模型,推理速度可达 23 Token/s,能够支撑机器人实现端侧即时对话、场景理解,达成近乎实时的生成式 AI 交互。无需完全依赖云端网络的特性,也保障了设备在断网环境下仍可开展多模态大模型推理工作,同时满足场景数据的隐私保护需求。
在环境感知能力上,Genio Pro 5100 配备旗舰级 ISP 影像处理器,支持最多 16 颗 FHD 摄像头虚拟通道输入,具备 16-bit HDR 硬件处理能力,可在强光、逆光、暗光等复杂场景下完整保留画面信息,保障 SLAM 建图、多传感器融合的全天候稳定运行,为移动机器人、人形机器人提供全场景环境感知支持。此外,芯片还支持 8K 视频编解码与三路 4K 显示输出,可适配工业人机交互、机器视觉检测等多元应用场景。
通信与可靠性层面,芯片原生集成 Wi-Fi 7,可扩展 5G/5G Redcap,同时搭载蓝牙 6.0,借助信道探测技术实现厘米级高精度测距。其中 Wi-Fi 7 的微秒级低时延可支撑多台机器人协同作业,5G 能力拓展户外广域作业场景,蓝牙 6.0 则可满足室内高精度定位需求,适配工厂、园区、家庭等不同作业环境。面向工业场景,Genio Pro 5100 支持 - 40℃~+105℃ 宽温工作,提供 10 年长生命周期供货支持,可适应复杂极限工况;软件生态方面,原生支持 Linux Yocto、Ubuntu 与 Debian 系统,无缝兼容 ROS2 机器人操作系统,有助于降低整机厂商的二次开发门槛。
据了解,联发科拥有覆盖数据中心、消费电子、汽车、IoT 及通信领域的端到云完整技术矩阵,依托多年的大规模量产与功耗优化经验,可为机器人产业提供底层算力支撑。
本次基于 Genio Pro 5100 打造的算力底座发布,也向产业释放出信号,端侧算力正在成为具身智能落地的核心支撑,随着整机、算法厂商的协同推进,实体智能机器人的规模化应用将进一步提速。
