

 搜索


从ChatGPT带火的Prompt,再到今年刷屏的OpenClaw、AI Agent,AI圈带火的新名词堪比互联网公司黑话。
最近,Google旗下DeepMind传言已经接近实现AI的超能力RSI(递归自我改进)。
在微软、Anthropic、OpenAI、马斯克等业界大佬频繁呼吁放缓前沿人工智能发展速度的当下,RSI开始频繁出现在许多报道里。
用一句不太严谨的话解释RSI,那就是“AI自己造AI”。换句话说,用一个成熟的AI系统帮助开发下一代更强大的模型,并提高未来模型的研发效率,一旦循环起来,那AI的进步速度可能远超现在的迭代方案。
虽然RSI最近才火起来,但这种思想源头可以追溯到六十多年前。1965年,英国数学家I.J. Good提出,如果一台机器能够超越人类的智力活动,设计机器也应当属于它的能力范围。它可以设计出比自己更聪明的机器,机器智能由此进入加速的正反馈循环,他称之为“超智能机器”。
也就是这么一个科幻的概念,最近正以超出预期的速度走向现实。
9月上旬,OpenAI首次公开披露RSI进展,预计2028年3月前实现自动化AI研究员;其首席科学家帕霍基发文警告,人类尚未准备好应对超级智能的快速演进。
另一家AI巨头Anthropic也尝试将自动化推进到安全研究,之前就使用过Claude Sonnet 5帮助早期的Claude Opus 4.8改善安全表现,仅用约2400条训练样本,就把成绩优化到接近正式版的水平。
除了修改模型本身,业内还有一条更现实的路径,就在模型配套的软件系统上打补丁,业内称之为“Harness Engineering”,这种工程范式让智能体可以改进自己的记录方式、修正出错的工具接口、重写低效的代码。这些变化未必改变模型权重,却可能显著提升整个系统的能力。
不过,对比真正的RSI,并非所有自我改进都配得上递归二字。目前绝大多数所谓的“AI进化”,说白了还是离不开人工的干预,真正的RSI除了对比上一代时有明显的进步,还有一点就是比上一代更擅长“制造”后继者。
换句话说,一个系统可能每次都比上次高一分,却越来越慢、越来越贵、同时更依赖人工,这其实只能算是版本的更新;相比之下,另一个系统或许跑分并没有那么高,却越来越会用更少资源造出更好的后继版本,这才更接近RSI的概念。
当然,业内对于RSI的准确判断其实还在探索中,9月10日,arXiv 挂出一篇由国内33 位作者共同完成的论文,涵盖了上海交大、清华大学、字节跳动、上海 AI Lab 等机构。
该论文把RSI的自主性划分为L1至L5五个层级,从执行人类给出的改进方案,到自主寻找改进策略,再到获取经验、把环境反馈转化为持续保留的改动;到了L5,改进机制本身也成为改进对象,人类制造的不再只是一个模型,而是一套能继续制造模型的系统。
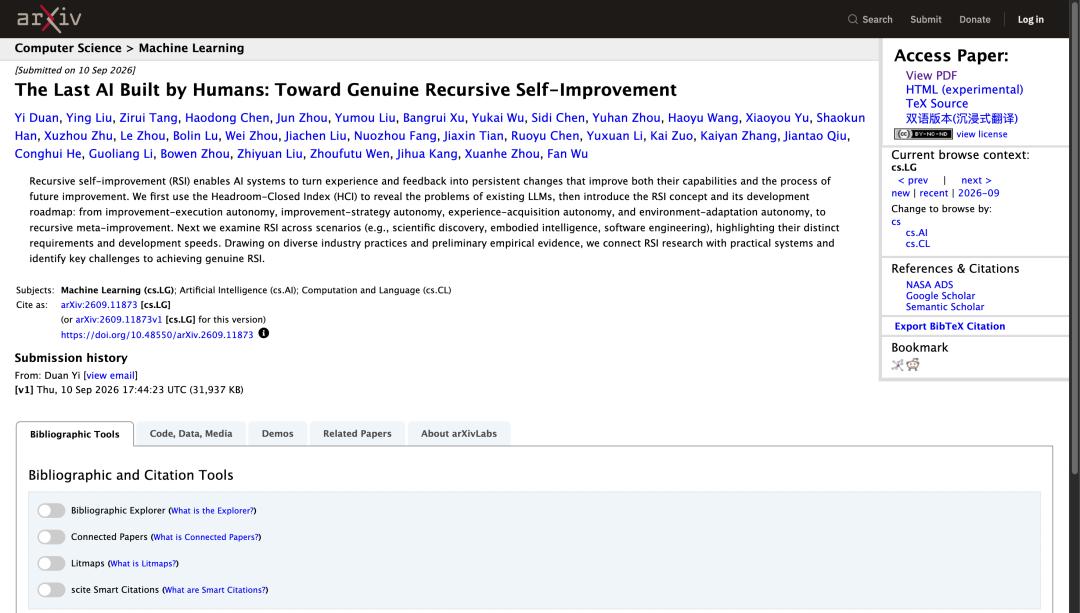
按照这个标准来看,目前绝大多数所谓模型都达不到RSI的要求,大多数都是为了渲染“AI末日论”。
目前,围绕RSI的争论早已超出技术范畴。
Anthropic CEO阿莫代伊呼吁同行集体降速,提议引入拥有接近员工权限的第三方评估团队长期监督,OpenAI和马斯克罕见地形成统一阵线。
但也有人指出,大型实验室要求放缓发展,并不全是出于安全考虑,也可能是在争取监管护城河,一旦监管收紧,拥有庞大安全团队和审计资源的大公司更容易满足要求,而开源社区和中小企业将面临更高门槛。
