

 搜索


当Agent已经能够调用工具、使用技能并保存记忆,一个更进一步的问题是:这些能力怎样在任务中配合,又怎样从过去的执行中积累可复用的经验?
能查到机票价格,不代表知道查询后该停下来;能保存笔记,也不意味着会在下一次决策前读回。Agent需要处理的,还有操作之间的顺序、条件和衔接。
来自谷歌(Google)、美国佐治亚理工学院(Georgia Institute of Technology)和北京大学(Peking University)的研究者,围绕这一问题提出了Procedural Graphs(PG,程序图),将工具调用、技能步骤、内部推理与任务状态组织成有条件的连接,为Agent提供「接下来如何行动」的依据。
论文:https://arxiv.org/pdf/2609.09153
从Agent harness——模型周围的执行支持系统——来看,PG提供了一种把tools、skills、memory等组件连成网的方式,描述这些能力在什么条件下使用、怎样衔接,以及哪些错误需要避免。
执行任务时,Agent读取当前步骤附近的子图,生成针对当前情境的指导;离线阶段,系统根据执行轨迹提出改图方案,经独立验证后决定是否保留。
经验由此成为可以读取、检查和修订的程序关系,图的更新也无需重新训练模型权重。
从独立组件到程序关系,一张图连接什么?
Tools、Skills和Memory各有作用。工具提供查询、计算或提交等具体操作,技能封装可复用的做法,记忆保留任务信息与历史经验。在执行过程中,Agent还需要判断:什么时候读取记忆,哪项技能需要调用哪个工具,得到结果后又该保存什么。
PG将这些衔接关系显式写成「过程—关系—过程」三元组。
节点可以是一项技能、一个工具函数、一次内部推理,也可以是一个任务状态。连接两个节点的有向边,描述从当前步骤转向后续步骤的关系,并包含三个字段:适用条件(condition)、执行建议(guidance)和需要避免的问题(pitfalls)。
例如,「预测现金流」可以连接到「申请融资」。这条边的条件是预计现金支撑时间低于安全缓冲;建议是提前申请,为资金到账留出时间;需要避免的问题,则是在已有申请尚未完成时重复发起。
同一个工具动作,由此获得了更完整的使用上下文:为什么现在调用,调用前需要满足什么条件,以及什么情况下应当等待。
知识图谱通常用「实体—关系—实体」组织事实,帮助系统回答「是什么」「在哪里」。程序图关注的是另一类知识:做什么、按什么顺序做,以及在什么条件下做。
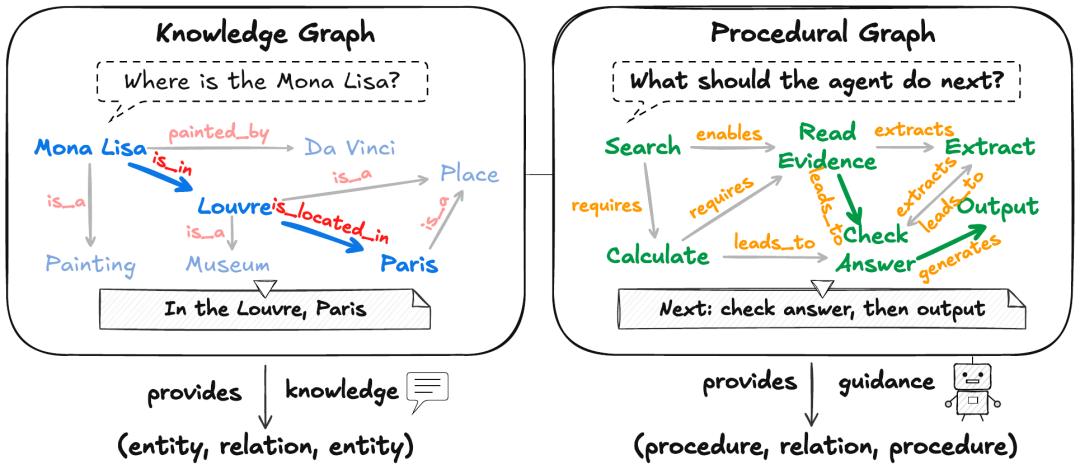
图1|知识图谱组织事实,程序图连接做事的步骤、条件与执行建议。来源:论文图1。
记忆的使用也可以进入这套结构。论文附录中的财务Agent提供了一个具体例子:演化出的图先连接现金检查、现金流预测、保存笔记(save_note)和市场数据检查;随后,又把回读笔记(recall_notes)接到每月开始的位置,让上个月保存的关键信息能在新一轮决策前被取回。
在这里,工具负责查询与计算,笔记保存跨月信息,PG则描述何时写入、何时读取,以及读写操作怎样接上后续决策。工具调用和记忆读写因此成为同一张程序网中的步骤。
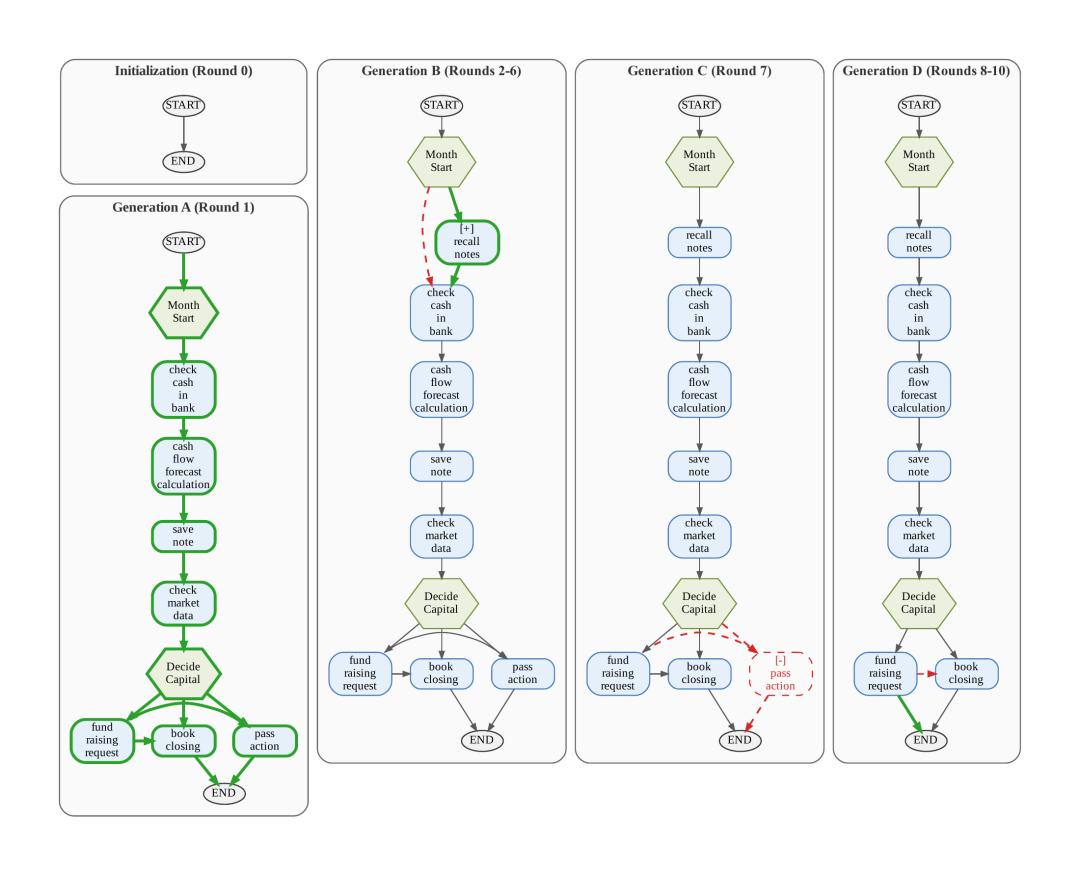
图2|财务Agent程序图的结构演化。图中逐步加入现金检查、现金流预测与保存笔记等步骤,并在每月开始时接入回读笔记;后续轮次继续调整行动分支。绿色表示新增节点或连接,红色虚线表示删除。来源:论文图5。
PG本身也承载着程序性记忆:经过任务验证的行动方式,被保存在模型权重之外的图结构中。需要修改一条条件或补充一个检查步骤时,研究者可以直接改图,再检验它对执行结果的影响。
在线指导,根据执行位置读取局部子图
把程序关系组织成图之后,还需要决定每一步读取哪些内容。
整张图包含完整信息,也可能带入大量与当前任务无关的分支。独立检索几条语义相似的建议,则可能遗漏步骤之间的联系。例如,只取回「提交」的指导,却没有取回前面的「检查答案」,Agent就可能缺少判断何时可以提交的依据。
PG将在线指导组织为三个连续操作。
定位当前步骤。 系统根据最近执行的动作匹配图中的节点,确定Agent当前所处的位置。
提取相连的局部结构。 默认读取沿出边两跳以内的子图,即从当前位置出发、最多经过两次连接可到达的步骤。匹配不到节点时,回退到整张图。
生成当前情境下的指导。 指导模型结合局部子图、用户任务和近期执行记录,生成下一步建议,加入执行模型的提示词。最终动作仍由执行模型选择。
在论文实验中,指导模型与执行模型采用同一种基础LLM。执行单个任务时,图保持固定。
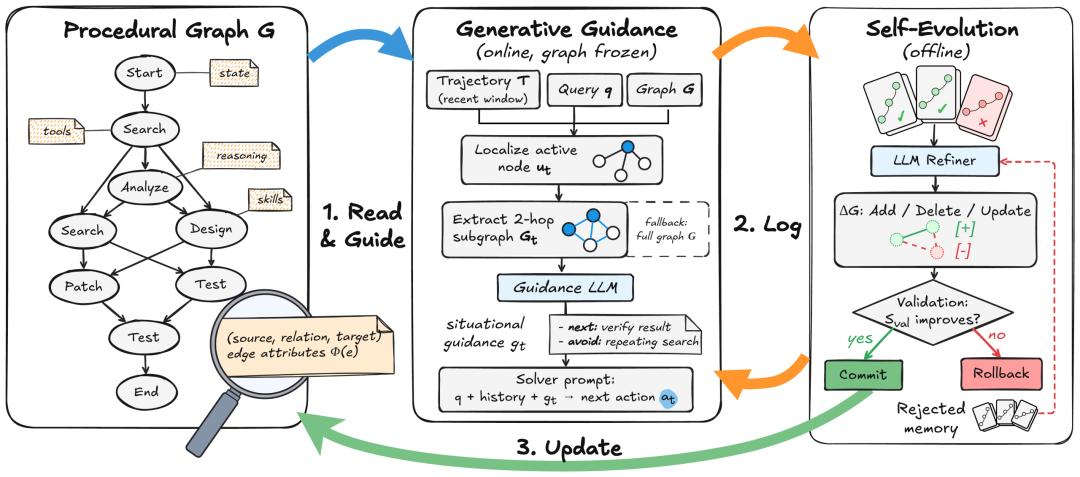
图3|执行时定位当前节点,读取局部子图并生成指导;离线阶段根据轨迹修改图,通过结构检查且验证分数不下降时保留修改(包括持平)。来源:论文图2。
一次机票查询展示了这类指导如何影响任务的结束时机。在BFCL工具调用测试中,用户只想了解经济舱票价。无图基线查到了220美元的报价,却继续认证身份、操作银行卡并尝试订票;失败后,它还修改预算限制,再次完成预订。
同样使用Gemini 3.5 Flash,PG指导下的Agent在报出220美元后结束当前回合,等待用户的新指令。这个案例体现了程序知识的一项作用:帮助Agent判断,已有操作是否已经满足当前请求。
离线演化,从执行反馈中修订程序图
程序图的效果取决于其中保存了什么。手工写出的流程看起来合理,实际执行时也可能带来问题。
论文在MultiChallenge上进行了图构建实验。这一实验使用Gemini 3.5 Flash,包含56个测试样本:无图基线成功率为87.50%,加入手工专家图后降至58.93%,让模型静态更新一次后为53.57%。
这组结果说明,对程序关系的修改需要经过任务检验。PG为此设计了一个离线循环:执行任务、分析轨迹、提出修改、验证候选图。
系统先在一批训练任务上运行当前保留的图,再由修订模型对照高分与低分轨迹,查找反复出现的错误或可以复用的步骤。修改可以增加缺失的节点与连接,删除容易引起失败的路径,也可以重写边上的条件、建议和注意事项。
候选图先通过结构检查,再在独立验证集上运行。只有测得的验证分数不低于当前保留图,系统才采用这次修改;分数持平也可以保留。被拒绝的方案及其结果会留下记录,供后续修订参考。
这些变化发生在离线批次之间。因此,执行中的Agent读取的是当前版本的程序知识,新的经验经过验证后再进入后续版本。
在上述MultiChallenge构建实验中,从58.93%的专家图出发,迭代演化后的成功率达到92.86%,比专家初始化提高33.93个百分点,也超过了87.50%的无图基线。
论文附录中的一个验证样本要求Agent讲笑话,同时延续此前「只用被动语态」的约束。但第二代候选图指导下的Agent偏离了任务,转而回答环境附带的评价问题——模型是否一直使用被动语态,回复以「没有一直使用被动语态」开头。
第三代候选图删除了直接结束的连接,并改写「提取约束→结束」的指导,要求不要直接回答评价问题。这次Agent经过提取约束步骤后给出了笑话,该验证样本的成功标记从0变为1。
这一案例让「经验更新」有了具体的观察对象:哪条连接被删除,哪段指导被改写,以及后续执行出现了什么变化。
研究者还尝试从最小图结构开始演化。在HotpotQA构建实验中,这种方式得到的PG取得78.79的答案F1,高于无图基线的71.21,说明程序结构也可以从执行反馈中逐步建立。
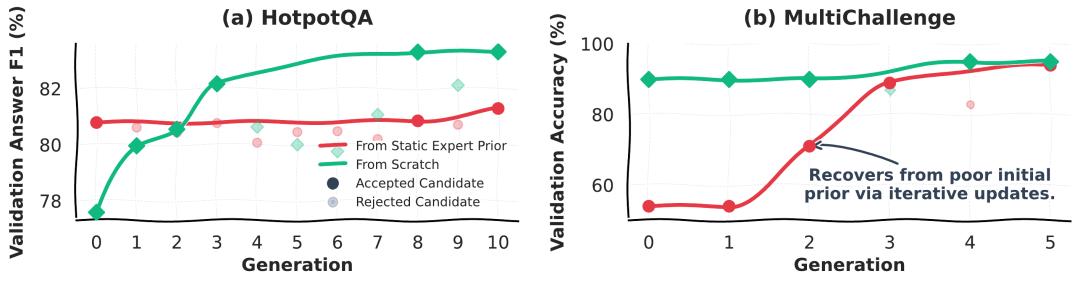
图4|从专家图或最小图结构出发的演化轨迹。两组实验均使用Gemini 3.5 Flash:左图为HotpotQA验证集的答案F1,右图为MultiChallenge验证集的准确率。实心标记表示采纳的候选,浅色标记表示被拒绝的候选;图中指标来自验证集,与前文测试集结果分别统计。来源:论文图6。
任务评估,工具调用与长期决策中的表现
论文评估覆盖多跳问答、多轮指令遵循、专业任务、交互式环境、工具调用和长期财务决策。各方法使用相同的ReAct执行框架,比较不同的经验存储与复用方式。
在工具调用基准BFCL v3上,Gemini 3.5 Flash使用PG后的准确率为67.00%,该组最强基线为58.00%。在专业任务GDPval与要求遵守业务规则的τ-bench上,Gemini 3.1 Pro也获得了提升。
长期任务进一步考察动作之间的时间关系。在EnterpriseArena中,Agent管理一家模拟企业,连续作出最多132个月的财务决策,需要应对现金流变化、资金到账延迟与经济冲击。
融资申请发出后,资金需要一至六个月才能到账。如果等现金即将耗尽时才申请,企业可能无法度过等待期。轨迹分析显示,PG指导下的Agent更早检查现金流、预测资金缺口,并在相对稳定的月份发起融资申请。
每种配置均进行了50次测试模拟。与无图基线相比,Gemini 3.1 Pro完成整个模拟周期的存活率从6.0%提高到34.0%;Claude Sonnet 4.6从44.0%提高到58.0%。
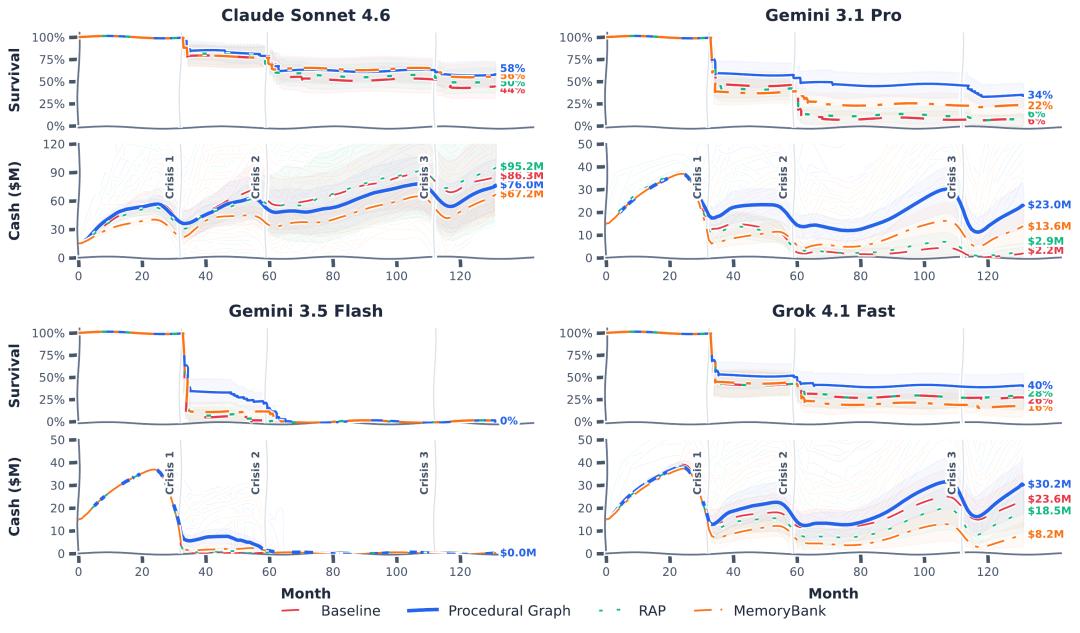
图5|四个模型在EnterpriseArena中的长期决策表现。各模型面板上方为存活曲线,下方为现金余额(百万美元);每种配置进行50次测试模拟,最长持续132个月。蓝色表示PG,红色表示无图基线,绿色与橙色分别表示RAP和MemoryBank;竖线标出经济冲击时点。来源:论文图3。
这类任务中的程序知识,需要把当前操作与延迟出现的结果联系起来。前文的记忆读写流程也服务于这种连续决策:保存上个月的关键信息,在新一轮行动前取回,并结合当前状态继续判断。
局部指导的收益与成本
局部子图是否比整张图更适合当前决策,论文通过消融实验进行了比较。
在使用Gemini 3.5 Flash的ALFWorld固定测试子集上,基于整张图生成指导时,成功率为54.48%;使用同一张图、改为局部子图指导后,成功率达到81.53%。每个样本的平均Token消耗从96,360降至28,064,比全图生成式指导减少约70.9%。
这一结果支持了按执行位置读取相关程序关系的设计。不过,局部指导仍有额外开销:同一实验的无图基线平均使用18,055个Token,低于局部子图指导。离线运行与候选图验证也需要计算资源。
不同任务的收益同样存在差异。在主表HotpotQA问答实验中,PG相对各模型最强基线的差距介于下降0.90与提高1.30个百分点之间,小于前述几项任务。程序图在跨模型、跨工具接口复用时能保留多少效果,仍需进一步研究。
从一次执行到下一次行动
从harness的角度看,PG让tools、skills、memory之间的配合关系成为可以检查和改进的对象。补充一步检查、修改一项条件,或调整一次记忆读取的时机,都可以落实到具体的节点与连接。
这些修改经过离线验证,被采纳的方案进入后续版本的程序图。一次执行留下的经验,由此有机会成为下一次行动的依据。PG探索的,正是如何让这张连接各类能力的程序网在执行反馈中逐步改进。
参考资料:https://arxiv.org/pdf/2609.09153
