

 搜索


就在刚刚,马斯克SpaceXAI正式发布,全新主力模型Grok 4.7!
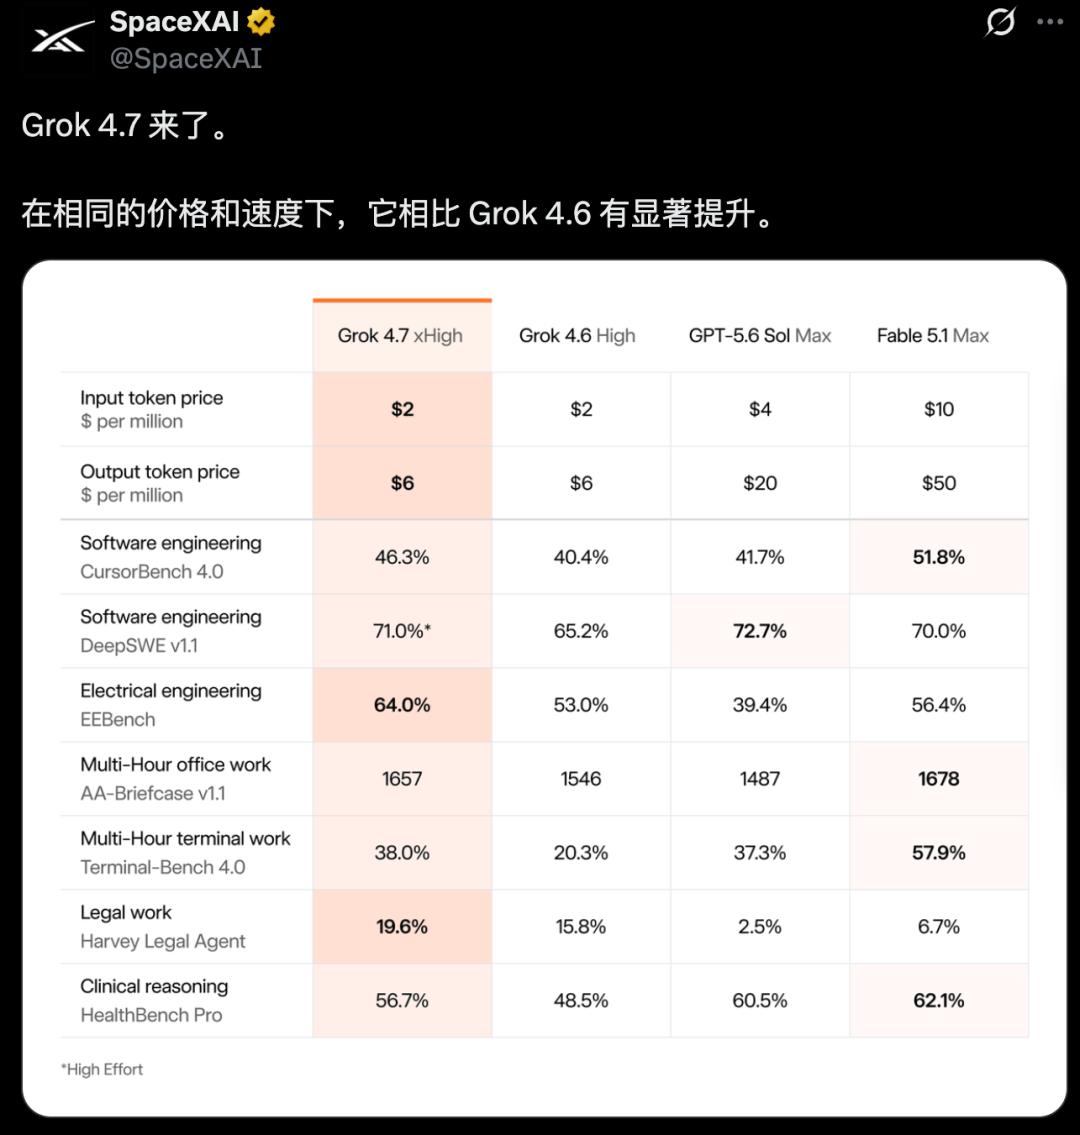
核心卖点主打一个,同样的价格和速度,超强的性能。
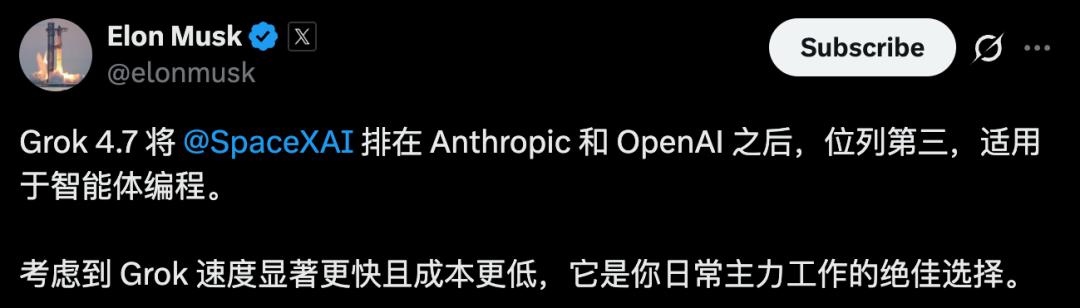
马斯克第一时间喊话,「Grok 4.7把SpaceXAI送上了智能体编程的第三把交椅,仅次于Anthropic和OpenAI」。
速度又快,价格又低,Grok 4.7是个人搬砖干活的首选。
SpaceXAI官博中,官方给出的定位:史上最强Grok,专为编程和知识工作而生。
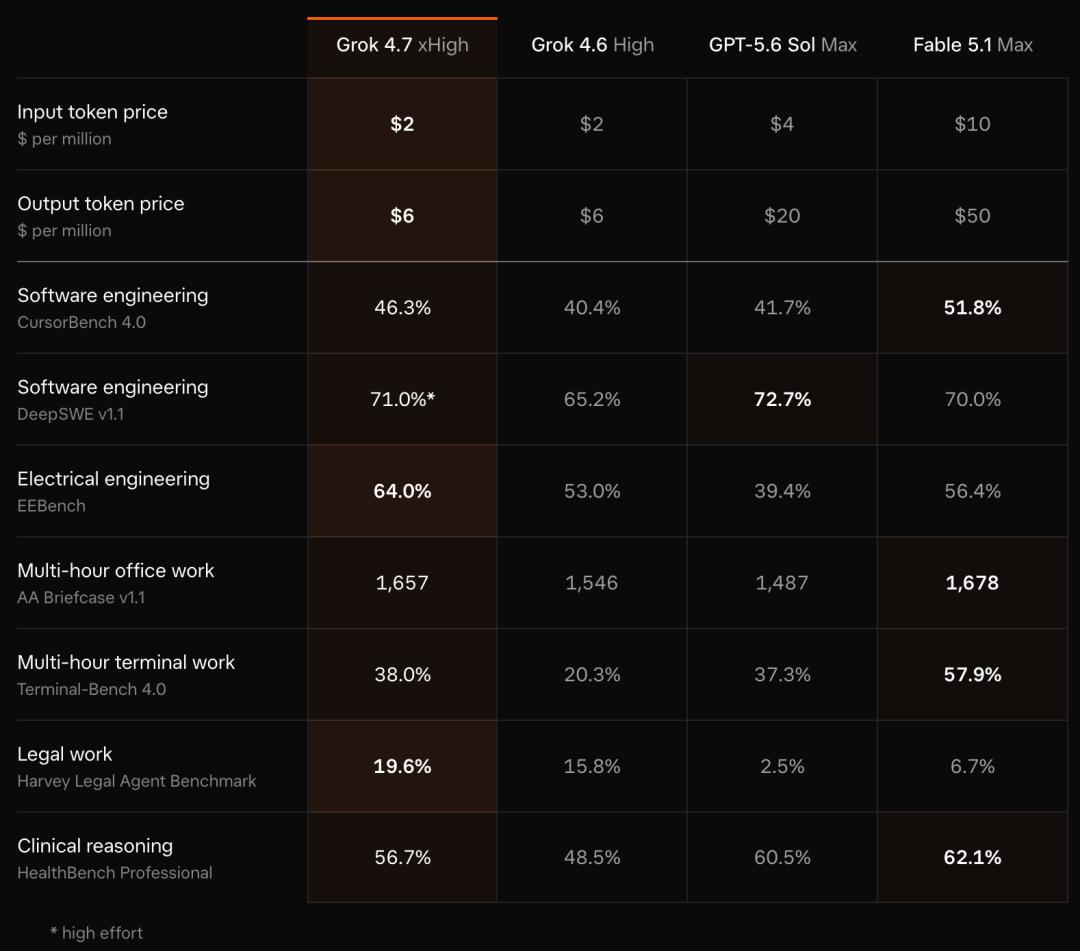
具体来说,Grok 4.7在编程和知识工作基准上,成绩几乎盖过了GPT-5.6 Sol Max,直追Fable 5.1 Max。
输入每百万Token 2美元,输出6美元,和Grok 4.6一模一样。
但底层模型彻底大换血,基座模型更大,强化学习训练拉长,任务难度加权向「需要数小时才能完成的工作」倾斜。
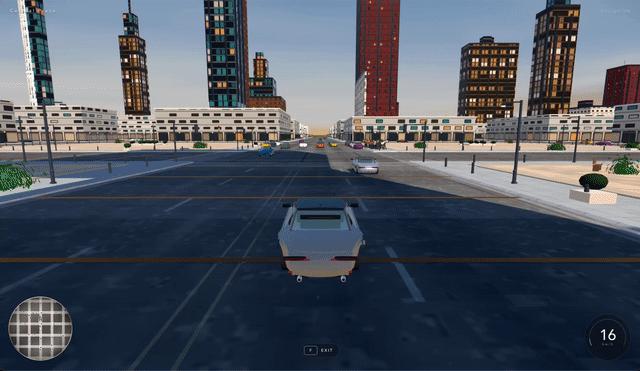
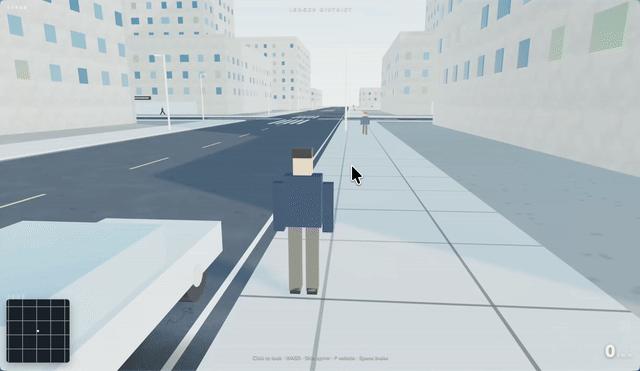
让Grok 4.7和Grok 4.6去搓个开放世界城市游戏,差距真的是肉眼可见。
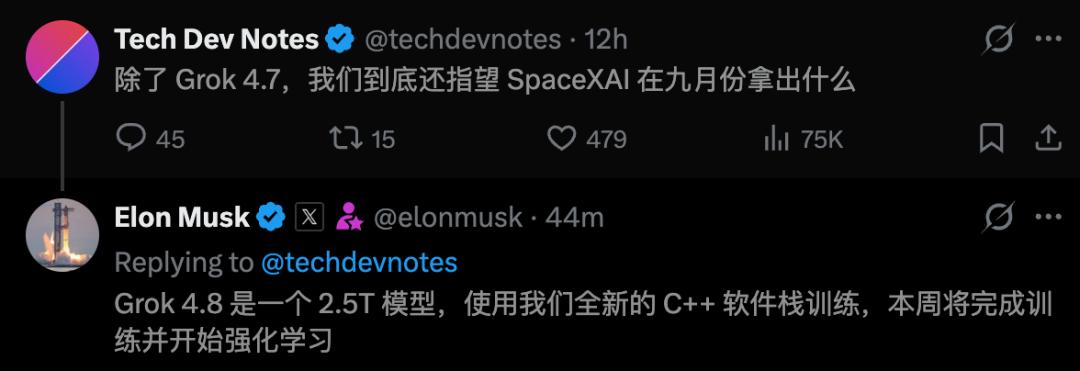
值得一提的是,下一代2.5T新模型Grok 4.8也训完了。
马斯克的拿手好戏,才刚刚开始。
Grok 4.7登场,编程追进第一梯队
更能量化Grok 4.7这轮进步的,还是编程测试。
拆开AA的榜单,数据很有意思。
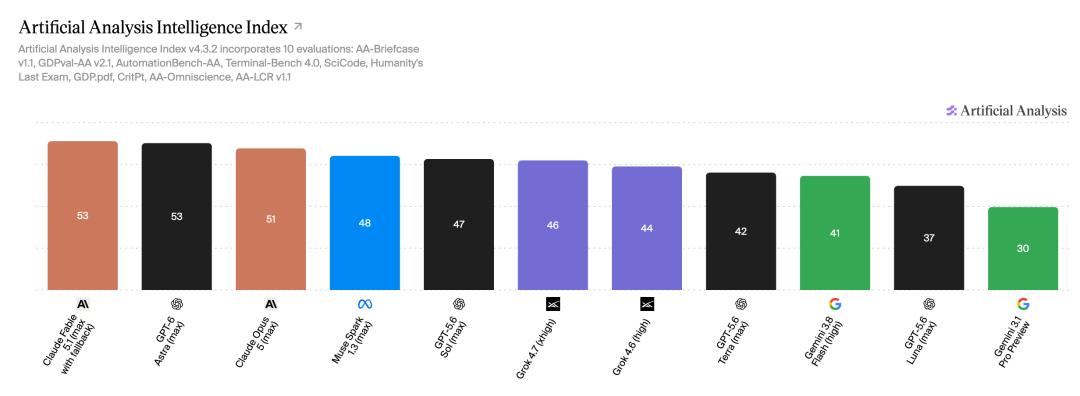
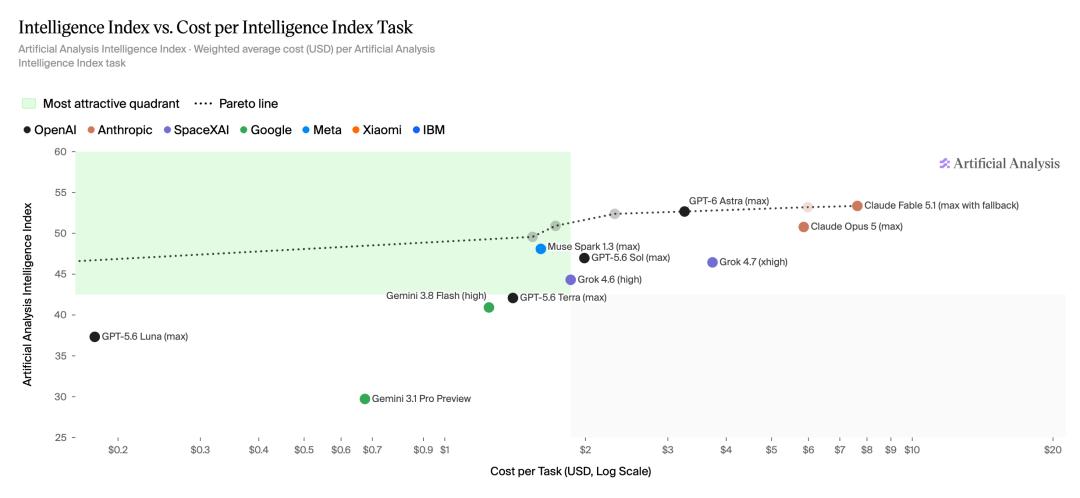
综合智能指数上,Grok 4.7拿下46分,相比4.6只寒碜地涨了2分。而第一梯队的Fable 5.1和GPT-6 Astra全是53分。
按单模型算,它排在第16名;按实验室排,刚好挤到了第四。
而真正让马斯克吹上天的编程榜,其实是两张。
1. 套上GrokBuild框架,Grok 4.7飙到56分,排在Fable 5.1、GPT-6 Astra和Opus 5之后。马斯克口中的「全球第三」,是偷偷把Anthropic的两个模型并成了一家。
2. 换到统一基准的Terminal-Bench4.0后,Grok 4.7的通过率当场暴跌到26%~27%。作为对比,GPT-6 Astra是60%,Fable 5.1是55%。
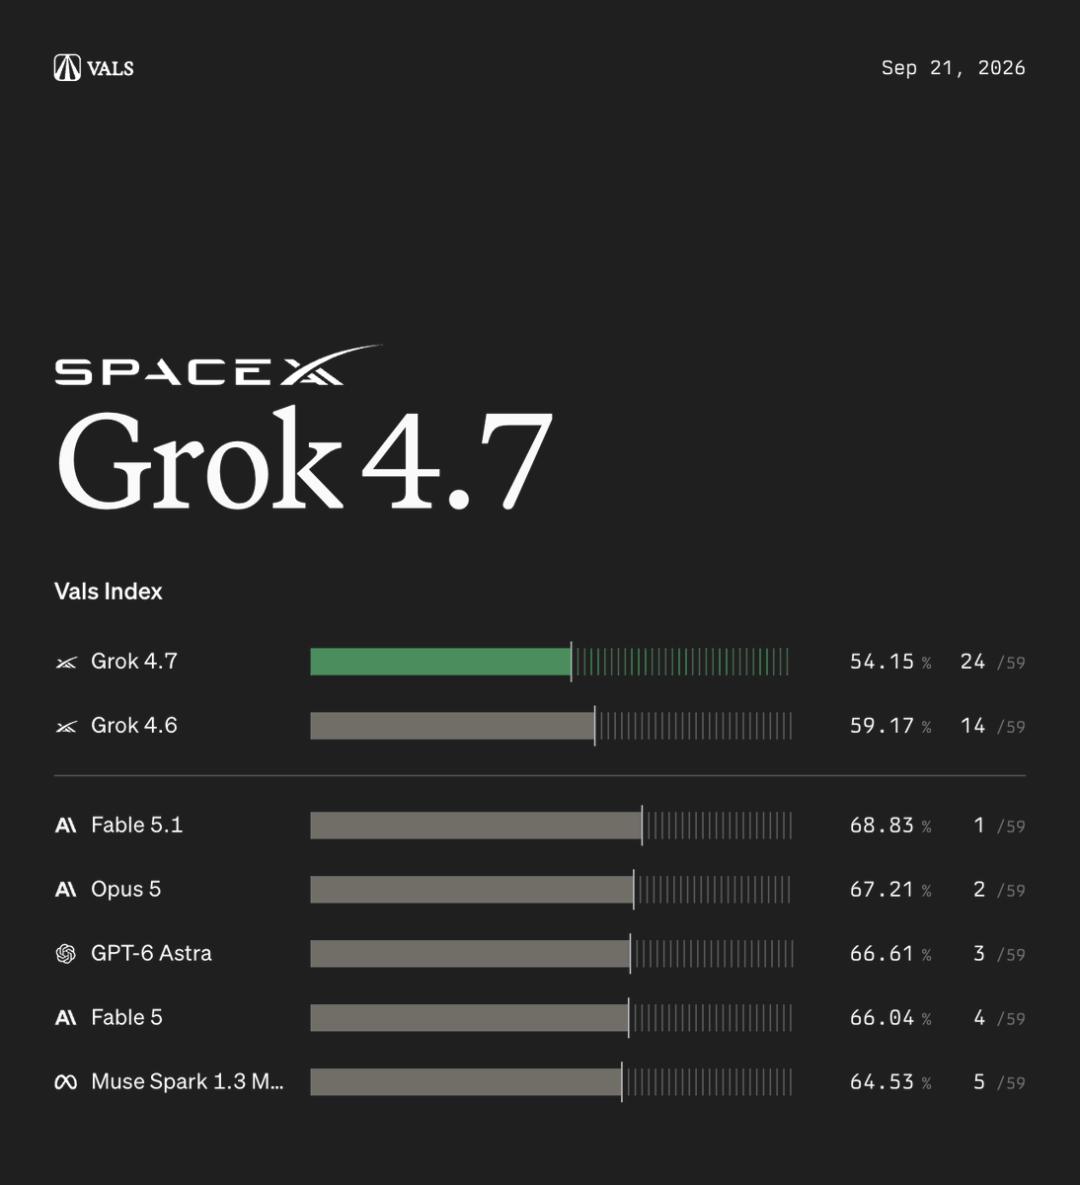
不过,在评测机构ValsAI这里,Grok 4.7不升反降,直接从第14名一路跌到第24名,比上一代4.6还倒挂了5分。
马斯克为什么要拼命给Build框架站台?答案就藏在官方公告的附注里——
Grok4.7在预训练阶段,深度对齐了GrokBot框架的交互模式。
换句话说,它极度依赖自家工具的调用逻辑和任务拆解套路。一旦走出温室,战斗力瞬间打折。
知识能力,也非常能打
这次升级的另一块重点,便是离所有人更近的一个场景——办公。
在长流程知识工作测试AA-Briefcase中,Grok 4.7拿到1657 Elo,比Grok 4.6的High档增加111分。
在GDPval-AA上,它拿到1695 Elo,比上一代高出90分。
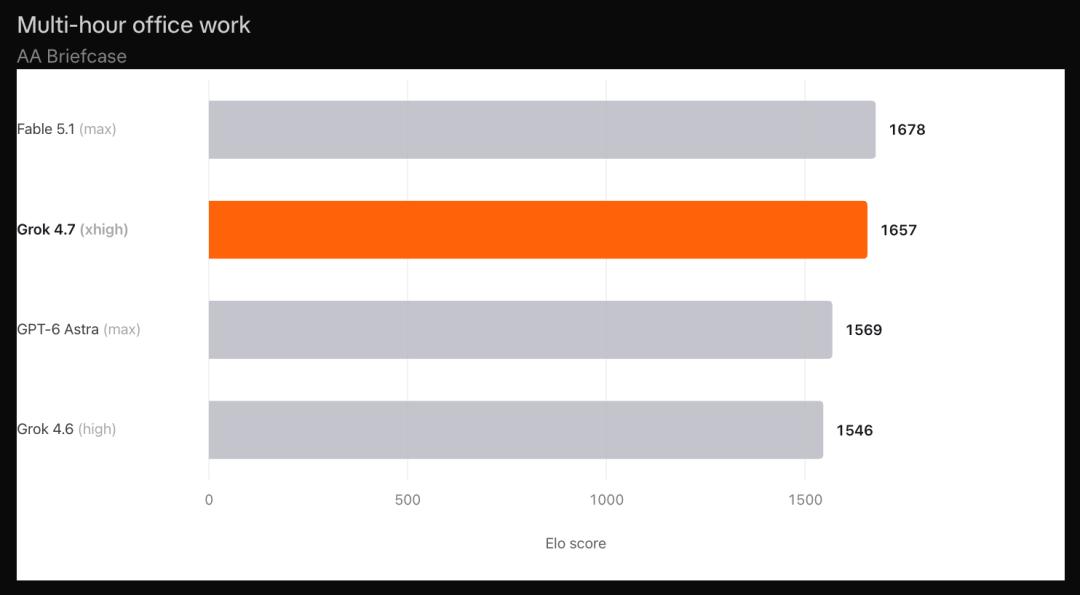
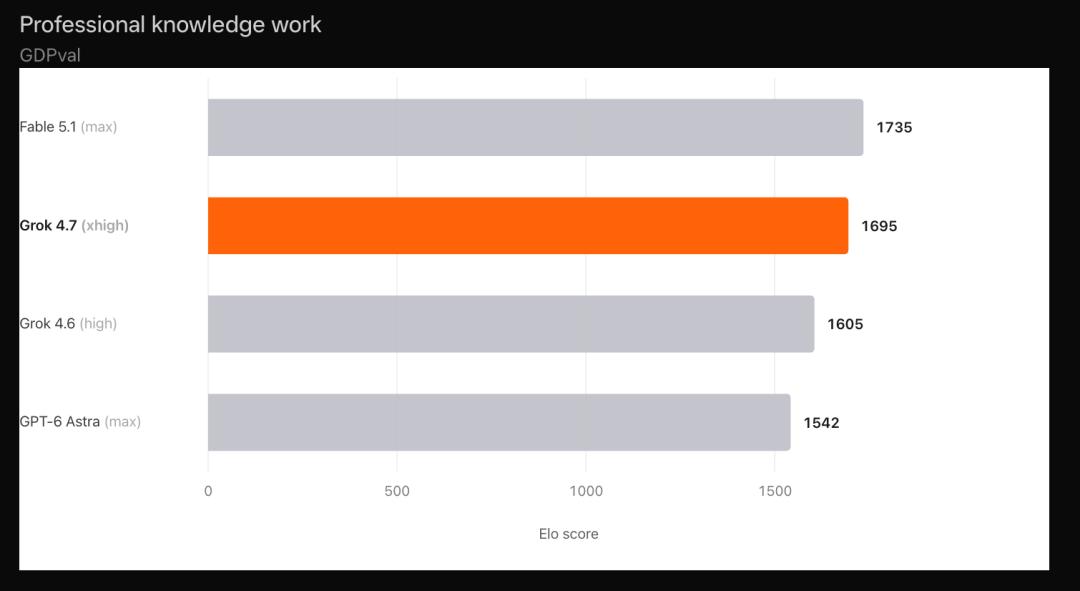
这些任务看重的,是AI到底能不能帮专业的人把活儿干完、交出像样的东西。
比如,整理材料、制作文档、完成分析与演示文稿,Grok 4.7明显比上一代大幅提升。
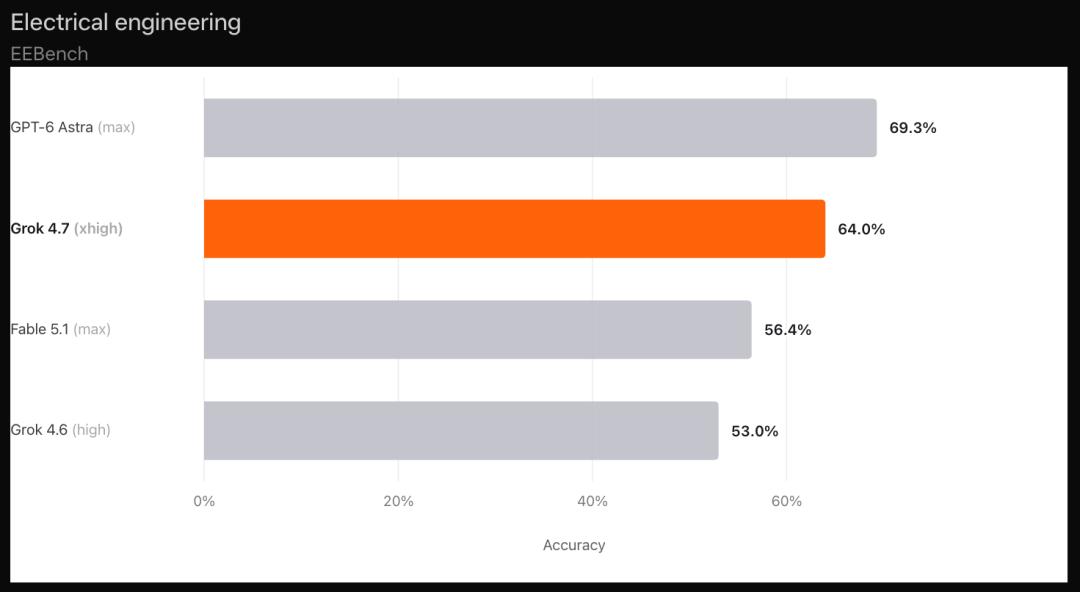
此外,在电气工程测试EEBench上,Grok 4.7拿下64.0%,在所列四款模型中最高。
全网首测,有惊喜也有翻车
Grok 4.7一上线,不少人早就摩拳擦掌,上手尝鲜了。
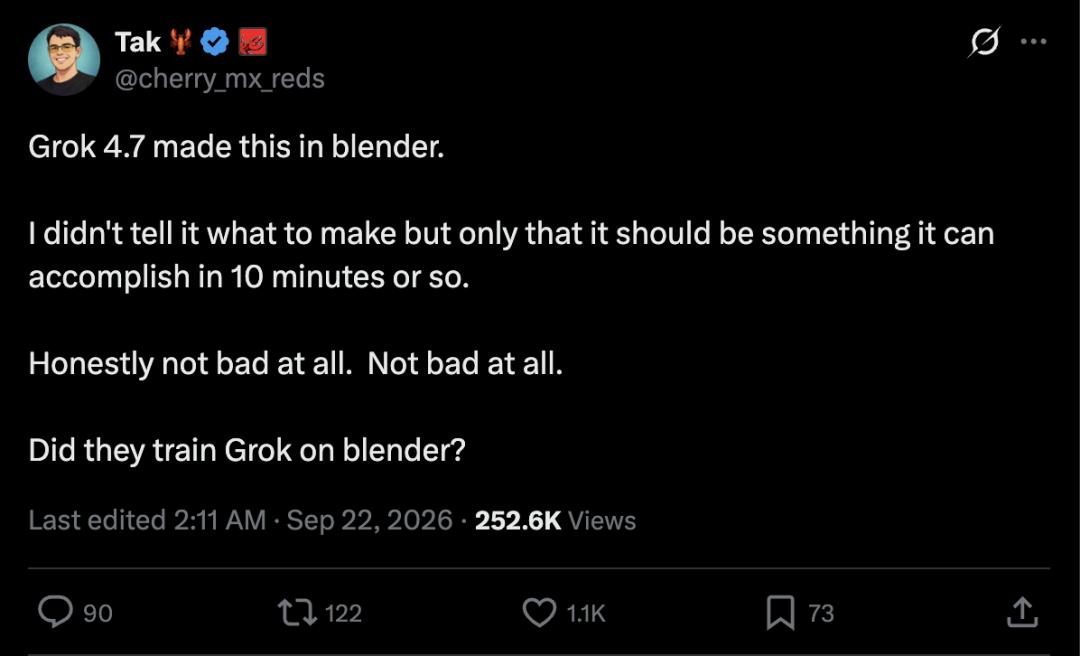
最出圈的一个demo,来自开发者Tak。
他压根没给Grok 4.7具体要求,就留了一句「你10分钟内能做啥就做啥」。
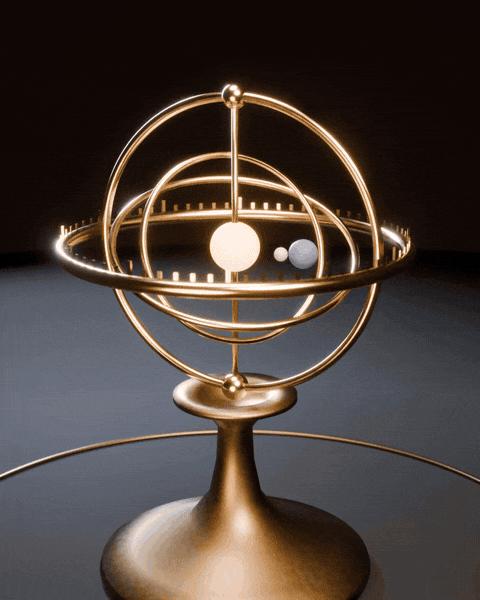
结果 Grok 自己跑去 Blender 里搓了个黄铜浑天仪,上面的行星甚至还能转,引全网25万人围观。
Tak本人点评,「讲真,一点也不差」。
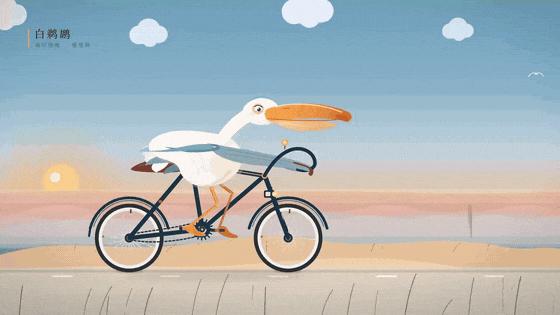
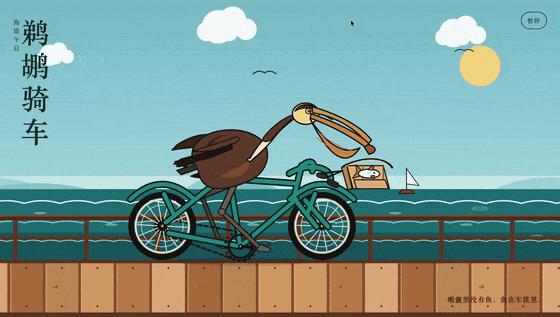
然后是经典节目,鹈鹕骑自行车。
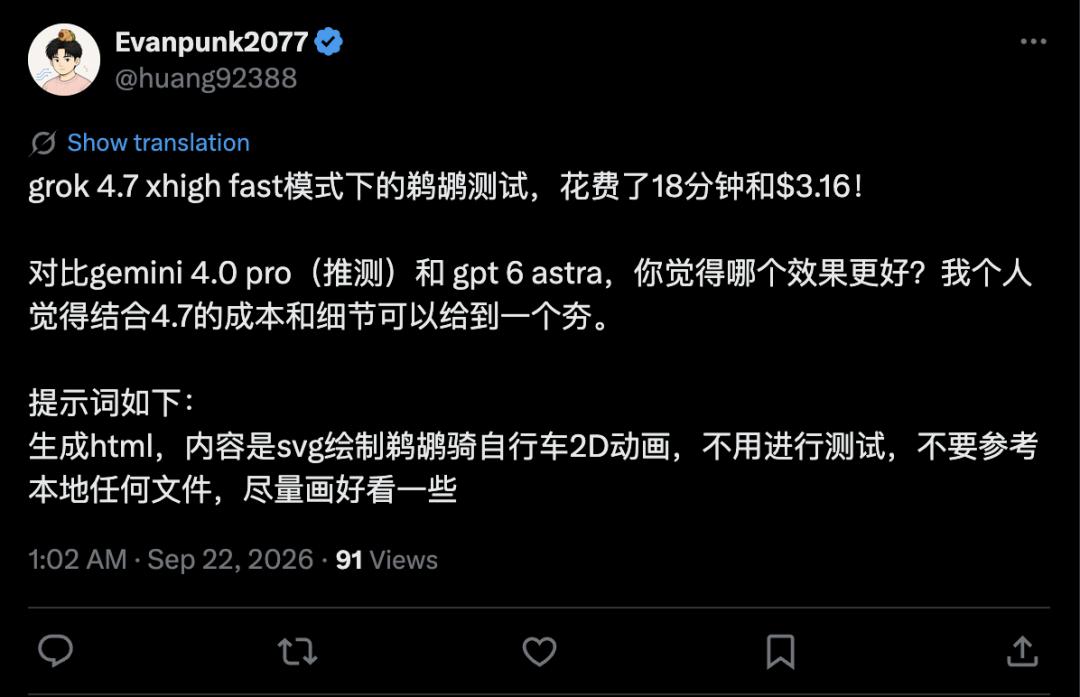
有人直接拉满配置,开了xhigh加fast模式开跑,烧了整整18分钟,3.16美元。
结果出片还真像那么回事,白鹈鹕在海边骑车,翅膀搭在车把上。
另一个人跑出来的就拉胯多了,生成的棕色鸟直接瘫在自行车上。
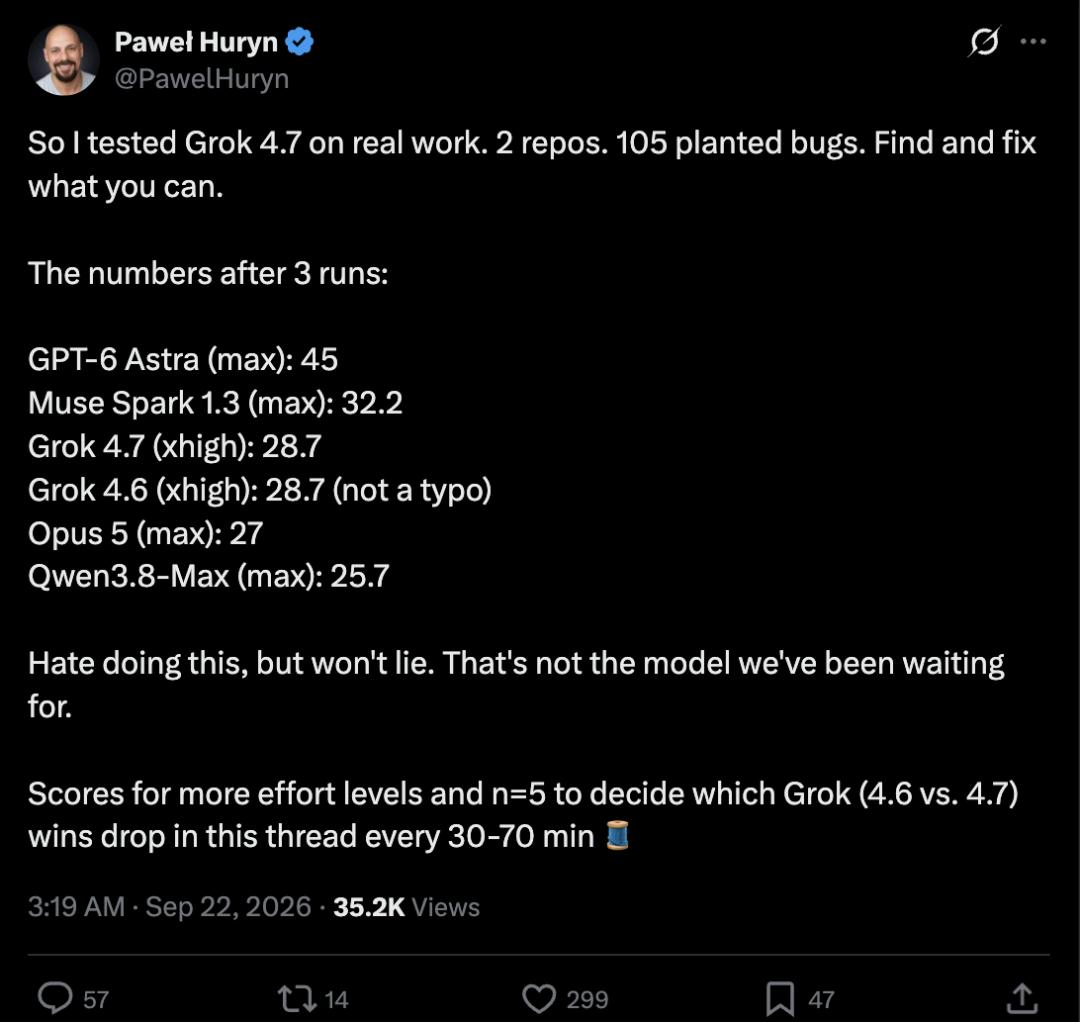
产品博主Paweł Huryn拿了两个真实代码库、埋了105个bug测了三轮。
结果是,GPT-6 Astra能修好45个;Grok 4.7搞定了28.7个。戏剧性的是,上一代Grok 4.6也是28.7个。
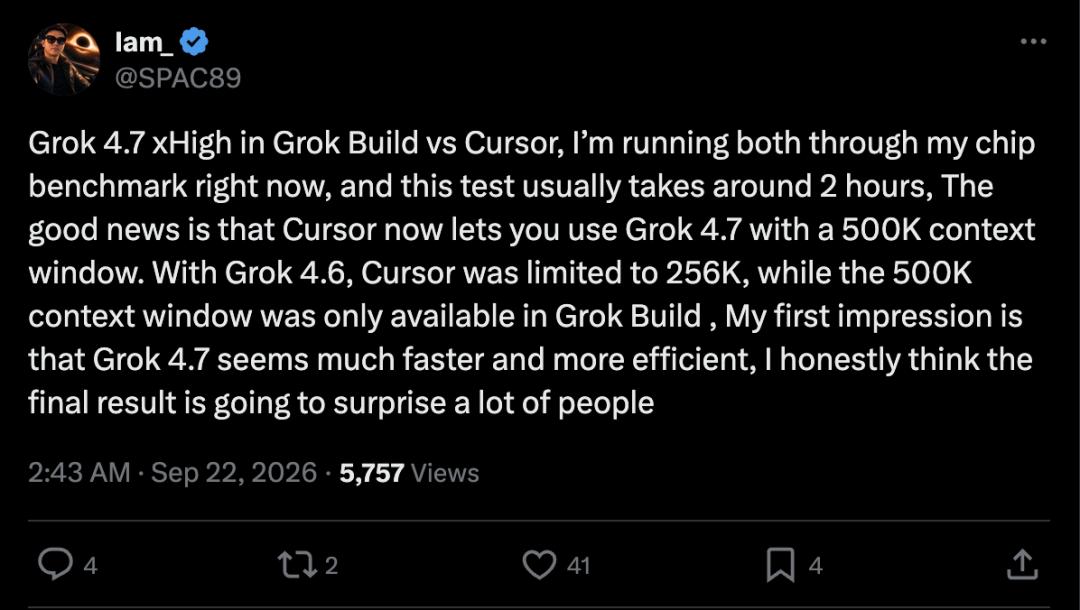
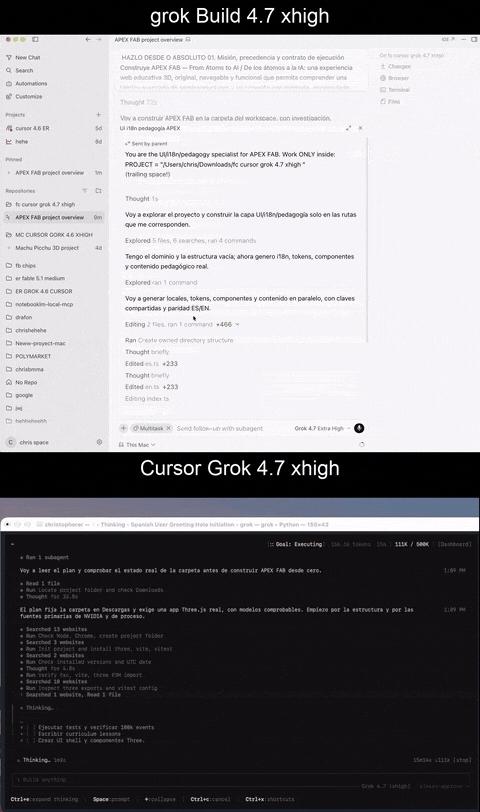
还有人直接上了硬碰硬的对照试验:把同一个芯片项目,同时甩给Grok Build和Cursor里的Grok 4.7。
整整两小时,测下来最直观的感觉就是四个字:又快又省。
顺带还扒出个新彩蛋,Cursor 居然悄悄把Grok 4.7的上下文顶到了500K,要知道上一代4.6可只有256K。
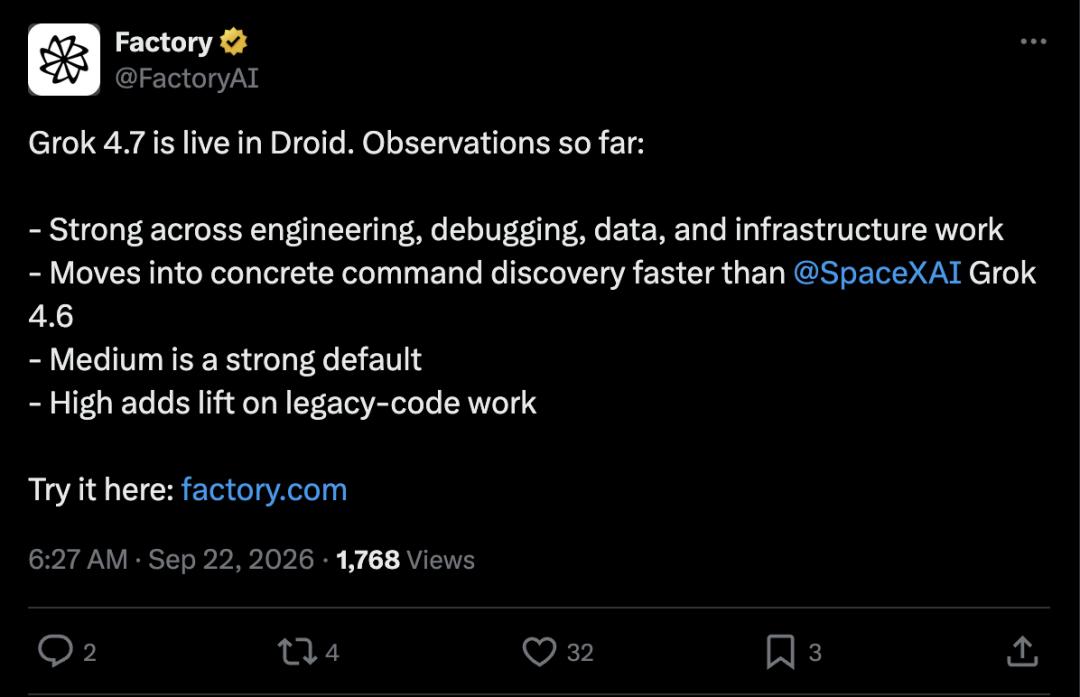
做编程Agent的Factory也第一时间接进了自家的Droid,给的评价比较克制。
工程、调试、数据、基础设施的活都能干,找命令比4.6快,medium档够用,high档在老代码上有加成。
定价便宜五倍,一算总账却遭背刺
这次,Grok 4.7官宣的另一大亮点,是价格是同类一半。
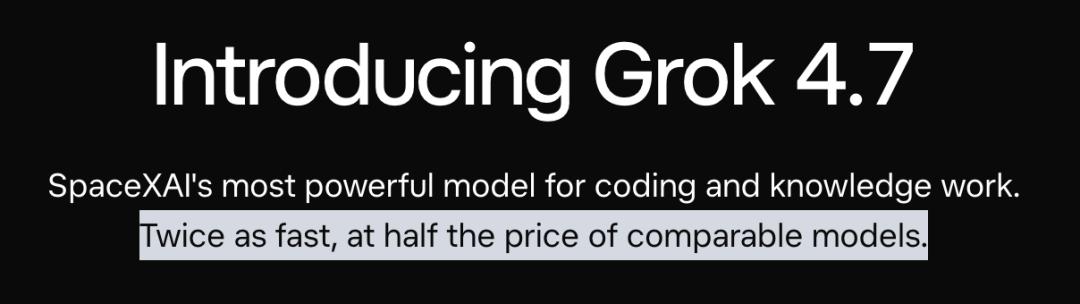
不得不说,她的单价确实诱人:输入2美元、输出6美元。
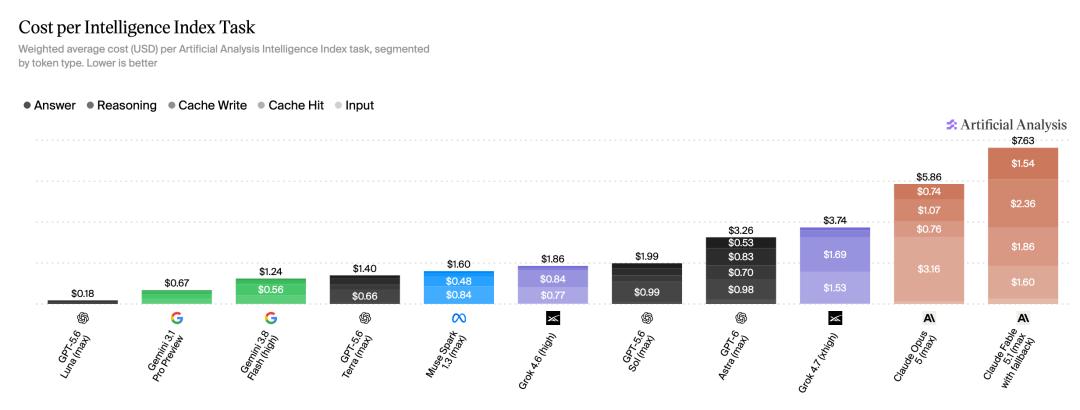
对比Astra和Fable动辄10刀输入、50刀输出的刺客价格,Grok单价便宜了5到8倍。
官方晒出的Cursor Bench 4.0性价比曲线上,Grok 4.7最高档拿下46.3%,解一道题成本6.01美元;Fable 5.1中档46.8%,一道题7.05美元。看上去像是一场平分秋色的精准狙击。
但只要拿放大镜扫一眼图表底部的细节,这笔账就全变味了。
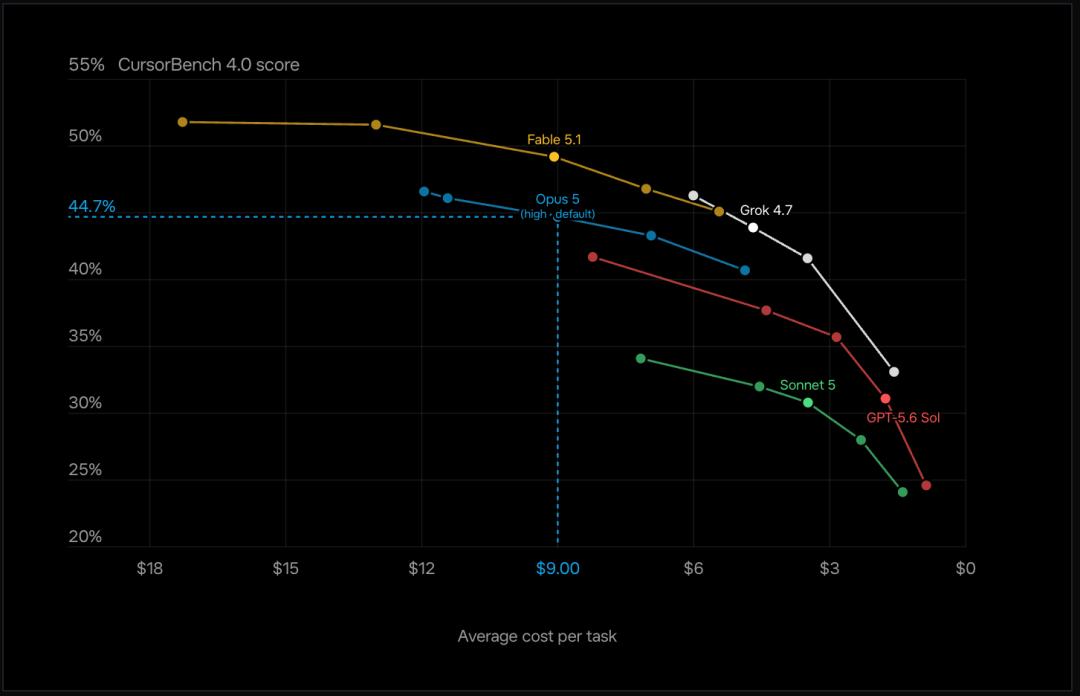
Fable 5.1低档跑出45.1%,单题成本只要5.44美元,比Grok的最高档还要便宜;而上一代的GPT-5.6 Sol高档拿下35.7%,单题只需2.85美元。
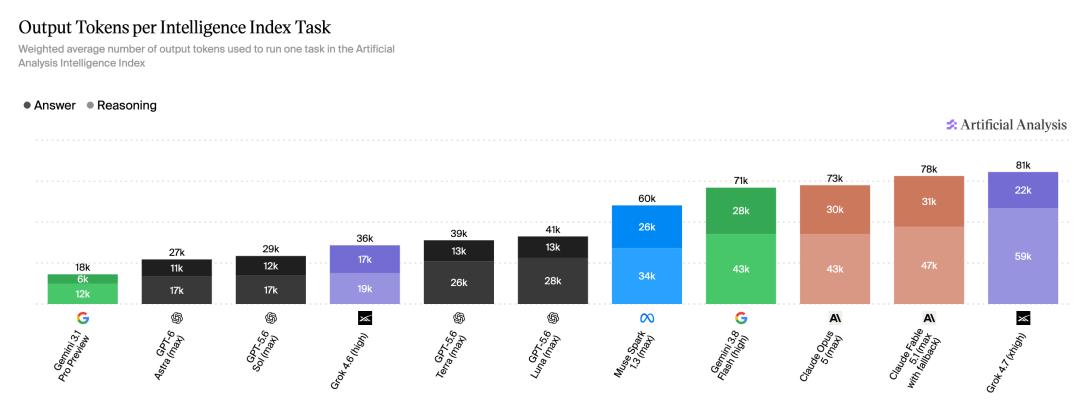
玄机依然在于那惊人的「话痨体质」。
8.1万输出token,几乎是GPT-6 Astra的三倍。单价便宜5倍,但废话多了3倍,实际账单优势被生生腰斩。
Hacker News上有开发者算清总账后吐槽:Grok 4.7的缓存读取单价甚至反超了Sol。
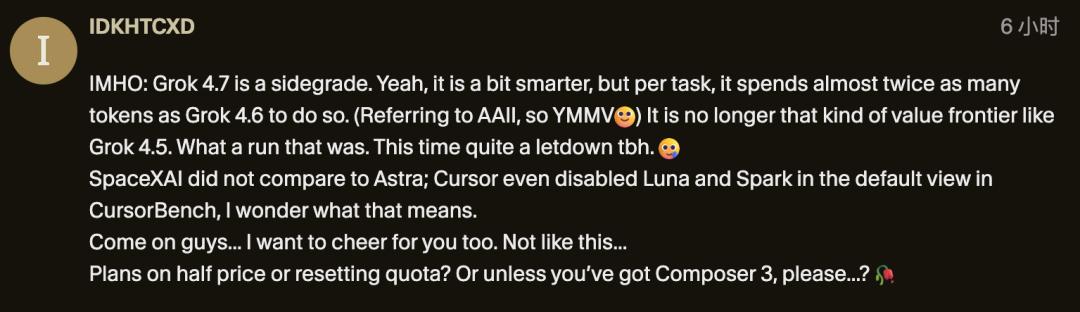
Cursor社区更是直接破防:「这根本不是什么划时代的性价比怪物,花掉的token几乎是4.6的两倍,4.5时代那种极致廉价感彻底没了。」
不过在纯速度上,它确实快得凶残。
AA实测每秒狂飙188个token,fast模式更是原地翻倍。
模型加框架,才是下一个战场
如今再看Grok 4.7的战术意图,已经彻底明牌。
它不打算碰AGI的绝对王座,而是退守前沿第二梯队,卡住最便宜、最快的高地,专打性价比。
但这场发布暴露出的真正行业趋势——单体模型的时代,正在过去。
Grok 4.7的高分,有一大半是靠着Grok Build的量身定制硬顶上去的;一旦脱离自家的脚手架,分数立马露馅。
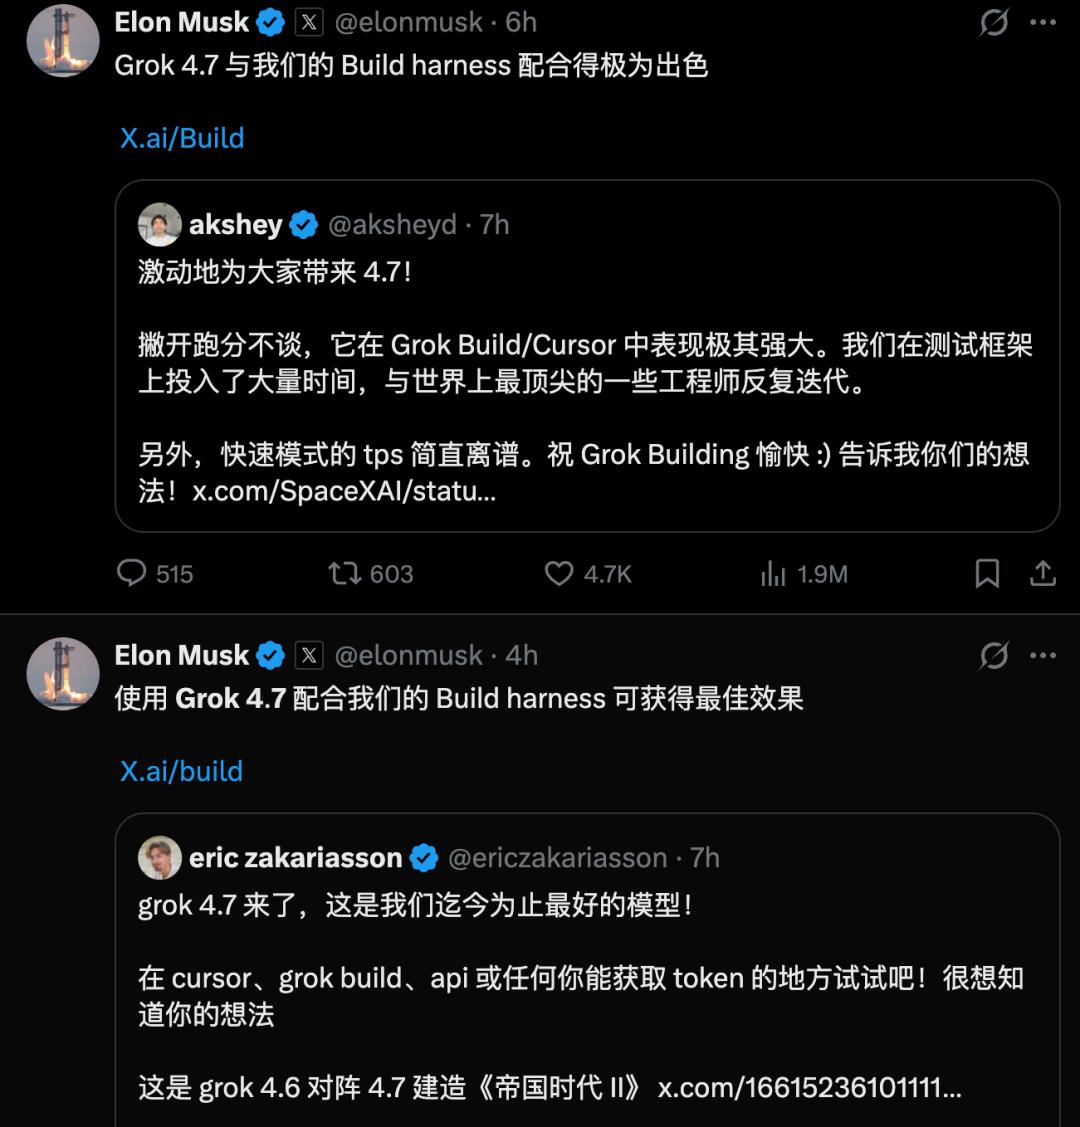
Anthropic用Claude Code锁死长程任务,OpenAI用Codex把持生态,xAI也终于走上了用私有框架捆绑开发者的路子。
未来的第三方评测榜单将彻底失去纯粹性,以后再看到所谓的跑分排名,第一句话必须先问:
你到底是用什么框架测的?
参考资料
https://x.com/SpaceXAI/status/2102069815225586149
https://x.ai/news/grok-4-7
