

 搜索


Hoodline 在 9 月 18 日报道了一个有意思的故事:美联航的客服聊天机器人告诉客户 Alison Gil,她价值 200 美元的旅行积分将在存入之日起五年内有效。但联合航空随后告知她,该积分实际将于 2026 年 9 月 27 日到期。最后美联航承认了聊天机器人的错误,并向 Gil 发送了一张替代旅行证书。
看起来,Agent 刚走入企业,风险就已呼之欲出: AI 给出错误答案,但表示"没问题"“相信我”,哪怕是相对成熟的客服机器人领域,问题也依旧存在。
这类失控有多普遍?据 Gartner 2025 年 6 月官方新闻稿预测,超过 40% 的 Agentic AI 项目将在 2027 年底前被取消,原因之一便是风险控制不足。
Scale AI 在论文《READY》中写得更直白:"一个 AI Agent 可以在基准测试上表现出色,却仍不适合部署。"
许多企业习惯在采购环节,优先评估模型选用问题,因为直觉告诉我们能力的瓶颈在模型。但行业实践讲了一个不同的故事——
于 AI 企业级部署而言,模型只能代表能力,外围系统才是生产力。
1 行业在卷"怎么造",但还有个问题没人答
2026 年,围绕"模型之外还需要什么"这个问题,行业先后给出了数个新概念,包括:
Harness Engineering(驭具工程)。
2026 年初,HashiCorp 联合创始人 Mitchell Hashimoto 在博文中命名了这个概念,随后 Anthropic、Thoughtworks、LangChain 扩展传播。核心主张:Agent = Model + Harness。模型外面那层运行壳——循环控制、工具调度、记忆、护栏、沙箱——才是把能力变成可用性的关键。据 BCG 9 月 15 日发布的报告,驭具工程"围绕 AI Agent 创建了一个类似个人电脑操作系统的五部分结构,从而建立有效的治理、问责与适当的控制"。
Graph Engineering(图编排工程)。
年中,当单 Agent 的循环不够用时,行业开始讨论把多个 Agent 编排成图——节点是 Agent,边是数据流与控制流。据 8 月 26 日发布在 arXiv 的论文《Graph Engineering in the Era of LLM Agents》,图编排工程"在单个 Agent 的基础上,通过任务组织、Agent 协调和运行时状态管理,赋能系统级智能"。
Harness 解决了"一个 Agent 怎么稳定运行"。Graph 解决了"多个 Agent 怎么协作"。
但两者回答的都是"怎么造"。还有一个更根本的问题悬而未决:你怎么知道造对了?上线之后,怎么保证还对?
2 Agent DLC:从"怎么造"到"凭什么上线"
SymphonyAI CEO Sanjay Dhawan 的判断很直接:"一个通用 Agent 在受控条件下可以看起来令人印象深刻。但一旦进入企业运营,面对那些对一线工作者来说显而易见、对模型来说却完全不可见的约束、依赖关系和判断力要求,它就开始吃力了。"
OpenAI 成立了专门的部署公司,微软以巨额资金、人力注入 Microsoft Frontier Company,而亚马逊云科技则投入 10 亿美元建设前置部署工程(FDE)。三大巨头同时把重金压向"部署",本身就说明了问题——模型造出来之后到上线之间,存在一条巨大的鸿沟。
一切都是恰逢其时。
在刚刚结束的 GTLC 全球技术领导力峰会 · 上海站上,亚马逊云科技架构师经理吴迦德做了一场 Keynote 分享,内容是围绕白皮书《企业生产级智能体开发部署指南》展开的解读与实践。该白皮书由亚马逊云科技在 2026 年 6 月发布,其中提出 Agent DLC(Agent Development Lifecycle)概念——从公开的互联网信息来看,这是业内第一套以"评估"为圆心、完整覆盖 Agent 从定义到持续改进全生命周期的系统性方法论。
Agent DLC 的核心机制可以概括为:放行由评估决定。判据达标即放行、未达标返工。不由人在会上拍板。
这很像传统软件的 CI/CD 流水线,代码提交后自动跑测试,测试通过才合入主干、才能发布。Agent DLC 做的事情类似,但对象从代码换成了 Agent 的行为。
Agent DLC 包含六个环节——定义、构建、评估、发布、观测、回流——围成一个持续转动的闭环。其中"发布"是门。门前,团队在"定义-构建-评估"三个环节之间高频往复,一次上线前可能迭代几十上百轮。
门后,"观测"和"回流"持续运行:生产中遇到的新边界情况、新的失败模式,被自动采集回来,补充到黄金标准里,让下一轮评估更贴近真实世界。
所谓的黄金标准是什么?
黄金标准由两部分构成。第一部分是评估规范——定义"什么算对",即五个维度的判据和三档门槛;第二部分是黄金轨迹集——这是一套确定的、可复现的数据集,有基线 accuracy,用于回归测试,由生产链路追踪,持续回流补充。
二者共同构成了企业在 Agent 落地过程中积累的差异化资产。我们重点展开聊聊评估规范的内容。
评估规范可以粗略理解为一张判据表——它把团队对 Agent 的每一项要求,从"能理解客户意图"到"不能编造信息"到"单次调用成本不超过 X 元",全部转化为可以自动测量的判据。
平台可以换,模型可以换,但这份编码了全部真实失效方式和业务判断的标准,是企业从零构建并可以持续复用的。
判据沿五个维度设置:
- 认知——Agent 是否真懂业务,包括意图识别、别名理解、多跳关系、工具选择;
- 质量——输出是否可靠,包括正确、完整、一致、忠实;
- 责任——安全合规能否管住,包括越权、隐私、拒答边界、对抗注入、审计链;
- 成本——token 花在哪,有没有数;
- 性能——响应速度与并发稳定性。
每条判据还分三档:
- 红线要求 100% 通过,一票否决;
- 门禁要求达到设定的阈值;
- 观测只要求有基线可比即可。
三档必须在跑第一次评估之前冻结,避免"先看分数再定标准"的自我安慰。
有一点值得特别说明:五个维度是"评估"的坐标系,不是"构建"的组件清单。构建期搭建的是检索管线、提示词、工具定义这些工程能力;评估期则用对应维度的评估器去度量这些能力的效果。一个维度可能牵涉多项工程能力,一项工程能力也可能影响多个维度。理解这个"多对多"关系,才不会把评估做成走过场的清单打勾。
3 评估:最重要,也最容易做错的一环
评估,恐怕是 Agent DLC 六个环节中,最值得单独聊聊的部分。
原因有三。
第一,评估是整条链上唯一同时承担"质量判断"和"放行决策"双重角色的环节——它既要给出分数,又要依据分数做出"放行还是打回"的决定,任何偏差都会直接传递到生产环境。
第二,传统软件测试有确定性的对错——函数返回值要么等于预期、要么不等于。但 Agent 的输出是自然语言和多步行为的组合,同一个问题的正确回答可能有无数种表达方式,"什么算对"本身就需要被定义和校准。
第三,也是最容易被低估的一点:评估本身依赖 LLM 做裁判,而裁判模型自己也会犯错。如果你的评估体系有系统性偏差,跑出来的分数越好看,你离真实世界越远。
如果评估做错了,整条 Agent DLC 就空转了——我们以为系统在持续改进,其实是在持续自欺。
白皮书中记录了一个真实教训:团队用 Correctness(正确性)评估器跑了 13 条用例,结果全部零分。深查之后发现——裁判模型的知识截止时点早于被评内容,等于拿一把过期的尺子去量新的东西。把评估方法换成 Faithfulness(忠实性,相对于“幻觉”而言)后,同样 13 条用例,全部通过。
这两个指标有本质区别。Correctness 问的是"答案对不对",需要裁判自身具备正确知识。Faithfulness 问的是"回答里的断言有没有被上下文支撑"——裁判不需要自己懂,只需要对照材料检查。
白皮书列出了四种偏差及其对策:
- 位置偏差——交换两个答案的先后顺序,裁判的判决就翻转,对策是两种顺序都跑一遍,只取结论一致的。
- 冗长偏差——更长的回答被打高分,对策是在评分标尺中声明"长度不加分"。
- 自我偏好——裁判偏爱与自身风格相近的回答,对策是换不同厂商的裁判模型交叉验证。
- 分辨率过粗——分数全部堆在中间档,对策是改用两两比较替代打分。
关于校准门槛,白皮书也给了一条硬线:裁判模型与人的一致率,要达到人与人之间的一致率水平。 达不到,就不能把裁判当自动化工具来用。
当然,仅有宽泛框架,白皮书仍然脱离不开讲“大道理”的嫌疑。亚马逊云科技比较务实的一点,在于在《企业生产级智能体开发部署指南》中提供了具体工具。比如:
1. 四格二分法——快速定位 Agent 出错的根因。
Agent 做错了,到底是检索的问题还是生成的问题?这是修复前必须回答的第一个问题。白皮书给出了一个按顺序排查的方法——依次问四个问题,第一个答"否"的地方就是根因。
先问"该取的取到了吗",对应 context recall,查检索侧。如果取到了,再问"是照着资料答的吗",对应 faithfulness,查生成侧。如果照着答了,再问"资料本身对吗",对应 correctness,查知识库。如果资料也没问题,最后问"答的是所问吗",对应 response relevance,回到认知维查意图理解。
这里有一个容易踩的坑:faithfulness 只问"回答里的断言有没有被上下文支撑",不问"上下文里有没有该有的东西"——后者是 recall 的事。两个指标必须搭配使用,少了任何一个,排查链条就断了。
三级归因——把"不通过"变成"改哪里"。
评估告诉你"不通过"。然后呢?"不通过"本身不可执行——你需要知道"改哪里"。白皮书将归因拆为三级,每一级指向完全不同的修复方向。
会话级:Agent 前后矛盾、遗忘自己的身份或目标——需要修目标管理与记忆机制。轨迹级:检索了错误的知识库、工具调用次序不对——需要修检索管线与工具编排。步骤级:某一步的入参类型错误、单步推理逻辑有误——需要修具体提示词或参数。
没有分层归因,评估的结论就停在"分数低"三个字上,无法转化为工程行动。
关于成本的诚实交代
评估有价值,评估也有成本。白皮书坦率地指出:评估器本身是成本大头——每一条 trace 过一遍裁判模型,就是一次独立的 LLM 调用。如果用 simulation(模拟测试),还要加上 actor 的调用费。规模化在线评估前,必须先算清楚这笔账。
同时,合格标准是通过率,不是二元判定。同一个问题每次措辞不同,Agent 的回答可能都对但表达各异。合格线由业务方定,不同场景的容忍度天差地别——编码助手允许反复尝试,但客服每五次错一次,就意味着每第五位客户遭遇一次真实失败。
修复优先级,白皮书给了一条明确的路径:先确认分数本身可信,再查数据质量,再调提示词,最后才换模型。多数提升来自提示词、工具描述与检索策略,而非更换模型。
4 Agent DLC 的落地支撑与案例
上升到全局来看,评估器、运行时、可观测链路、三级归因、A/B 测试、金丝雀发布——Agent DLC 的每一环都需要基础设施支撑。如果全部自建,周期以月计,且中小企业难以承受开销。
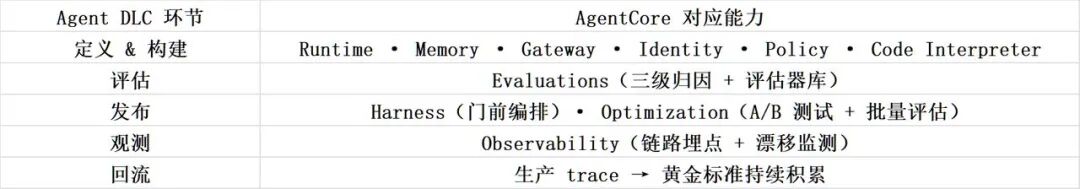
Agent DLC 的每一环都能在 AgentCore 上找到对应的托管能力。它允许企业把力气花在判据设计和黄金标准这类差异化资产上,把评估器、运行时、可观测这类重复劳动交出去。
我们可以通过一张表看清 AgentCore 的覆盖面:
AgentCore 是不绑框架的,CrewAI、LangGraph、LlamaIndex、Google ADK、OpenAI Agents SDK、Strands、自定义框架均可接入。它同样也不绑模型,协议支持 MCP 与 A2A。
作为 AgentCore 的用户,英国二手车拍卖平台 Motorway 将错误结果从每 8 次出现 1 次降低到每 50 次出现 1 次,工具选择准确率从 87% 提升到 98%。服务全球 8 亿用户的创意平台 Fotor(成都恒图科技)将流程耗时从分钟级压缩到秒级,Fotor 新一代 Agent 架构的上线周期缩短到了 1 天。
巴西医疗集团 Rede Mater Dei 则把工具选择准确性提升了 38 个百分点,4 个月内实现 517% 的投资回报。Cox Automotive 用不到一年时间将 17 个智能体投入生产。
更多技术细节和实施案例,你可以下载亚马逊云科技白皮书《企业生产级智能体开发部署指南》(https://aws.amazon.com/cn/events/summits/shanghai/guide-to-developing-and-deploying-production-ready-enterprise-ai-agents/)仔细阅读全文。
没有任何系统能保证零失误。Agent DLC 要做的,是让错误在造成后果之前被发现。
"发布前,以标准考核 Agent;发布后,以世界考核标准。"
这句话来自白皮书。也适用于每一个正在把 Agent 推向生产的团队。
