

 搜索


行业欣欣向荣的一片混乱中,要先出发。
从 6 月 11 日官宣接任钉钉 CEO,到 9 月 22 日云栖大会公开演讲,1992 年的陈宇森度过了「临危受命」的 100 天。
这 100 天的改变紧锣密鼓,先是 6 月钉钉的组织调整;接着是 7 月阿里内部赛马结束,
9 月 22 日云栖大会的
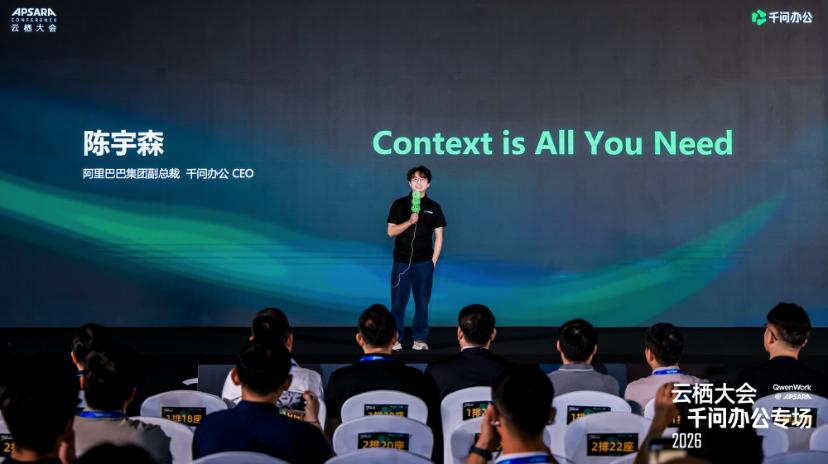
陈宇森演讲的题目是《Context is All You Need》,「Context」在办公场景下特指企业日常海量的文档、邮件、会议记录和聊天历史,所以翻译成大白话:上下文就是一切。
「
陈宇森发布的核心之一,是面向企业的上下文数据管理的产品「企业上下文」,将企业文档、会议、群聊等过去被称为「隐性知识」的数据结构化连接,并逐层压缩,按需提取给 Agent 使用。基于企业上下文产品和
另外一个亮点是 AI 走进物理世界,陈宇森发布了 Agent 硬件 QwenNote A2。相比之前的钉钉录音卡 A1 ,A2 核心是通过语音转写随时随地记录各类场景中的信息,也可通过语音调用
「我们服务了大量使用飞书和企业微信的客户,这会是未来
云栖大会中,
以下内容为对话精选,经过编辑:
蓝洞商业:
束骏亮:我们之前内部也讨论过,有一个非常有意思的词可以形容现在整个 AI Agent 的行业发展状态——「欣欣向荣的一片混乱」。
大家都觉得很有干劲,这场仗非常有打头,AI Agent 非常新鲜有意思。很多企业很愿意拥抱 AI Agent,但是他对于自己需要什么样的 AI 也没有想得很清楚。
在这样一个市场竞争状态下面,有一些混乱肯定是存在的。这跟以前创业一样,不管船能开多远,你要先开出去,哪怕它是个破船,你可以一边开一边修,但是重要的是要先出发。
从这个角度上来讲,过去两个月(我们)做的还是很不错的,出发的也比较快,是几个大厂里面整合的相对比较早的,也在第一时间拿出产品,也在市场上获得了第一波的口碑,并且今天我们仍然能够以一个非常高的频率去掏出新的东西来。从这个视角上来说,我还是挺满意的。
大厂竞争我觉得还没有看到真正的赛点,包括底层技术和用户需求的变化还是比较快的,如果说现在一定要找一个赛点的话,可能就是企业客户的选择,到底有多少头部大客户选择了你,以及多少的小商户范围内选择了你,客户的选择永远是第一位的,而不是说我今天有多少声量。
1、谈硬件:硬件是连接数字世界和物理世界的桥梁
提问:今天发布了 QwenNote A2 这样的硬件,行业里做 AI 办公产品和硬件联动,大家有什么共识?
束骏亮:这件事的共识,就像今天宇森演讲时我们反复强调的那句话——「Context is All You Need」。AI Agent 行业发展到现在,很多技术已经慢慢趋同,决定一个Agent 能不能很好地理解一个人、理解一个行业去完成任务的核心点,就在于你给它推理时,给它多少上下文。
从这个角度出发,我们认为硬件是一个非常好的上下文增量收集入口。我们过去做这一类产品,是在电脑、在软件层面去解决上下文,比如文档。事实上,现在的AI 硬件发展得越来越成熟,硬件是我们连接数字世界和物理世界的桥梁。通过这样的硬件,比如今天发布的 Qwen A2,它能够把日常对话转化成 Agent 能够理解、能够沉淀下来的文本上下文。
未来我们还会有更多跟硬件的联合,比如眼镜和其他一系列硬件,能够把更多物理世界的信息变成 Agent 可利用的上下文。
提问:除了 Note 以外,还发了一款桌面机器人 Eva。做桌面机器人这件事上又有什么共识?
束骏亮:硬件一方面解决上下文的来源;另一方面不仅仅是桌面机器人,Qwen A2 还有一个功能——能从硬件上唤起 Agent。我觉得这可能是另一个共识,至少我们是这么认为的:我能在什么样的场景下唤起这个Agent,对用户体验是非常重要的一件事。
平常我们要用 Agent,得打开电脑、手机,不是那么顺畅、那么随心所欲。假设我手头有一个硬件,就放在电脑面前,我只要跟它说「嗨,Eva」,它就能得到我的指令。
我们又打通了跟
提问:硬件方面的布局和规划是怎样的,之后还有哪些硬件产品推出?会不会和外部厂商形成竞争?
束骏亮:目前来看,倒没有什么太多的竞争。我们内部硬件发展的方向比较收敛,有自己明确的目标。但像 A2 这样的产品,在市场上是有竞争对手的。
但你不可能把所有硬件都做了,对我们来说一定是自研+生态拓展的方向。硬件我们有两个比较大的探索方向:一个方向是,硬件会是我们收集更多上下文、呈现更多交互界面的入口,只要一个硬件能给我们不一样的上下文、能给用户呈现不一样的交互界面,我们都很愿意跟它合作;另一个方向是探索端侧模型落地的可能性,这也是今年下半年到明年上半年可能出现比较大亮点的地方。
比如现在
2、谈与钉钉的关系:传统软件和 AI 软件会找到各自的位置
提问:
束骏亮:传统软件仍然有它存在的价值,并且在中短期内的存在价值非常大。比如钉钉,它上面沉淀了大量的业务信息资产、客户逻辑。如果我今天因为有了新的产品,就强行要求所有钉钉用户把工作界面切换到
从长远来看,传统的各种各样的软件,可能会变成数据底座、变成上下文底座——它们沉淀数据,沉淀一些固化的、不能泛化的业务流程,我们都会在传统软件的范畴里把它解决掉,这也是有好处的。因为企业内部所有流程都靠 AI 解决,其实也不是很经济——我们知道 AI 有幻觉、AI 需要消耗 Token。
这样的话,传统软件跟 AI 软件都能够找到各自的位置,各自展现有优势的一面:你是流程跑得快、比较便宜、很稳定;我这边是泛化能力比较强,能够用自然语言交互。大家会是这样一种配合的关系。
提问:
束骏亮:从软件层面来说,哪个是入口,完全看这个时代怎么发展、看客户的需求。我们今天之所以在
我们也在钉钉内部做大量跟
我们目前看到的趋势是大家在互相做双向融合:一边是传统软件里要增加 AI 能力,一边是 AI 软件里要增加传统 SaaS 那种跟业务贴得更近的能力。这并不冲突,因为我们本身是一个团队,只是有两个产品——一个是过去的产品,一个是新的产品。它最终可能会在用户需求的推动下变成一个产品,也有可能两个产品继续发展、找到自身的段位,都有可能。
今天发布的所有功能,我们不再强调自己是一个个人 Agent。个人 Agent 做提效这件事已经解决得差不多了,模型能力提升的话可能会有进一步提升,但功能上我觉得差异不大。大家认同的一点是:真正的AI 能力要发挥价值、产生生产力的价值,还是在企业内部。
提问:你们对这个 AI 办公场景里的用户需求有哪些新的认知和洞察?
束骏亮:我的整个方法论还是从客户这边来。首先识别哪些是共性的需求,其次识别哪些东西能做成共性的功能。
客户是分层的。中小型客户更多关注这个东西是不是足够有性价比、是不是足够好用;但中大型客户关心足不足够安全、能不能被我所控、能不能做深度定制化。这其实是两条完全不同的路径。
对于大型企业客户,我们会把能力直接交到客户手里,甚至交到客户自己的部门或员工手里,因为他们有技术储备,可以为自己的企业做场景定制化;但更多时候面对中小客户,我们会选择跟生态合作伙伴一起做定制化的
我们现在观察到,客户非常愿意停留在老的协作场域里——没有问题,用户有需求,我们就去满足它。
3、谈上下文打通:上下文属于企业主体,不属于某个Agent
提问:上下文会是之后 AI 办公产品的核心竞争点吗?
束骏亮:我觉得肯定是。不仅仅是对于办公,对于任何 Agent 来说,上下文都是后面至关重要的一部分。
我们现在很明显地感受到两个矛盾点:第一个是数据来源的问题。数据来源在个人领域相对更困难一点:个人的数据目前分散在各种各样的 APP 里——你的微信、淘宝、美团,这里面有很多跟你个人相关的数据。这些地方的数据我能不能拿到,取决于这些公司向不向个人开放。目前我们还没有看到这个开放的趋势出现。
但反过来讲,企业内部是不一样的。企业里难的是数据量太多,而且数据之间的性质和前后的矛盾也非常多。在企业界,我们怎样去处理这些数据、怎样去抽象它,尤其是我的抽象算法到底能覆盖多少范畴——今天只能覆盖钉钉,还是又能覆盖钉钉又能覆盖飞书,还是能覆盖其他各种各样的软件——这其实是决定性的。这一块又会涉及很多技术细节:底层的计算能力、模型的能力。这也是个困难问题,但它看上去有解。
提问:企业上下文有没有一个机制,能帮助企业从非结构化数据里把这些主体属性提取出来?未来规划是什么?
束骏亮:我们真正要做的是:这个结构化数据必须是 AI 友好的,是 Agent 能够开箱即用的。假设它是个图——当然今天说的肯定不是图这么简单——你是在图上去探索的,图之间会有边,两个实体之间会有边。我们真正要做的是这样一种抽象,这个抽象不仅能把结构化数据抽象过来,也能把非结构化数据抽象过来。
假设一个企业今天过来,有一套算法抽象企业上下文要 10 天、花 100 万;但我现在有一个方案,只要 5000 元、3 天就可以做到。对企业来说,前者肯定不可行,后者就是一个非常好的方案。
从这个角度出发,又体现了整个阿里集团在全栈 AI 布局上的优势——不仅有芯片,还有模型。比如一个做奶茶的客户,他的企业上下文里有大量视频要处理,处理成千上万甚至上十万个视频段落时,标准的语言大模型是处理不了的,一定要多模态、理解能力非常强的模型,比如我们的Qwen3.8 Omni Flash,才能够快速、低成本地处理。这样一个模型的存在,就把这个场景从不可能变成可能。
随着底层模型的供给和能力越来越多,我们就能处理企业内部越来越多的非标、非结构化数据。处理的数据越多、覆盖度越广,企业上下文就越来越完整。我觉得这是这个过程中我们目前看到的、比较困难并且能够做出壁垒的东西。
提问:今天一直谈到上下文,
束骏亮:维度不应该是打通
我们提供的是企业级上下文的基础设施,是属于企业自己的。获取企业的信任,才符合业务逻辑:我的企业上下文肯定沉淀在自己这里,我有一个基础设施。大企业不会使用一个AI 产品,他一定也会自研一些AI 产品。这些AI 产品就不能从我的上下文里获取好处吗?这个东西就是新时代的数据基建,它跟数据库是一样的,只是它还没有像数据库那样标准化。
提问:AI 办公行业会不会出现智能驾驶领域的 L2、L3 这种级别,到什么级别之后可以让 AI 担责?
束骏亮:我们倒没有觉得现在一定要有 L2、L3、L4 这样一个约束去评价 AI 发展的等级——当然会有人去做,但我们对这个不是很感兴趣,我们更多还是希望能够解决问题。
安全问题一旦进入企业组织里,就是一个原则性问题。它不是说我删掉的这个东西、做的这个操作重不重要,而是这个操作本身有没有人为它负责,能不能追索,能不能判定。
所以我们今天做了大量安全性的功能:企业的管理员可以约束所有员工用 Agent 时能够访问哪些数据,让员工用 Agent 更安全;员工在自己的办公电脑上使用桌面级 Agent 时,也有一系列措施去约束。这在我们企业内部还是非常重要的。
