

 搜索


OpenAI 又给智能体加了一档速度。
根据官方更新日志,10 月 8 日,OpenAI 在 Responses API 中为 GPT-6.1 Sol 增加了 Ultrafast 极速模式,向所有 API 用户开放,使用仍受速率限制约束。开发者无需更换模型名称,只需在调用 gpt-6.1-sol 时,将服务档位设为 ultrafast,即可使用这一模式。
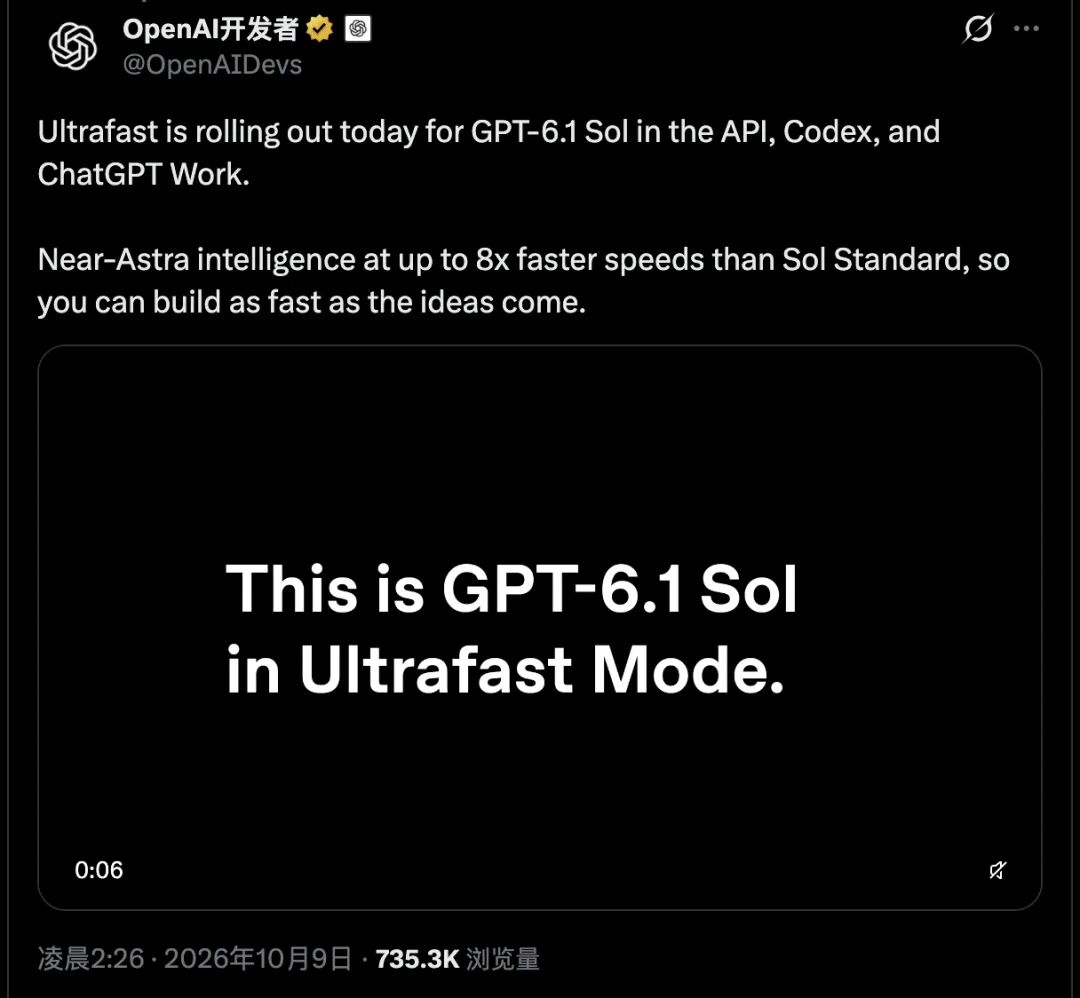
此次更新主要针对生成速度。
GPT-6.1 Sol 模型本身已于 9 月 29 日发布,因此,“极速版上线”更准确的含义,是已有模型新增了更快的服务档位。OpenAI 将 Ultrafast 定位为其最快的 API 服务档位,面向对延迟敏感、愿意为速度支付更高费用的工作。
价格也随之提高:GPT-6.1 Sol 极速模式的 API Token 单价为标准模式的 6 倍。这让此次更新的关注点从“模型有多聪明”,进一步转向“少等一会儿,究竟值多少钱”。
官方称性能接近 Astra
OpenAI 对 GPT-6.1 Sol 的定位是,在复杂编程、计算机操作和专业工作中,以更低成本提供接近 GPT-6 Astra 的表现。
事实上,GPT-6.1 Sol 模型在一些基准测试上的表现的确有很多亮眼的地方。
GPT-6.1 Sol 与 GPT-6 Sol 相比,它在复杂专业任务中的表现显著提升,涵盖代码编写与调试、文档理解以及多步骤业务工作流的执行。在其中多项评估中,它以显著更低的成本取得了接近 GPT-6 Astra 的表现。
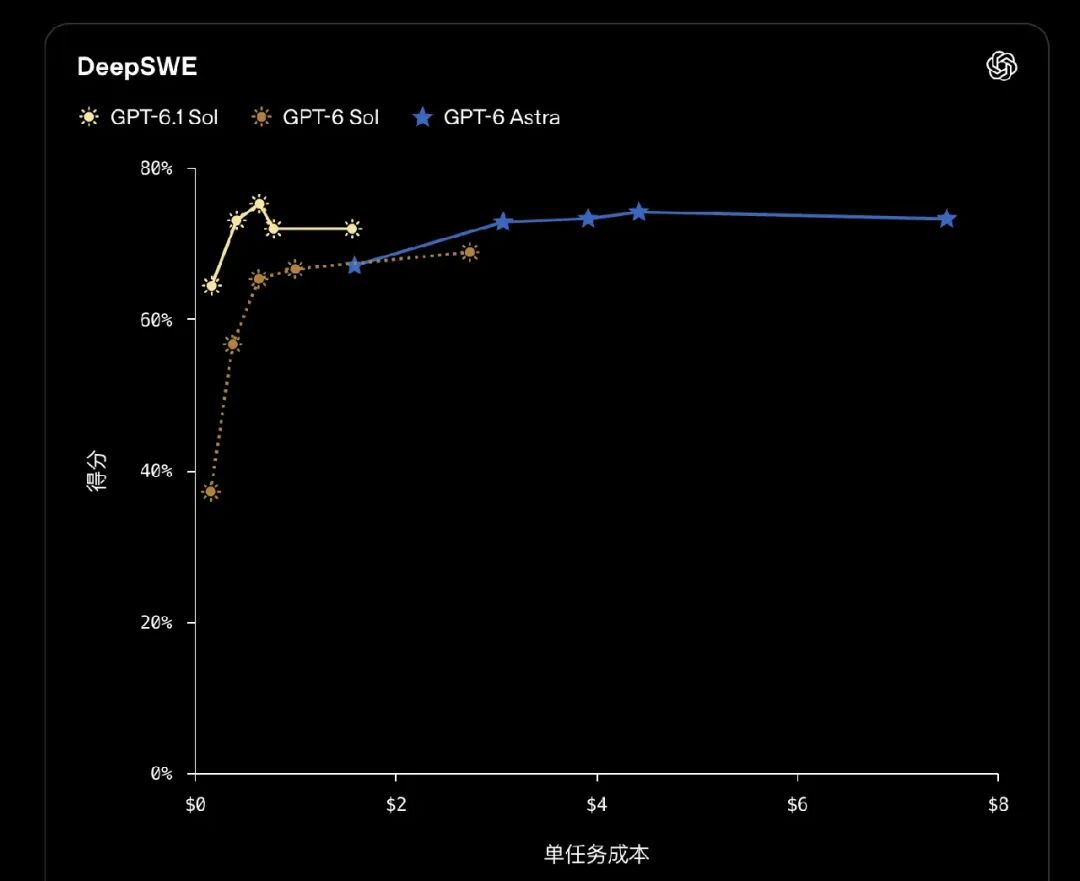
在编程方面,在 DeepSWE v1.1 测试中,GPT-6.1 Sol 以约五分之一的成本达到与 GPT-6 Astra 相当的水平,同时以更低的推理强度和成本,比 GPT-6 Sol 的最高得分高出 6.4 个百分点。
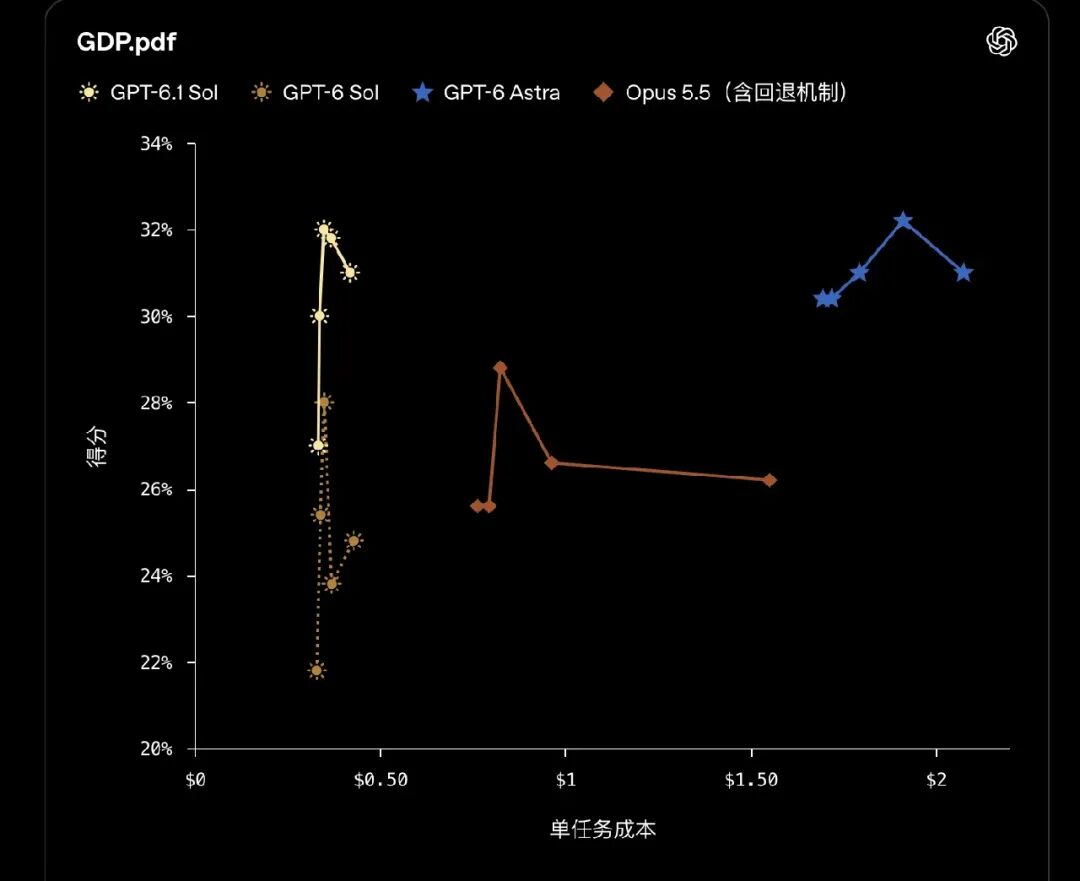
在专业工作方面,GDP.pdf 在所测试的各档推理设置下,GPT-6.1 Sol 的得分均高于带回退机制的 Opus 5.5,而单任务成本不到其一半。它还以约五分之一的单任务成本,接近 GPT-6 Astra 的性能。
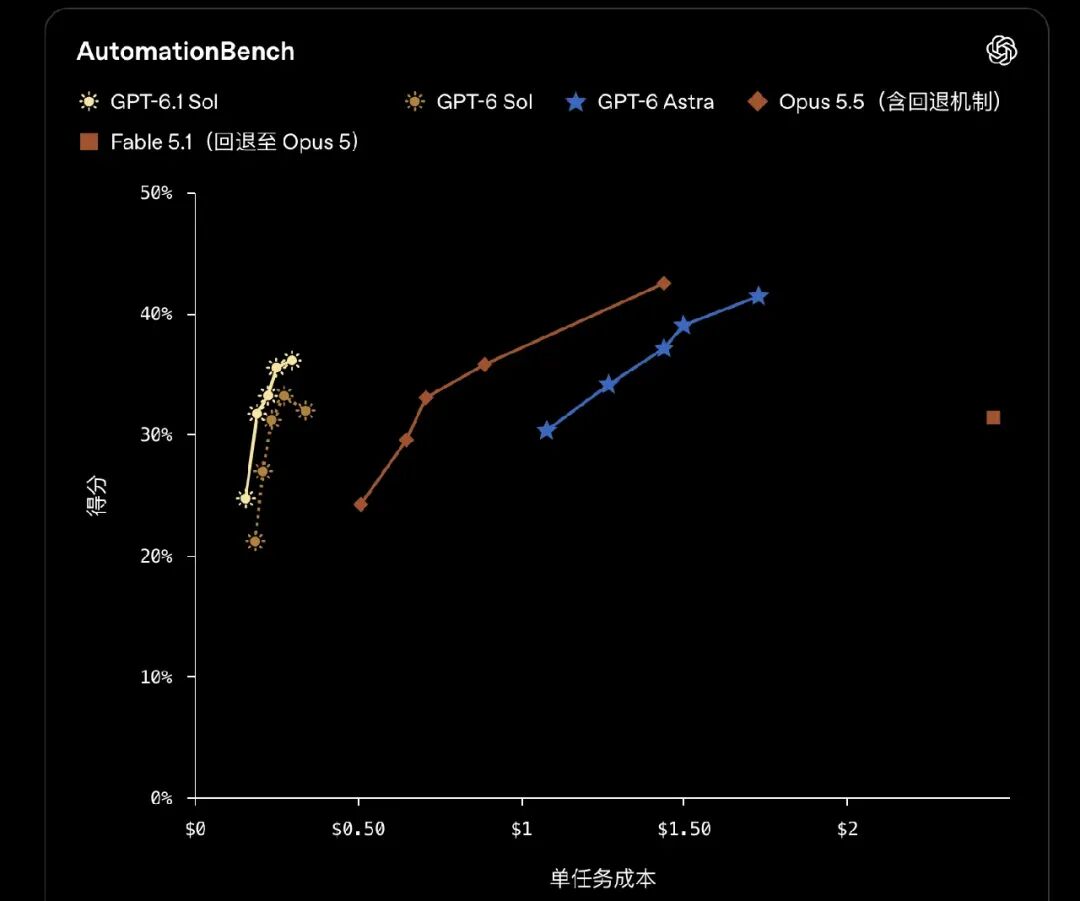
AutomationBench 衡量智能体能否正确完成多步骤业务工作流。在这项评估中,GPT-6.1 Sol 在中等推理强度下的得分比 Opus 5.5 高 2.2 个百分点,成本则约为其三分之一。这一得分也比相同设置下的 GPT-6 Sol 高出 4.8 个百分点。
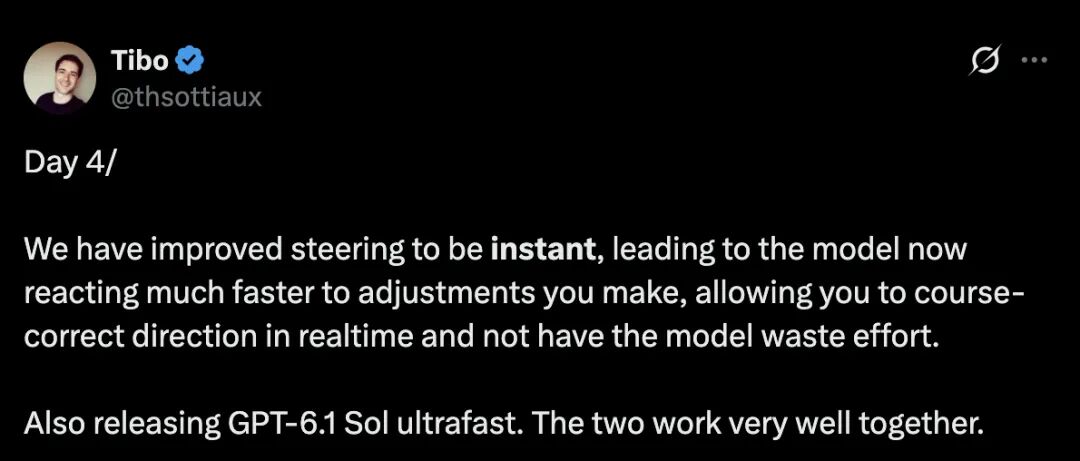
在 x 上,Codex 负责人 Tibo 发文称:“我们改进了一些功能,使模型响应速度更快,从而能够更快地响应用户的调整,让您可以实时修正方向,避免模型浪费资源。同时,我们还发布了 GPT-6.1 Sol 极速版本。两者配合使用效果极佳。”
与此同时,官方仍将 Astra 定位为处理最困难任务的最高能力模型,并建议用户在自己的任务上对比两者,判断质量与成本之间的取舍。
从公开规格看,Sol 与 Astra 的上下文容量、最大输出长度相同,标准模式的输入和输出单价则有明显差距。
资料来源:OpenAI 官方模型对比页。
按相同 Token 数量计算,Sol 的标准输入和输出费用均比 Astra 低 80%。但这一比例不能直接换算成“完成同一项任务便宜 80%”:模型实际生成多少推理和输出 Token、是否需要重试,以及调用多少工具,都会影响最终账单。
此次 Ultrafast 更新也需要区分两类“性能”:一类是完成任务的质量,另一类是完成任务的速度。
价格怎么算?
GPT-6.1 Sol 的标准模式、Fast 快速模式和 Ultrafast 极速模式,分别按不同单价收费。对于输入不超过 27.2 万 Token 的请求,API 价格如下:
资料来源:OpenAI 官方 API 定价页。
这意味着,极速模式的单价是标准模式的 6 倍,也是快速模式的 3 倍。需要强调的是,6 倍价格并不意味着 6 倍速度,两者不能直接对应。
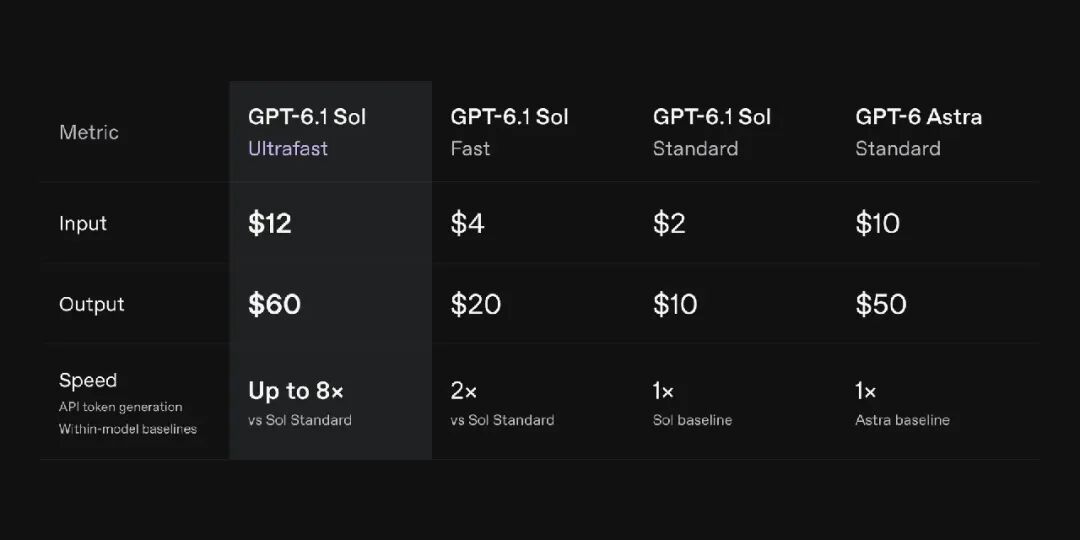
用一个简化账单举例:假设某项请求消耗 10 万个未缓存输入 Token、1 万个计费输出 Token,不计工具等其他费用,那么标准模式费用约为 0.30 美元,快速模式约为 0.60 美元,极速模式约为 1.80 美元。这是按官方单价进行的计算示例,并非实际任务测试。
长上下文还会进一步提高价格。当输入超过 27.2 万 Token 时,GPT-6.1 Sol 极速模式的输入价格升至每百万 Token 24 美元,输出价格升至 90 美元。官方规定,长上下文倍率作用于整个请求,而非仅对超出阈值的部分加价。
另一个容易忽略的比较是:Sol 极速模式每百万 Token 的输入、输出价格分别为 12 美元、60 美元,已经高于 Astra 标准模式的 10 美元、50 美元。按同量 Token 计算,前者高出 20%。因此,Sol“成本较低”的优势需要结合服务档位判断;选择极速后,用户购买的价值更多来自等待时间的减少。
API 端,GPT-6.1 Sol 的 Ultrafast 模式向所有 API 用户开放,并设有独立于标准和快速模式的速率限制。它支持全球处理,以及美国和欧盟数据驻留。
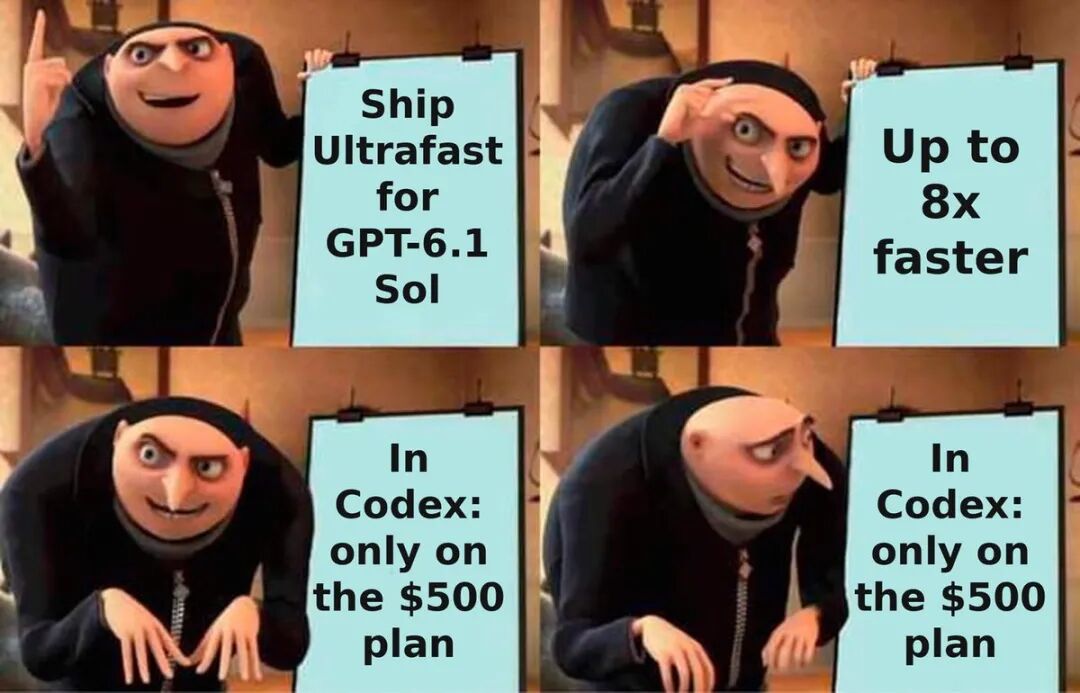
ChatGPT 产品端的开放范围则更窄。根据官方文档,GPT-6.1 Sol 在 Work 和 Codex 中提供,普通 Chat 模式不提供这一模型。Sol 模型的首发范围覆盖 Plus、Pro、Business、Enterprise 和 Edu,但极速模式仅向 Pro 500 美元档及符合条件的 Enterprise、Edu 方案开放,实际可用性还取决于客户端、工作区设置与 rollout 进度。
订阅额度的消耗也不能照搬 API 的价格倍率。官方定价说明显示,GPT-6.1 Sol 极速模式消耗套餐内含使用额度的速度为标准模式的 8 倍;购买的额外 credits 和企业按量付费使用,则采用 6 倍倍率。
用户:我们要额度,你给速度
围绕 GPT-6.1 Sol 极速模式,用户在 x、Reddit 等平台上展开了激烈的讨论。讨论主要集中在两个问题上:提速能否让智能体真正好用,以及用户是否应该为此承担明显更高的费用。
支持者认为,速度对智能体的意义,已经超出了“回答问题更快”。
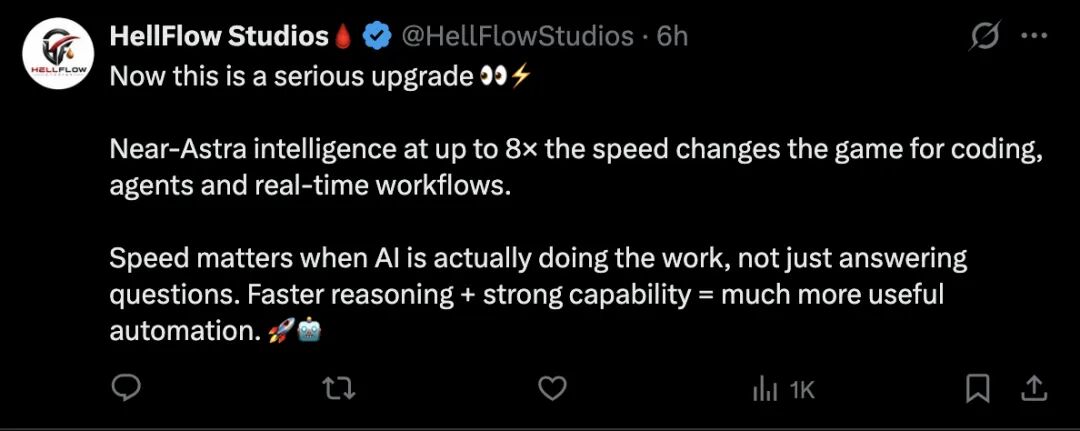
在 x 上,ID 名为 HellFlow Studios 的用户表示,当 AI 开始实际执行任务时,更快的推理与较强的能力结合,能够提高自动化的实用性,尤其是在编程、智能体和实时工作流中。
Brian Gastón 和 Shrilaxmi 则将关注点放在智能体反复执行的工作循环上:多轮推理与工具调用中的延迟会不断累积,速度决定了这类产品能否成为日常工具。
不过,Brian 也提出,极速模式在长时间、连续调用工具的任务中,究竟能否保持表现,仍值得观察。
还有用户表示,大家需要的是更长的使用时间,而不是更快的型号。如果总是用不完,那超快的速度还有什么意义呢???
Clarity Today 则提醒,API 与 Codex、Work 的计费口径不同,不能直接照搬预算;提速是否划算,还要看用户等待的时间主要消耗在模型生成上,还是外部工具执行上。
极速模式的开放门槛和额度消耗,也引发了部分付费用户的不满。
在 x 上,用户 DoubleStraddle 将矛头指向套餐分层,讽刺此次发布让每月支付 200 美元的用户感到被冷落,仿佛只有 500 美元档用户才能获得新功能。
Wei 佳则表示,能够在任务执行过程中调整智能体方向的 Steering 功能,才是自己每天都能感受到的改进;至于极速模式,他会等到它不再受限于 500 美元套餐时再考虑。
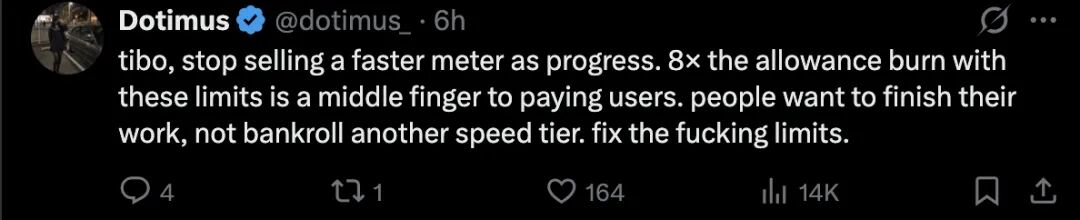
额度问题是另一处争议。Dotimus 认为,在现有使用限制下,极速模式以 8 倍速度消耗套餐额度,并没有解决用户完成工作的实际困难。他呼吁 OpenAI 优先改善额度限制,而不是继续销售更高的速度档位。
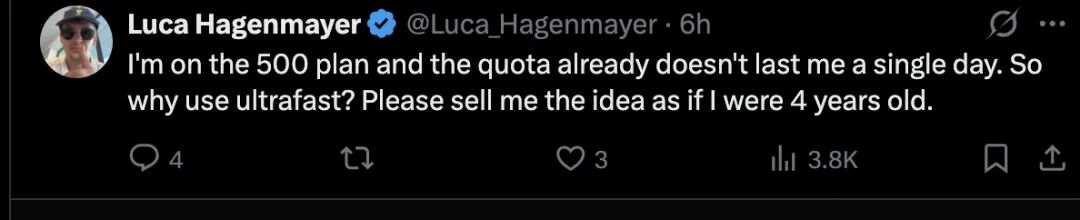
自称订阅了每月 500 美元套餐的 Luca Hagenmayer 也表示,自己的额度已经撑不过一天,因此难以理解开启极速模式的价值。
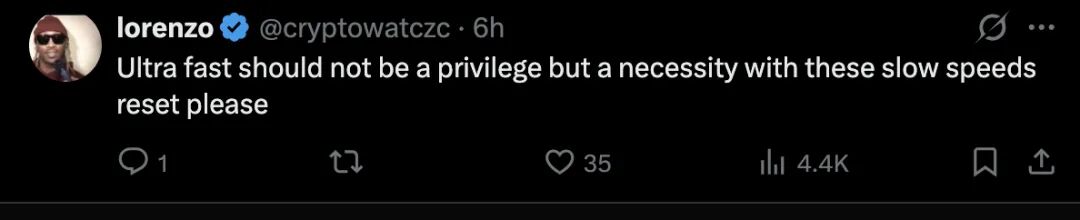
lorenzo 则认为,如果基础速度已经让用户感到缓慢,更快的体验就应该成为基本需求,而非高价套餐的特权。
此外,也有用户反馈更新后的稳定性问题。
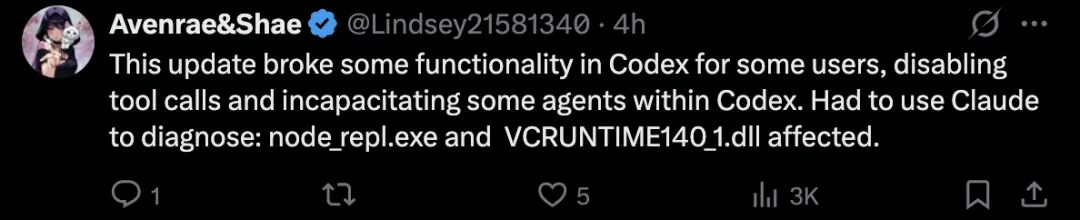
Avenrae&Shae 称,更新后部分 Codex 智能体无法正常工作,工具调用也受到影响;其借助 Claude 排查后,怀疑问题涉及 node_repl.exe 和 VCRUNTIME140_1.dll。
这些反馈显示,部分用户关注的重点,是额度能否支撑一天的工作,以及更新后工具能否稳定运行。即使已经购买最高价套餐,如果提速意味着更快耗尽额度,极速模式的吸引力也会打折。
这些讨论反映出,用户确实希望智能体更快,但对提速的价值判断并不一致。有人愿意为更流畅的交互和更短的工作循环付费,也有人认为,基础速度本就应该得到改善。最终,极速模式能否说服用户,仍要看它在真实任务中省下的时间,是否足以抵消增加的费用与额度消耗。
智能体时代,速度开始单独定价
从应用角度看,极速模式更可能在需要持续交互的工作中体现价值。
编程智能体的一项任务,往往包括阅读代码、生成修改、执行测试、检查报错,再继续修正。用户等待的时间来自多个环节。模型生成更快,可能缩短其中反复出现的等待,但测试执行、网络请求和外部工具本身的耗时,仍会影响整个任务的完成速度。
OpenAI 在极速模式文档中特别建议使用 WebSocket,尤其是需要连续快速调用工具的智能体应用。其解释是,如果没有持久连接,网络开销可能削弱极速模式带来的延迟收益。
这也说明,评价“极速版”不能只看文字输出有多快。对开发者而言,更有意义的比较,是在相同任务、相同推理设置和相同工具环境下,分别观察完成质量、总耗时与实际费用。
此次更新显示,OpenAI 正把模型能力与运行速度拆成可以分别选择的产品维度。同一个 Sol,既可以按标准价格运行,也可以付出更高费用来减少等待。
对用户而言,最终值得计算的,是一次提速究竟省下了多少工作时间:如果它能让人更快完成一轮调试、及时发现错误并继续推进,溢价可能有意义;如果任务本来就在后台运行,或者大部分时间花在外部工具上,极速档位的收益就需要重新衡量。模型输出更快只是起点,工作更快完成,才是这笔费用的落点。
参考链接:
https://community.openai.com/t/ultrafast-is-rolling-out-today-for-gpt-6-1-sol-in-the-api-codex-and-chatgpt-work/1404475
https://developers.openai.com/api/docs/guides/ultrafast-mode
https://x.com/thsottiaux/status/2108275041276420573
