

 搜索


同一道题,什么都没改,只在前面多塞几个无关紧要的字符,模型突然就不会了???
而且还不是偶尔抽风。
Seed研究人员发现,
啥意思?模型记不记得住一件事,居然还要看这件事在输入里站哪儿??
前面多两个Token,答案可能从错变对,再多两个,又给你改回去。
好好好,模型答题也开始讲究站位了。
在128K长上下文检索测试中,研究人员发现,同一条信息只是换了个位置,
团队进一步发现,这个问题与
分块KV Cache压缩。
这项技术本来是为了让模型处理长文本更省内存、更高效。
结果压缩之后,倒让模型时神时鬼了(doge)。
多两个Token,DeepSeek突然就答对了
字节Seed研究人员最开始是拿
测试对象是
他们从
任务的正确答案应该是8,因为这段代码需要完成FP8相关的类型转换。
但模型有时偏偏觉得应该补成32。
为了搞清到底咋回事,研究人员在代码前面加了一段纯装饰性的文档字符串,里面放着一些重复的等号。
然后,他们开始调整等号的数量。
代码本身没改、要补全的位置没改、正确答案当然也没改……唯一的变化,就是前面多了这几个没什么实际意义的Token。
结果,
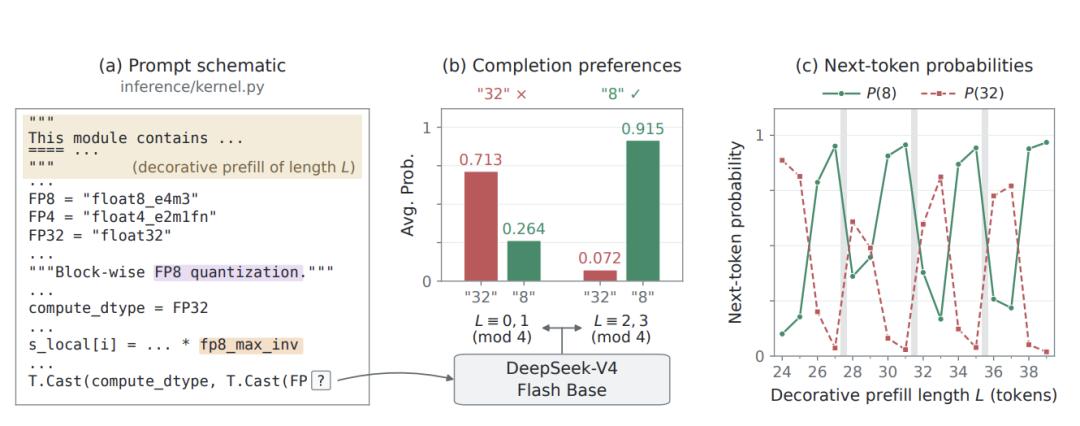
当填充长度落在某些位置时,模型更倾向于回答错误的32。
往前挪一两个Token,又开始倾向于正确的8。
再继续挪,错误答案又回来了——
整个过程以4个Token为周期重复。
更具体地说,在论文测试的16种填充长度中,当长度模4的余数为0或1时,模型倾向于错误答案32;余数为2或3时,则倾向于正确答案8。
研究人员还统计了模型给两个候选答案分配的概率。
在一组位置上,错误答案32的平均概率达到71.3%,正确答案8只有26.4%。
换到另一组位置,情况直接反过来:
正确答案8的平均概率升到91.5%,错误答案32只剩7.2%。
也就是说,前面几个无关字符的长度变化,足以让模型对同一道题产生截然不同的判断。
这就有点难评了。
程序员调试代码,通常先检查逻辑、变量和依赖。
现在看来,可能还得顺手检查一下,前面是不是多打了两个等号。
不过单个代码补全案例,还不足以说明问题有多普遍。
于是Seed团队继续扩大测试。
他们把目光转向大模型长上下文能力里很经典的一项任务,大海捞针。
研究人员构造了一段长达128K Token的上下文,里面包含约1.6万个键值对。
比如K1对应V1,K2对应V2……
然后让模型从中找出指定Key对应的Value。
测试过程中,键值关系不变,问题不变,上下文总长度也保持一致。
研究人员重点调整目标信息相对于压缩窗口边界的位置。
结果发现,
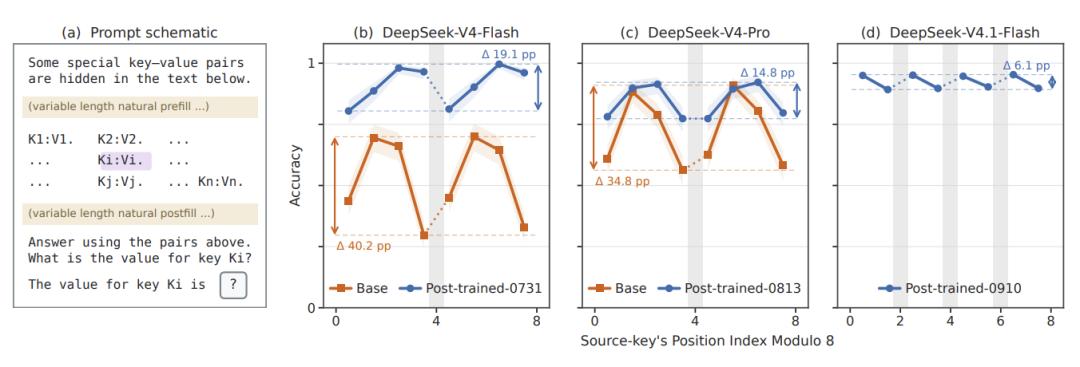
其中
经过后训练之后,情况有所改善。
而更新的
但周期性差异依然存在。
这种差异性是怎么来的呢?
再往细看,
研究人员发现,这恰好对应两代模型各自采用的KV Cache压缩步长。
好嘛,连答题表现的起伏周期,都和底层压缩配置对上了。
问题出在KV Cache压缩?
那咱就来说说KV Cache压缩。
大模型处理长上下文时,需要保存大量历史Token对应的Key和Value信息,供后续注意力计算使用。
上下文越长,这部分缓存占用的内存和计算开销就越大。
尤其是动辄几十万、上百万Token的长任务,KV Cache很容易成为推理效率的瓶颈。
所以
思路是把连续的Token分成一个个窗口,再将窗口内的信息压缩成更少的缓存条目。
这样模型就不用为每个历史Token保留同样规模的缓存。
既节省内存,也能降低长上下文注意力计算的成本。
但Seed团队发现,
假设每4个Token构成一个压缩步长。
那么,同一条信息出现在窗口里的第1、第2、第3或第4个位置,压缩时所处的条件就可能不同。
论文把这种相对于压缩窗口边界的位置,称为Phase(相位)。
研究人员发现,模型对不同相位的信息,检索能力存在系统性差异。
他们把这种现象命名为Phase Sensitivity,相位敏感性。
打个比方,同样一份资料交给模型:
第一种排版,关键数字恰好落在模型容易保留的位置;
第二种排版,只是在前面多加几个字,关键数字相对于压缩窗口的位置变了。
资料还是那份资料,但模型之后能不能把数字找出来,可能就有明显差别。
而且,这种问题还不能简单归结为“信息刚好被切在两个窗口之间”。
研究人员发现,即使Key和Value都落在同一个压缩窗口里,不同位置的检索准确率也能相差很大。
这说明问题还涉及模型究竟如何把信息写入压缩缓存,以及之后如何从缓存中读取。
为了进一步确认,Seed团队干脆自己从头训练了一批模型。
他们以Qwen3-0.6B架构为基础,构造了多种KV Cache压缩方案,并设置没有分块压缩的全注意力模型作为对照。
重点只改变压缩机制,看看周期性波动会不会跟着出现。
结果,所有接受测试的分块压缩模型,都出现了与压缩步长对应的周期性变化。
反过来,全注意力基线模型没有出现同等程度的周期性。
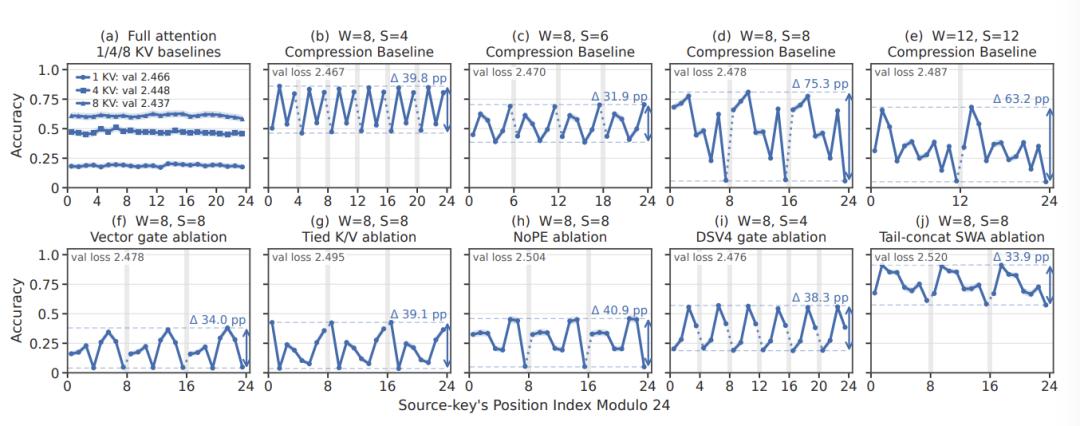
研究人员还分别调整了窗口大小和压缩步长,发现周期主要跟着压缩步长变化。
步长为4,表现就以约4个Token为周期起伏;
步长为6,周期也跟着变成约6个Token;
步长为8,同样如此;
……
甚至不使用RoPE位置编码,或者把可学习的压缩权重换成简单平均,这种现象依然存在。
换句话说,问题并不是某个位置编码或者某个特殊模块单独造成的。
分块压缩这种设计本身,就可能引入周期性的检索弱点。
Seed团队进一步对注意力头进行干预,观察移除不同组件之后,模型在各个相位上的检索能力如何变化。
结果发现,不同注意力头对不同相位的贡献并不一样。
有些头更擅长处理某些位置的信息,另一些头则在其他位置上发挥更大作用。
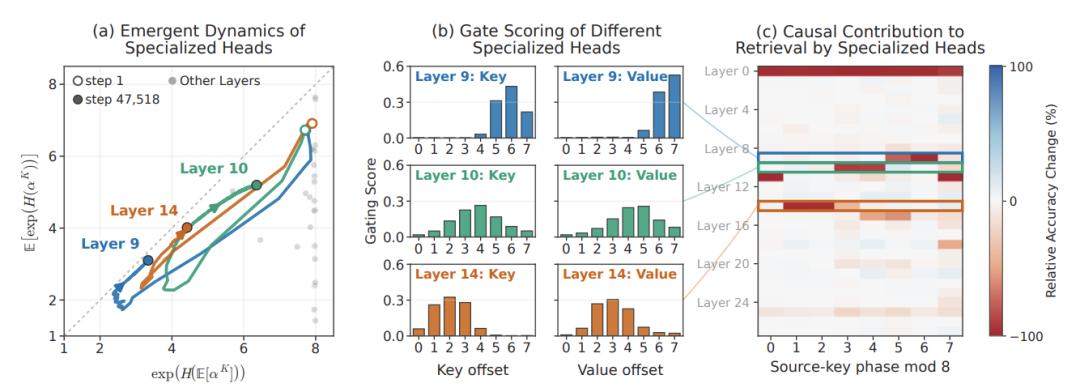
研究人员将其称为Phase Specialization,相位专门化。
也就是说,模型内部似乎形成了一种分工:不同注意力组件,对压缩窗口里的不同位置产生了偏好。
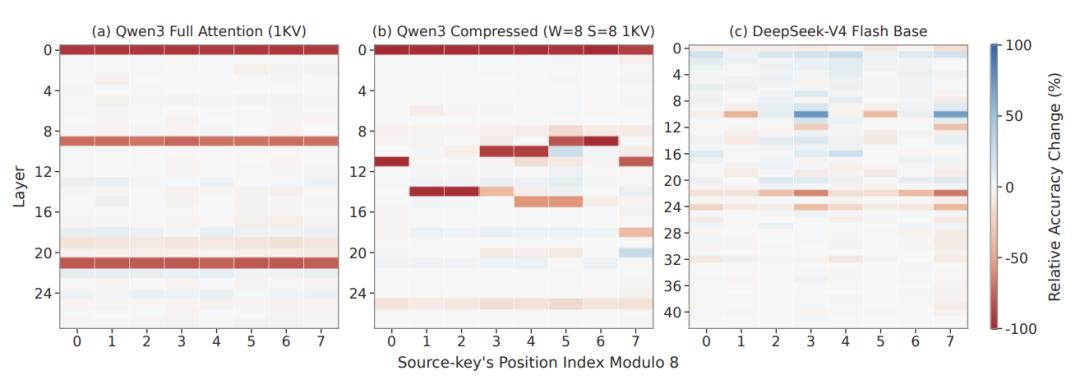
这种分工可以帮助模型完成信息检索,却也可能让某些位置成为相对薄弱的环节。
论文还通过简化的理论模型分析了训练过程,发现梯度流可能推动压缩模块形成稳定的位置偏好。
这也解释了为什么这种周期性并非简单的随机噪声。它可能是模型在学习如何压缩信息时,自然而然形成的结果。
但这类问题未必能从普通Benchmark里直接看出来,因为常规评测通常会把大量测试结果汇总成一个平均分。
假设模型在某些位置表现很好,在另一些位置明显掉队,最后算出来的平均成绩可能依然不错。
所以Seed团队提出,评估采用分块KV Cache压缩的模型时,不能只看整体检索准确率,还得把同一条信息放到不同压缩相位上,分别测一遍。
可即便存在这种位置带来的性能偏差,长上下文推理的内存和计算成本摆在那里,压缩仍然有很现实的价值。
但节省缓存之后,模型对不同位置的信息,可能不再一视同仁。
当然了,从这次的实验结果看,后训练和架构迭代确实能明显缩小这种差距。
论文地址:https://arxiv.org/pdf/2609.36322
