

 搜索


世界模型,真的太火了。
我们先看几个新闻:
今年年初,图灵奖得主Yann LeCun(杨立昆)和Saining Xie(谢赛宁)合伙创立AMI Labs,种子轮就融资了10.3亿美元(估值35亿美元),是欧洲有史以来最大的种子轮融资。他们的主要研究方向,就是世界模型。
上个月,AMD公司宣布,以82亿美元的天价,收购李飞飞创办的公司World Labs,还让李飞飞担任AMD执行副总裁、首席科学家,直接向苏妈汇报。李飞飞的赛道,也是世界模型。
前几天,曾因严重违纪被字节跳动辞退的前实习生田柯宇,创办了一家AI初创公司,名称没定,也没有推出任何产品,但已经完成近3000万美元融资(估值2亿美元)。田柯宇讲的故事,仍然是世界模型。
以上融资案例,只是冰山一角。现在整个AI圈子里,几乎所有的头部科技公司(包括英伟达、谷歌、Open AI、特斯拉、亚马逊等),都在拼命拥抱世界模型。
如果你不懂世界模型,都不好意思说自己是搞AI的。
那么,世界模型到底是什么?它和我们现在熟悉的大语言模型(LLM)又有什么本质区别?它凭什么能吸引如此多的顶级科学家、巨额资本和头部公司押注?
今天这篇文章,小枣君就给大家做个深入解读。
到底什么是世界模型?
世界模型(World Model),我第一次看到这个词的时候,想到的是数字孪生——难道大佬们是打算通过数字孪生技术,复刻一个物理世界?如果是这样的话,那确实是一个巨大的工程。
后来我才发现,其实,世界模型并不是要创造一个完整的数字版世界。更准确来说,世界模型应该叫做“物理世界的模型”。
它的核心目标,不是复刻整个世界,而是让AI在“大脑”里构建一个可运行的物理世界模拟器,把真实世界的规律“内化”成自己的底层能力。
创造世界模型,是为了让AI真正理解物理世界的运行规律——物体如何运动、碰撞、遮挡,光线如何传播,等等。
想要理解世界模型,我们先要搞清楚传统大模型的短板。
现在的传统大模型,本质上都是大语言模型,也就是LLM(Large Language Model)。
LLM的学习材料,主要是人类积累的数据——书籍、文章、网页、代码、对话记录等。LLM通过学习人类海量的文字、图片、视频数据,掌握了语言内部的统计规律和逻辑关系,根据上下文,预测下一个最合理的字、词、画面。
视频生成模型,虽然能生成逼真的画面,但本质上是在“拼接”和“联想”海量训练数据中的视觉片段,依靠数据中的统计规律,来生成符合条件的视频。
换言之,传统大模型懂知识,但不懂世界。
举个很简单的例子。
你问AI:一个玻璃杯从一米高的桌子上掉下来,会发生什么?
AI可以完美回答:杯子会掉落、撞击地面、碎裂、有水会洒出。
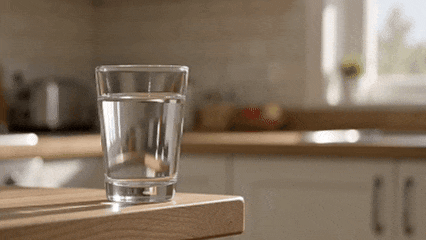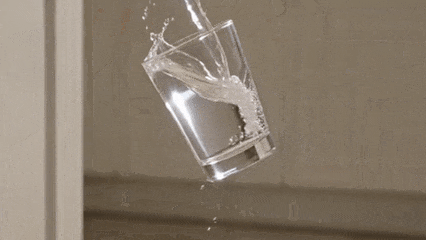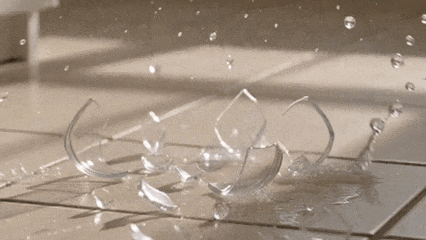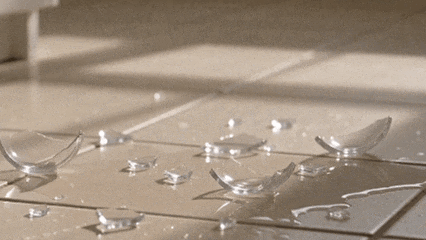
但重点来了:AI是背答案背出来的,不是理解规律算出来的。
它不知道什么是重力,不知道什么是坚硬、柔软,不知道玻璃易碎的物理特性。它只是从亿万条投喂数据里,记住了“杯子掉落会碎”这个固定结论。
一旦场景稍微偏离训练数据,AI就会立刻“幻觉上身”,闹出各种笑话。例如刚才的视频中,杯子其实已经“穿帮(翻转)”了。
业界普遍认为,传统大模型有三大硬伤:
● 没有真实感知:只会读取数据,不能理解真实世界。
● 没有因果逻辑:只会关联匹配,不会推理前因后果。
● 没有预判能力:只能被动应答,无法预测事物发展。
说白了,现在的AI是纸上谈兵的学霸——读书虽然已破万卷,但不懂世间规律。
停留在电脑里的AI,永远都不是真正的AI。真正的AI,必须要能够解决现实世界中的问题,能够完成真实场景的任务。
于是,专家们就提出了世界模型。
世界模型,是一个底层的技术框架。如前面所说,世界模型可以让AI学习现实世界的空间结构与变化规律,进而生成、重建和模拟一个能够持续探索、实时交互的三维世界。
如果说传统大模型是“熟读万卷书”,那世界模型就是“亲历世间事”。
它不再单纯靠文字、图片数据死记硬背,而是通过更先进的技术手段,总结出整个物理世界、现实社会的底层运行规律。
包括:物理规律、空间逻辑、时间顺序、因果关系、人类行为习惯、社会常识等等。
拥有世界模型的AI,脑子里会自带一套“虚拟沙盘”。
当它接收一个问题、一个场景指令时,不会只去翻数据库,而是会在自己的虚拟世界里实时模拟、推演、预判,最后给出符合现实逻辑的选择决策。
还是刚才杯子的例子。
世界模型AI看到杯子掉落,不是靠背诵知识点,而是在脑中模拟了完整过程:
重力作用下落→速度逐渐加快→硬质地面碰撞玻璃→应力破碎→水流散落→地面留水渍
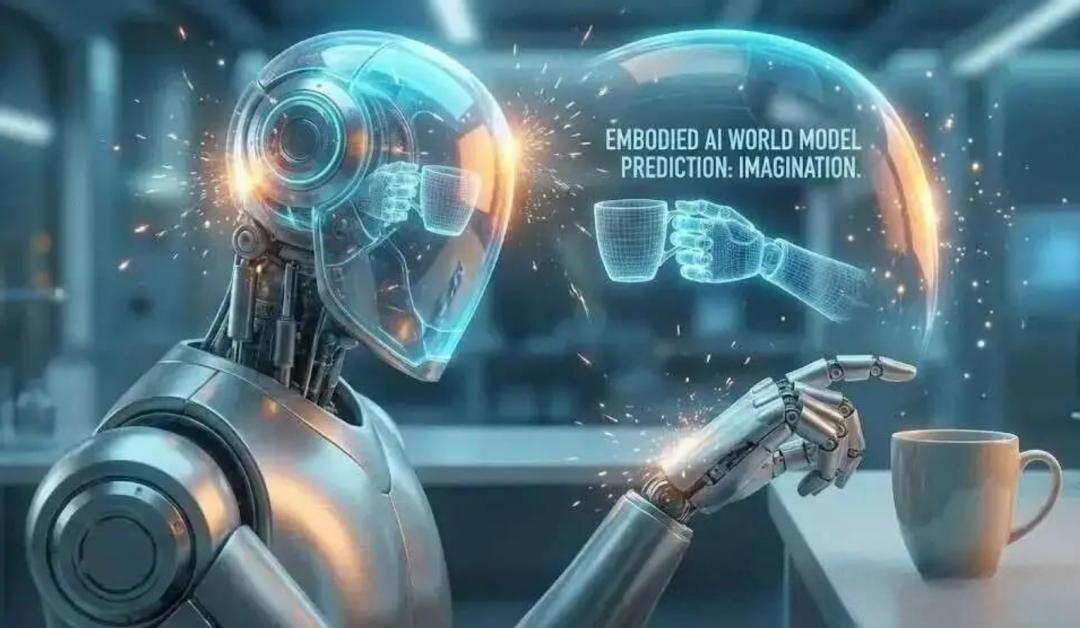
哪怕你修改条件:杯子换成塑料的、地面铺地毯、高度改成十厘米,它不需要重新学习,也能靠底层规律推演,得出正确结果,不会出现AI幻觉。
这就是最本质的区别:传统大模型学习的是“表象”,世界模型修炼的是“内因”。
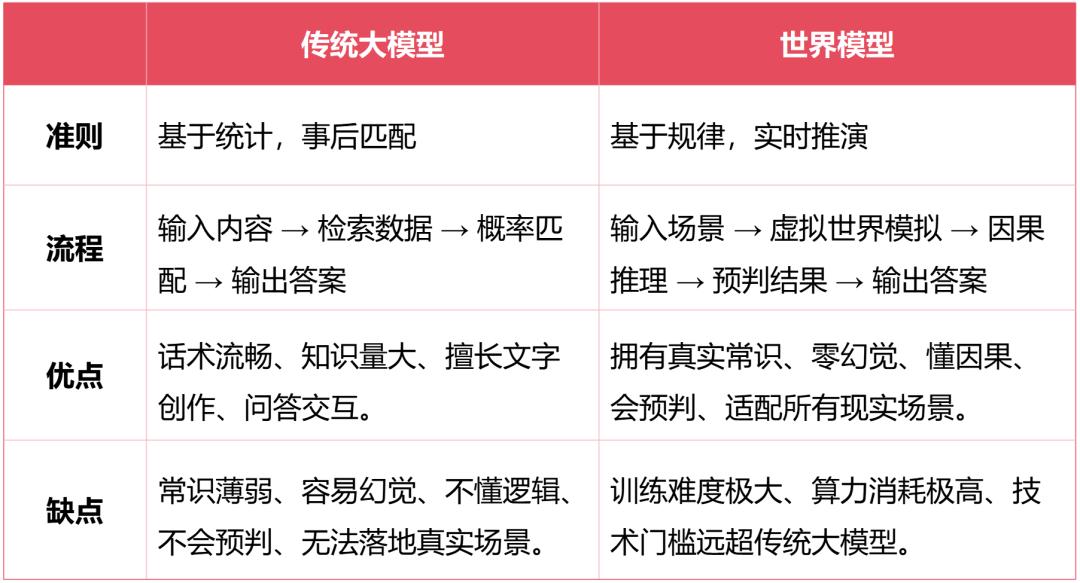
简单总结:大模型是“知其然”,世界模型是“知其所以然”。
世界模型,到底有什么用?
很多人觉得,世界模型只是传统大模型的“升级版”,其实完全不是。它是AI能力维度的全面颠覆。
它的核心能力,主要集中在三点,每一点都直击当前AI的痛点。
第一,极强的常识推理能力
现在的AI经常犯低级常识错误:比如画出反着走的人、横着开的汽车,以及各种违背物理规律的场景。
而世界模型吃透了现实世界的底层规则,自带常识屏障。
不管是画图、视频生成、场景推演,都会严格遵循物理规则、空间逻辑、现实常识,不会出现离谱的错误。
第二,超强的未来预判能力
这是世界模型最核心的杀手锏。
传统AI只能对已有信息进行总结、应答。但世界模型可以基于当下场景,推演未来的变化。
比如看到天气、路况、行人动作,就能预判接下来几秒、几分钟会发生什么;看到设备运行状态,就能预判故障风险;看到一方出拳,就知道另一方会躲。
这种预判能力,是AI从“被动应答”走向“主动智能”的关键。
第三,跨场景通用适配能力
现在的AI大多是专一场景:聊天的只聊天、画图的只画图、自动驾驶只做驾驶。
世界模型是通用人工智能的底座。
因为它掌握的是世界通用规律,不管是文字、图像、视频、机器人控制、自动驾驶、智能家居,所有现实场景都能一通百通,无需单独训练微调。
看懂了以上的能力差异,大家应该就能明白,为什么行业大佬都说:世界模型是AI的下一个十年。
传统大模型的红利,基本已经走到天花板了。现在各家的大模型,对话、写作、问答能力差距越来越小,卷参数、卷数据、卷话术,已经很难做出颠覆性差异。
AI的未来,一定是AGI(通用人工智能)。AGI,绝对离不开物理AI(Physical AI),与现实世界深度交互的智能体。
全球GDP中约50%仍在物理世界,未来大部分将被物理AGI主导。而物理AGI爆发的关键技术突破口,是世界模型。
有人指出,未来的AGI架构,极可能是:LLM负责逻辑规划(大脑)+ 世界模型负责物理预测(小脑)+ 具身智能执行动作(身体)。
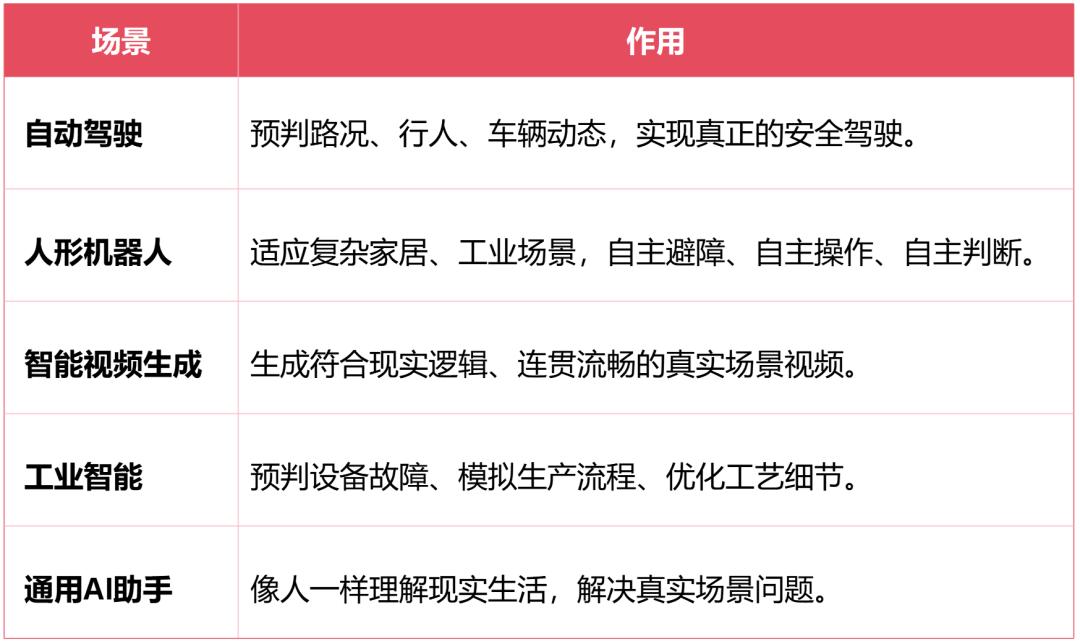
世界模型的作用
世界模型之所以现在这么火,有两个根本原因:
一、技术条件已经成熟。过去几年,大模型在算力、数据、算法上积累的能力,已经为世界模型的爆发打好了地基。
二、产业需求迫在眉睫。物理世界的智能化改造,正从单点试验走向全面铺开。工厂要降本增效、机器人要走进千家万户,自动驾驶要覆盖更多城市,这些都急需世界模型提供底层能力支撑。
目前,世界模型已在具身智能、智能驾驶等核心场景实现规模化验证,可以有效解决高安全、高复杂度场景下数据稀缺与试错成本高昂的痛点。
例如,在智能驾驶领域,世界模型通过构建高保真虚拟交通环境,完成海量极端工况预演,覆盖各种罕见长尾场景,支撑车辆决策系统的安全迭代。
再例如,在具身智能领域,现在最缺的是实际操作过程的训练数据。世界模型依托3D空间构建与物理规律推演,让机器人在“梦境”中完成动作试错与路径规划,可以显著缩短训练周期,降低训练成本。
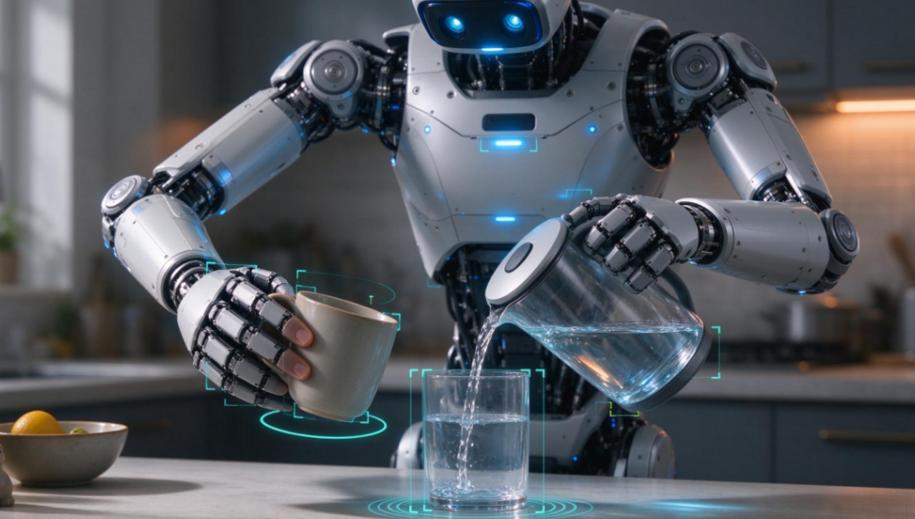
除此之外,世界模型正加速向内容创作、气候预测、医疗仿真等新兴领域渗透,凭借其物理认知、因果推理与长时序模拟能力,获得越来越多的用户和市场。
世界模型面临的挑战
最后小枣君客观说一句,世界模型虽然前景爆炸,但目前还远未成熟,依旧存在明显短板。
首先,训练成本极高。
传统大模型靠文本数据训练,成本可控。而世界模型需要海量的视频、三维场景、动态过程数据,算力消耗、数据成本、训练难度,是传统大模型的数倍甚至数十倍。
其次,复杂场景推演能力不足。
目前的世界模型,在简单物理场景下推演很精准,但面对复杂的社会行为、多人交互、复杂因果链条,依旧存在短板。
最后,落地场景还在探索。
现在的世界模型大多还处于技术研发、测试阶段,大规模商业化落地还需要时间。
结语
很显然,世界模型已经不是简单的风口轮动,而是技术范式的代际革命。
摩根士丹利研报指出:AI的下一场变革,是从“理解语言”转向“理解物理世界”,世界模型是这场变革的核心载体。预计到2035年,世界模型赋能的产业规模将达到10万亿美元。
未来十年AI行业的竞争,不再是大模型参数的内卷,而是世界模型认知能力、推演能力、落地能力的比拼。谁先掌握了顶尖的世界模型技术,谁就掌握了开启AGI时代的钥匙。
一场关于“理解世界”的军备竞赛,已经悄然打响。
