

 搜索


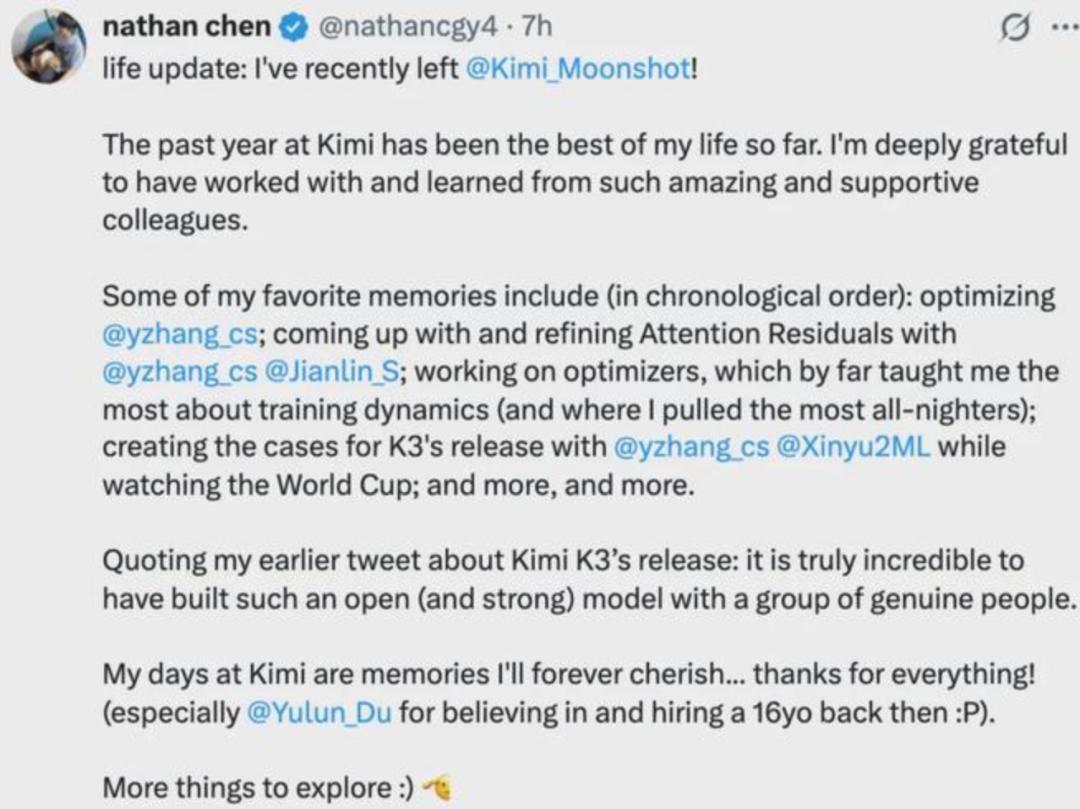
10月15日,陈广宇在X上发了一条简短的离职帖。
“过去一年在
他没有解释原因,也没有透露去向。但业内人都知道这条帖子的分量,陈广宇只有17岁,而他参与研发的Attention Residuals架构,已经是
评论区里,Anthropic可扩展强化学习方向负责人Sholto Douglas半开玩笑地问:原本去CMU的计划还作数吗?要不要来旧金山一起工作?
陈广宇回了一句:谢谢Sholto!我正要去海湾区。
一个17岁的中国少年,从惠州一所国际学校出发,用不到两年时间走进了
这不是一个“天才少年好厉害”的故事。更像是一面镜子,照出中国AI产业正在经历的一场更深层的焦虑:我们已经能在全球范围内发现顶尖人才,但我们的组织、文化和技术天花板,真的接得住他们吗?
16岁实习生走进Kimi核心
陈广宇的起点,跟“天才少年”的刻板印象相去甚远。
他没有奥赛金牌,没有跳级经历,也不是从小写代码的神童。2009年出生于深圳,就读于惠州贝赛思体系学校,跟大多数高中生一样按部就班地上课、考试。
转折点发生在2024年4月。读高一的陈广宇做了一个决定:暂停所有不喜欢的事,专心学AI。
他的学习方法极具时代特征——把论文上传给Gemini,再一遍遍提问,他后来在博客里把Gemini称作“导师”。
2025年5月,他在社交平台上发了一篇关于DeltaNet的技术博客。DeltaNet是当时前沿的线性注意力架构。帖子被该领域关键贡献者、MIT博士杨松琳回复,随后又被硅谷AI初创公司Tilde Research的CEO发现,主动约他通话。
那年夏天,16岁的陈广宇一个人飞到加州帕洛阿尔托,开始了七周实习。他每天在办公室待15个小时,参与内存优化混合专家模型MoMoE项目。
这段经历的意义远超一份实习证明,它让陈广宇第一次接触到全球最顶尖的AI研究环境,那些只在论文里见过名字的人,可能就在隔壁工位,这也为他后来的选择埋下了伏笔。
实习结束后,陈广宇收到了月之暗面的邀约。2025年11月,他加入
进入
真正让他出圈的,是2026年3月发表的Attention Residuals论文。
共同一作的分量
Attention Residuals这篇论文,是理解陈广宇技术价值的关键。
简单说,它改进的是Transformer架构里沿用了近十年的残差连接机制。传统残差连接像一层层叠加的笔记,每一层加进新信息,但层数多了以后,早期的有用信息会被冲淡。
AttnRes的原始想法由苏剑林(旋转位置编码RoPE提出者)提出,张宇(
最关键的工程突破,是陈广宇与张宇共同提出的Block AttnRes(分块注意力残差) 。把上百层网络划分成若干区块,块内维持低成本的基础累加,只在块间做精细的注意力聚合。这样显存复杂度从层数级降到了块数量级,只分约8个块,就能找回全量版绝大部分性能。
实测数据很硬核,
论文发布当天,硅谷半个AI圈被炸了出来。OpenAI联合创始人Karpathy评价:“看来还没把'Attention is All You Need'这句话按字面意思理解透。”马斯克留下一句:Impressive work from
这时人们才注意到,三位共同第一作者中,有一个17岁的实习生。
但陈广宇反复强调一件事:不要造神。他说成果属于团队,希望外界看到的是研究本身试图解决的底层难题。苏剑林的复盘文章里也写过,训练团队曾认为方案还不够可行,原因很直白——说白了还是穷。
这个细节很重要,AttnRes不是某个人的灵光一现,而是在算力约束下整个团队逼出来的创新。陈广宇是关键一环,但不是全部。
更重要的是,这项成果已经进入了
Wild Card的悖论
陈广宇离职前一个月,
9月9日,
这套招聘逻辑,和陈广宇的经历几乎是一个模板:先找到人,再决定他能解决什么问题,先看上限,再补齐岗位名称。
这几乎是当前中国AI公司的共同姿态,打破常规、破格录用、天才少年、黑客松招人……所有人都在抢最聪明的大脑。
但问题来了:招进来了,然后呢?
陈广宇的离开,照出了这个模式的另一面。
钛媒体报道引用了
这段话信息量很大。它没有明说为什么离开,但“探索新的好奇心”的措辞,暗示了一个核心矛盾:非典型人才的成长速度,可能比组织的上升通道更快。
一个16岁就能做出共同一作级别技术贡献的人,他的两年后在哪里?
如果在硅谷,他可能加入OpenAI或Anthropic,跟最顶尖的团队一起工作,解决最前沿的问题。如果留在国内,他的上升路径是什么?继续做研究员?升主管?管理一个团队?
对于真正的顶级人才来说,这些都不是最有吸引力的。他们要的是——最硬的问题、最好的同事、最大的杠杆。
这不是
Wild Card模式的悖论就在这里,你用最开放的姿态招到了最顶尖的人才,但如果你的技术天花板、组织复杂度和文化包容性跟不上,他们最终还是会走。
更深一层的矛盾在于,非典型人才往往不适应标准化的组织生活。他们需要更高密度的交流、更快的反馈、更大的试错空间。他们不一定适应汇报线,不一定愿意沿着传统职业路径往上走。
而中国公司,哪怕是最创新的AI公司,组织管理大多还是传统模式——职级、晋升、绩效、汇报。这些对常规人才是效率工具,但对Wild Card人才,可能就是束缚。
陈广宇去湾区,大概率不是为了钱。Anthropic出得起的薪酬,
人才焦虑,不止大模型圈
陈广宇的故事之所以值得关注,是因为他折射的人才焦虑,不只存在于大模型公司。
汽车行业正在经历同样的阵痛。
小鹏、理想、蔚来、比亚迪……每家车企都在疯抢智驾人才——大模型算法工程师、端到端智驾架构师、数据科学家。薪资水涨船高,有三年经验的算法工程师,年薪百万是起步价。
但招来的人,留得住吗?
汽车公司的组织文化,跟互联网和AI公司完全不同。层级分明、流程繁琐、节奏偏慢——这些对传统汽车工程师是常态,但对AI算法人才,可能就是无法忍受的低效。
某头部车企智驾部门负责人私下说过一句很扎心的话:“我们花两倍工资从互联网公司挖来的人,不到一年走了一半。不是钱不够,是他们受不了我们的流程。”
这跟陈广宇的故事,本质上是同一个问题——组织能力跟不上人才密度。
再看机器人行业,人才问题更尖锐。
具身智能是交叉学科,需要同时懂大模型、机器人控制、硬件、软件的复合型人才。而这样的人,全球都没多少。
智元、宇树、银河通用……每家公司都在抢同一批人。薪资越炒越高,但真正能干活的就那么多。而且跟大模型公司比,机器人公司的技术深度和品牌吸引力还弱一档——顶尖人才的第一选择往往还是大模型公司。
更严峻的是,机器人行业的人才流失不仅流向硅谷,也在行业内部流动。一家公司刚培养出来的工程师,可能被另一家以翻倍薪资挖走。整个行业都在抢人,但很少有人认真思考:我怎么才能把人留住?
答案当然不只是涨工资。
真正能留住顶级人才的,是三个东西:值得投入的问题、足够聪明的同事、清晰可见的成长空间。
问题决定了工作的意义,你是在做改变行业的事情,还是在做边缘的修修补补?
同事决定了工作的密度,跟比你聪明的人一起工作,成长速度是指数级的;跟平庸的人一起工作,只会被消耗。
成长空间决定了工作的未来——你能看到自己三年后在哪里,五年后在哪里,而不是在一个位置上原地打转。
用这三个标准去衡量,中国的AI公司、汽车公司、机器人公司,有多少能真正达标?
从发现人才到配得上人才
陈广宇的离开,不是
恰恰相反,
但陈广宇的离开,确实提出了一个全行业都需要回答的问题:
当我们已经学会了在全球范围内发现最顶尖的人才,我们的产业、我们的公司、我们的组织,准备好了接住他们吗?
这个问题的答案,决定了中国AI产业的下一个十年。
过去十年,中国AI的进步有目共睹。我们有了
但如果把竞争维度从产品拉到人才,差距依然明显。
硅谷的优势,从来不只是钱和技术。它的优势在于——它有一个完整的生态系统,让最聪明的人愿意来、来了能成长、成长了能留下。 这个生态系统里,有世界上最好的大学,有最活跃的创业文化,有最成熟的资本体系,有对"怪人"最大的包容度。
陈广宇去湾区,他面对的不只是Anthropic一家公司,而是整个硅谷生态——那里有跟他一样聪明的同龄人,有最前沿的问题,有最快的反馈循环,有最大的舞台。
反观国内,我们的AI生态还在建设中。我们有好公司,但不够多;我们有好大学,但跟产业的结合还不够紧密;我们有资本,但更追求短期回报而非长期价值。
人才争夺战打到最后,拼的不是谁出的工资高,而是谁的生态系统更有吸引力。
对于汽车智能和机器人行业来说,这个问题更迫切。因为这些行业的AI人才缺口更大、复合型人才更少、组织转型的难度更高。
车企需要的不只是招几个算法工程师,而是整个组织从"汽车思维"转向"软件思维"——从层级制走向扁平化,从流程驱动走向问题驱动,从按部就班走向快速迭代。
机器人公司需要的也不只是挖几个大模型人才,而是建立一个能让硬件和软件人才深度协作的环境——让搞机械的和搞算法的能真正对话,而不是各干各的。
这些改变,都比涨工资难多了。
但也只有做到这些,中国的科技公司,才能真正留住陈广宇这样的人。
