

 搜索


永远不要相信
最近的国产模型安静的有点反常,没上新、没预热。在一片寂静中,
光看名字只是加了个后缀,以为也只是一次小迭代,但看完测试和案例,
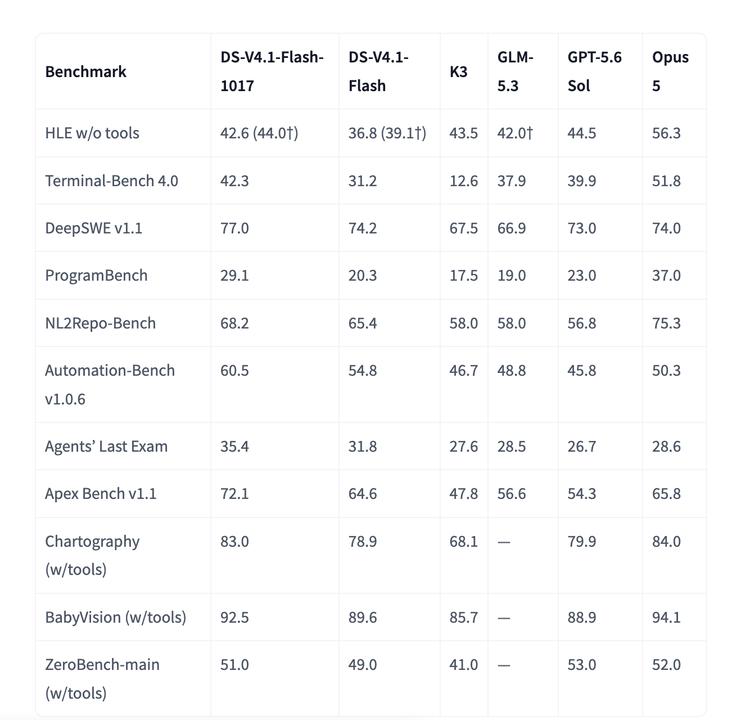
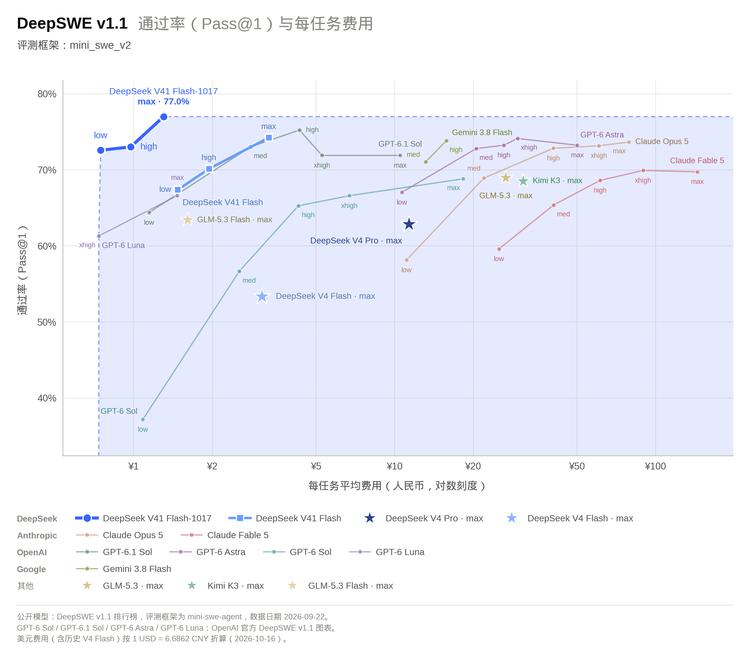
官方公布的评测中,1017 版本相较于上一代能力都得到了提升。其中,在终端操作和软件逆向上改进明显,Terminal-Bench 4.0 从 31.2 分升到 42.3 分。ProgramBench 从 20.3 分升到 29.1 分,增加了 8.8 分。
与 GPT 和 Claude 比较,1017 在其中 9 项测试中高于 GPT-5.6 Sol,终端操作和软件逆向都完成了从落后到反超的跨越。与 Claude Opus 5 相比,它在 DeepSWE、Automation-Bench、Agents’ Last Exam 和 Apex Bench 四项测试中领先。
秉持着不浪费用户每顿白饭的传统,
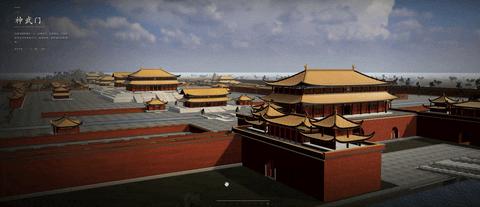
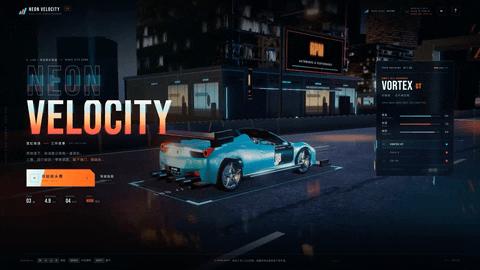
这次更新还把重点放在了从零开发完整项目上。官方展示了故宫 3D 建模、网页赛车,以及用 Godot 复刻的《传送门 2》和文明演化场景 Valley of Ages,并表示这些项目只用了少量提示词与参考素材,交互轮次也很短。
在官号里,
1
实测 DeepSeek-V4.1-Flash-1017
实测一:让一张纸长出海边小镇
第一个任务,是 3D 网页。要求是把桌面上的一张剪纸变成海边小镇。随着鼠标向下滚动,墙面从纸板上翻起,坡屋顶合拢,灯塔、码头和纸浪依次立起来,镜头也从俯视慢慢转向斜视。纸张的厚度、折线与投影都保留着,整个页面像一本正在展开的立体书。

从 GIF 可以看到房子立起来以后,仍然像纸做的。厚度、折痕和投影保住了立体书的质感,灯塔和时间滑块又让人有了继续玩下去的兴趣。尤其是拖到黄昏时,天空、海面和窗灯一起变化,几个功能能配合起来,整个小镇就显得更完整了。
实测二:让代码讲完两部科普片
另两个任务,把要求加到了声音和叙事上。不知道大家有没有刷到过科普短视频,简单的画面配上旁白,讲清楚一件事。如今
这类任务对,网页视频的叙事感、镜头方向和声音都有要求。
《地球:从炽热岩球到蓝色星球》长约两分半,把地球演化分成了13个章节。镜头从今天的蓝色地球倒回形成之初的炽热岩球,切开剖面展示内部层次,再潜入微生物所在的浅海。寒武纪生物游过镜头,小行星撞击扬起的尘埃遮住天空,最后又回到现代地球。
比较加分的是,画面和解说能配合着讲一件事。剖面展开,旁白就解释地球分层,镜头进入海底,讲述也转向生命变化,中文字幕能跟上相应段落。它已经能把几种视听元素组织成一段连贯的视频。
《一粒盐的诞生》则把镜头落在海南洋浦的一片盐田。约两分钟里,镜头从盐晶特写拉远,逐步展开制盐过程:海水进入泥地,盐工用木耙翻耙晾晒,盐泥被装进过滤池,卤水再送入石槽晒盐。微缩场景和暖色调贯穿全片,让这套工艺有了统一的视觉风格。
片中两次尺度切换用得很合适。过滤时,镜头切开池体,把泥沙和茅草层展示出来。结晶时,又进入微观示意,呈现水分减少、晶体逐渐出现的过程。
两部作品交付的本体都是有声3D网页。主要画面由代码实时渲染,中文旁白来自语音合成,配乐和环境声也随项目打包。
虽然画面仍有明显的简化模型感,尤其是地球篇的古生物,以及盐田里的人物和器具,离提示词要求的电影级纪录片还有距离,但稍加打磨完全可以替代短视频了。
实测3:莫比乌斯巴士
第三个项目,把公交车开上了太空中的莫比乌斯环。外景镜头可以旋转观察整条公路,切到跟车视角,巴士沿着扭转的路面行驶,车身也跟着倾斜。坐进驾驶舱后,方向盘和挡风玻璃进入画面,前方的道路与远处星空一起在视野中翻转。沿途还会弹出站点卡片,提示停车与签到条件。
这个项目最有意思的,是把莫比乌斯环的空间特征做进了驾驶体验:绕一圈后上下颠倒,再绕一圈才恢复原来的姿态。巴士和驾驶舱的建模仍然比较简单,不过,道路形状、车辆运动与镜头变化能配合起来,已经有了一款小型太空驾驶游戏的雏形。
2
为什么不叫 V4.2-Flash,而是仅仅加个后缀
从 V3 到 V4,注意力机制和模型层间的连接方式都有改动;到了 V4.1-Flash,又引入了非对称的 Causal Encoder-Decoder 结构,让处理输入和生成输出采用不同的激活规模。
而这次 1017 则沿用了初版架构,主干参数仍是 552B,输入激活 8B、输出激活 16B 的规模也没变。
那么改进在哪里?
底座没更新,也实现了能力增强和成本下降,要解释这些变化,就得看后训练和任务执行效率上的改进。
自反馈强化学习
自反馈怎样帮助训练这种能力?官方尚未公布具体方法,我们可以顺着这类任务的特点,简单猜测下。
让 AI 写一个函数,通常可以用测试检查结果对不对。但让它做一个赛车游戏,麻烦就多了。
比如,车和赛道都画出来了,一开车却穿墙。碰撞修好了,再测一遍,才发现重新开始比赛时计时器没有归零。
每个功能单独看都不复杂,放在一起,问题就大了去了。模型需要根据前面的结果决定下一步怎么做,还得保证这些功能最后能配合起来运行。
一种可能的做法,是让模型在训练中参与检查自己的开发成果:对照最初的需求,找出没有完成的功能,判断前后的操作有没有冲突,再给出评价。
这些评价如果足够可靠,就可以转成训练奖励,用来调整模型参数,让"能够把项目做完整"的开发方式在之后的任务中更容易出现。
当场发现一个 bug 再把它修好,解决的是眼前的项目;把反馈用于训练,则是希望模型下次遇到类似问题时,也能做出更好的选择。
这条路线最难的地方,也在于评价是否可靠。模型得能发现自己哪里做错了,否则一份看似合理的自我评价,只会让它在错误的道路上越走越远。
给推理过程瘦身
API 按输入和输出的 Token 数量收费,模型完成任务时生成的内容少了,输出费用就会减少。能力提升与账单下降可以同时发生,关键要看它用了多少内容,完成了多少事情。
这对 Agent 尤其有用。开发一个项目,模型往往要反复读取文件、修改代码,再根据工具返回的结果继续处理。账单会把这些过程中的消耗都算进去,远不止用户最后看到的那段答复。
而且,一段内容可能不只计费一次。如果它被保留在历史记录中,后续调用又把这段历史发给模型,就会产生输入费用。
少生成一些冗余内容,既能减少当下的输出开销,也可能减轻后续读取历史的负担。
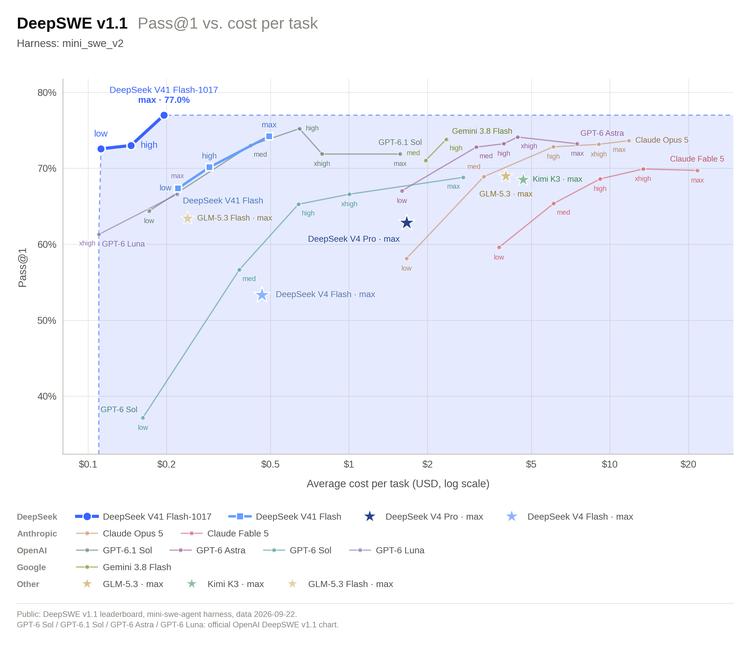
虽然缓存命中可以让重读便宜一些,但一开始别生成不是更便宜吗?
模型之外,把搜索和接入也补上
随着
举个例子,比如,让 Agent 给制作小程序,它需要去小程序开发网站找到相关文档,确认接口现在怎么用。
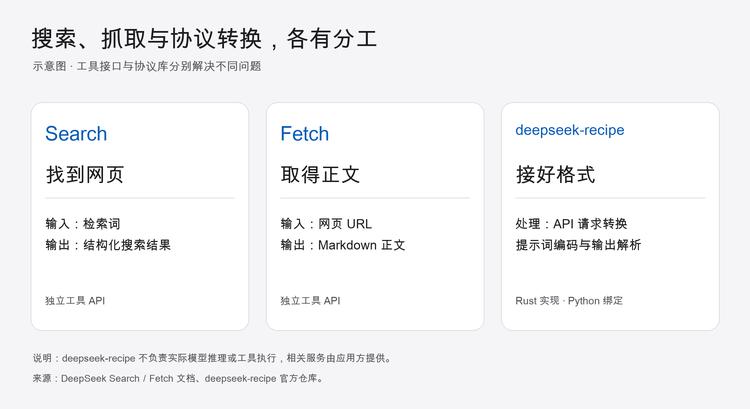
Search 负责按关键词找网页,返回标题、链接和摘要,帮助模型筛选资料。选定需要仔细阅读的页面后,Fetch 再根据网址抓取正文,整理成方便模型读取的 Markdown 文本。
一个负责找资料,另一个负责整理资料。
价格上 Search 和 Fetch 分别按每千次成功请求 5 元人民币计费,约合 0.75 美元。请求失败、搜索没有结果或抓取超时,都不收费。
3
可以不断走的一小步,也算一大步
回头看,
当然,这条路能走多远,还要看它给自己打的分准不准。这部分
不过,综合自反馈训练、推理瘦身,还有新开放的 Search 和 Fetch 接口,
底层架构的换代固然让人期待,但在现有底座上靠后训练提高能力,降低单次任务开销,是一条不需要等大版本就能一直往前走的路。
