

 搜索


导读: Google Research开源Harness²框架——不动模型权重,通过两层递归让智能体在执行中自我改写周边的提示词、工具、记忆等八个组件。单步优化在
模型没变,分数涨了11.5
大模型时代有个被默认接受的设定:想让AI变强,就得动模型——训练、微调、蒸馏,总之要碰权重。谷歌研究院10月9日挂到arXiv的一篇论文,把这个设定撬开了一条缝。
论文标题是《Harness²: Recursive Agent Harnessing for an Open World》,来自Google Cloud AI Research和西北大学。核心想法很直白:一个智能体的能力,一半在模型,一半在模型周围那圈"外壳"——提示词、工具、记忆、技能、编排逻辑。这圈东西叫harness。Harness²做的事,是让智能体在执行任务的过程中,自己改写自己的harness,而且不需要任何人告诉它"改对了没有"。
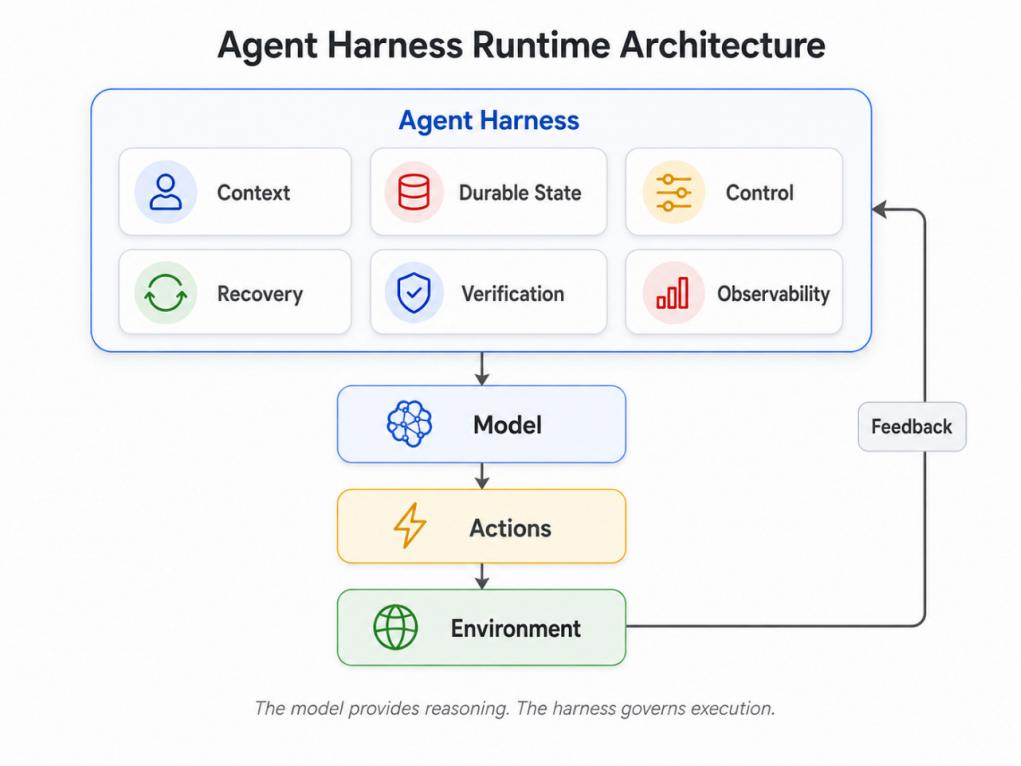
模型负责推理,harness(外壳)管执行:上下文、状态、控制、恢复、验证、可观测性
效果数字先摆出来:在
机制:两层递归,一层改当下,一层攒经验
Harness²的递归分两层,名字起得很学术,逻辑其实不难懂。
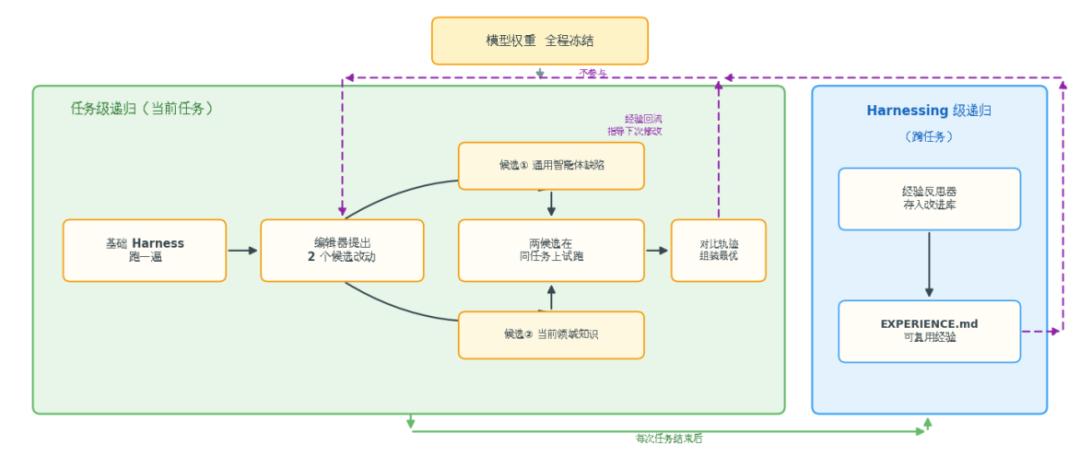
第一层叫任务级递归。智能体先用基础harness跑一遍任务,然后一个"编辑器"(默认是Claude Opus 4.8——对,谷歌的框架用Anthropic的模型当编辑器)提出两个修改方案:一个针对通用智能体缺陷(比如规划或工具使用),一个针对当前领域的专业知识。两个候选方案在同一件任务上分别试跑,最后由"组装器"对比三份执行轨迹,只保留有行为证据支持的改动。这一步叫Propose-Probe-Compose,整个过程不需要标准答案——靠对比行为差异来判断哪个改动真的有用。
第二层叫harnessing级递归,发生在每次任务之后。系统把被采纳的harness和一份经验笔记(EXPERIENCE.md)存进一个"改进库",下次遇到新任务时,这个库会指导编辑器提出更靠谱的修改。每个新任务仍然从基础harness出发,但编辑器已经"见过世面"了。
八个可编辑组件被挂载为文件:系统提示词、护栏、记忆、工具指南、子智能体、技能、脚本、插件中间件。预算参数k控制搜索深度,k=5的并行递归还能再多拿2.9到3.9分。
为什么现在值得看:弱模型的「逆袭通道」
最值得玩味的发现是:越弱的执行器,收益越大。GLM-5在
对开发者来说,这意味着优化智能体多了一条不烧钱的路。微调要数据、要算力、要等训练周期;改harness只需要几次额外的执行,成本低得多,见效也快。Harness²论文里的对比表显示,它在三个基准上全面压过了ReasoningBank(只改记忆)和Harness Scaling(只改单个实例)——因为前者只动一部分,后者没有跨任务积累,而Harness²两头都占了。
安全侧,团队自己也留了警示:框架会自动改写执行环境周围的文件,沙箱隔离得自己来配。论文明确说"这不是谷歌官方支持的产品",不享受漏洞奖励计划——翻译过来就是:代码给你了,出了事自己兜着。
往深想一层
Harness²的思路并不孤独。过去半年,"让AI自己优化自己"的递归自我改进(RSI)方向密集出成果:斯坦福的Meta-Harness离线搜索最优harness,谷歌自己的ReasoningBank做记忆复用,腾讯和清华的TreeOPSD用无评论家RL调长程智能体。Harness²的差异在于把"当前任务优化"和"跨任务经验积累"焊在了一起,而且直接开源了可跑的代码。
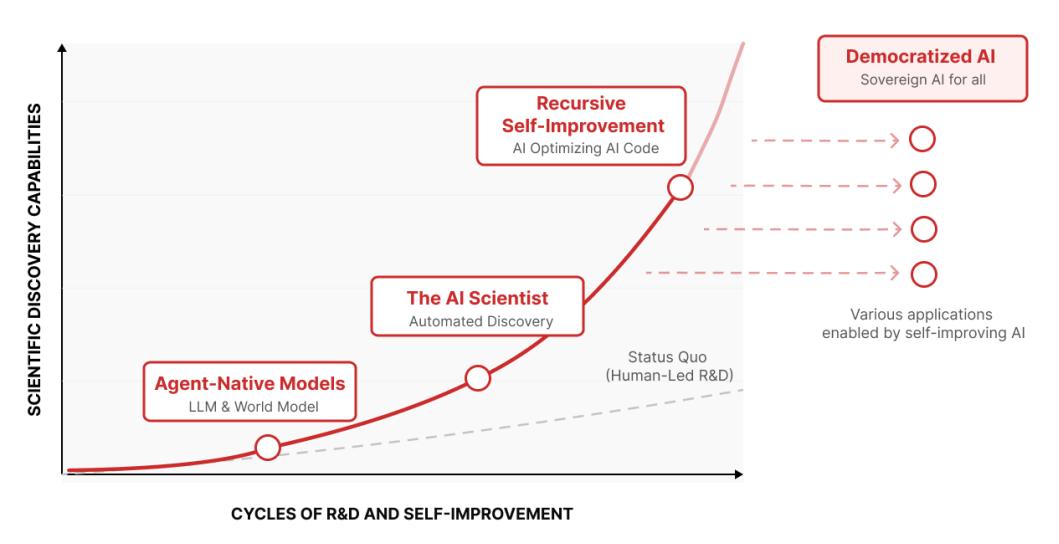
递归自我改进(RSI)正在成为主线:AI优化AI代码,能力曲线脱离人类研发的速度限制
但几个边界得先划清。所有提升数字来自论文自测的三个基准,测试集和真实世界的"开放任务"之间还有距离;每次优化意味着多跑几遍任务,token成本和延迟都会翻倍,对实时场景不友好;用Claude Opus 4.8当编辑器这个选择本身就说明,harness优化的质量上限取决于"改的人"有多聪明——如果编辑器模型不够强,改出来的外壳未必更好。
再往产业看,Harness²指向的趋势比单个框架更重要:当模型能力趋于同质化,竞争正在从"谁的模型强"转向"谁的脚手架更会进化"。这对算力有限的团队是好消息——你不需要最大的模型,只需要最会自我调整的harness。对模型厂商来说,这则是一个微妙的信号:如果外壳优化的边际收益足够高,模型的差异化优势会被进一步压缩。
结尾
Harness²的名字起得恰如其分——harness是马鞍,是让马跑起来的那套装备。谷歌这篇论文证明的是:马鞍可以自己调整,而且调着调着,马会越跑越好。模型权重不动,分数照样涨,这个思路一旦跑通,AI优化的成本结构就要重写了。
Apache 2.0开源,代码已经在GitHub上,接下来要看的,是社区能不能把这套东西从论文里的三个基准,搬进真实世界的脏活累活里。
