

 搜索


MiniMax开源M3.1 Flash:428B参数,上线72小时处理Token超100万亿
5 小时前
/ 阅读约2分钟
来源:凤凰网
10月23日,MiniMax开源M3.1 Flash模型,参数提升,通过三项优化提升推理效率。上线72小时内真实用户处理Token量超100万亿,已接入多家芯片厂商及推理和云服务平台。
凤凰网科技讯(作者/云飞) 10月23日,MiniMax宣布开源M3.1 Flash模型权重,总参数428B,激活参数23B。
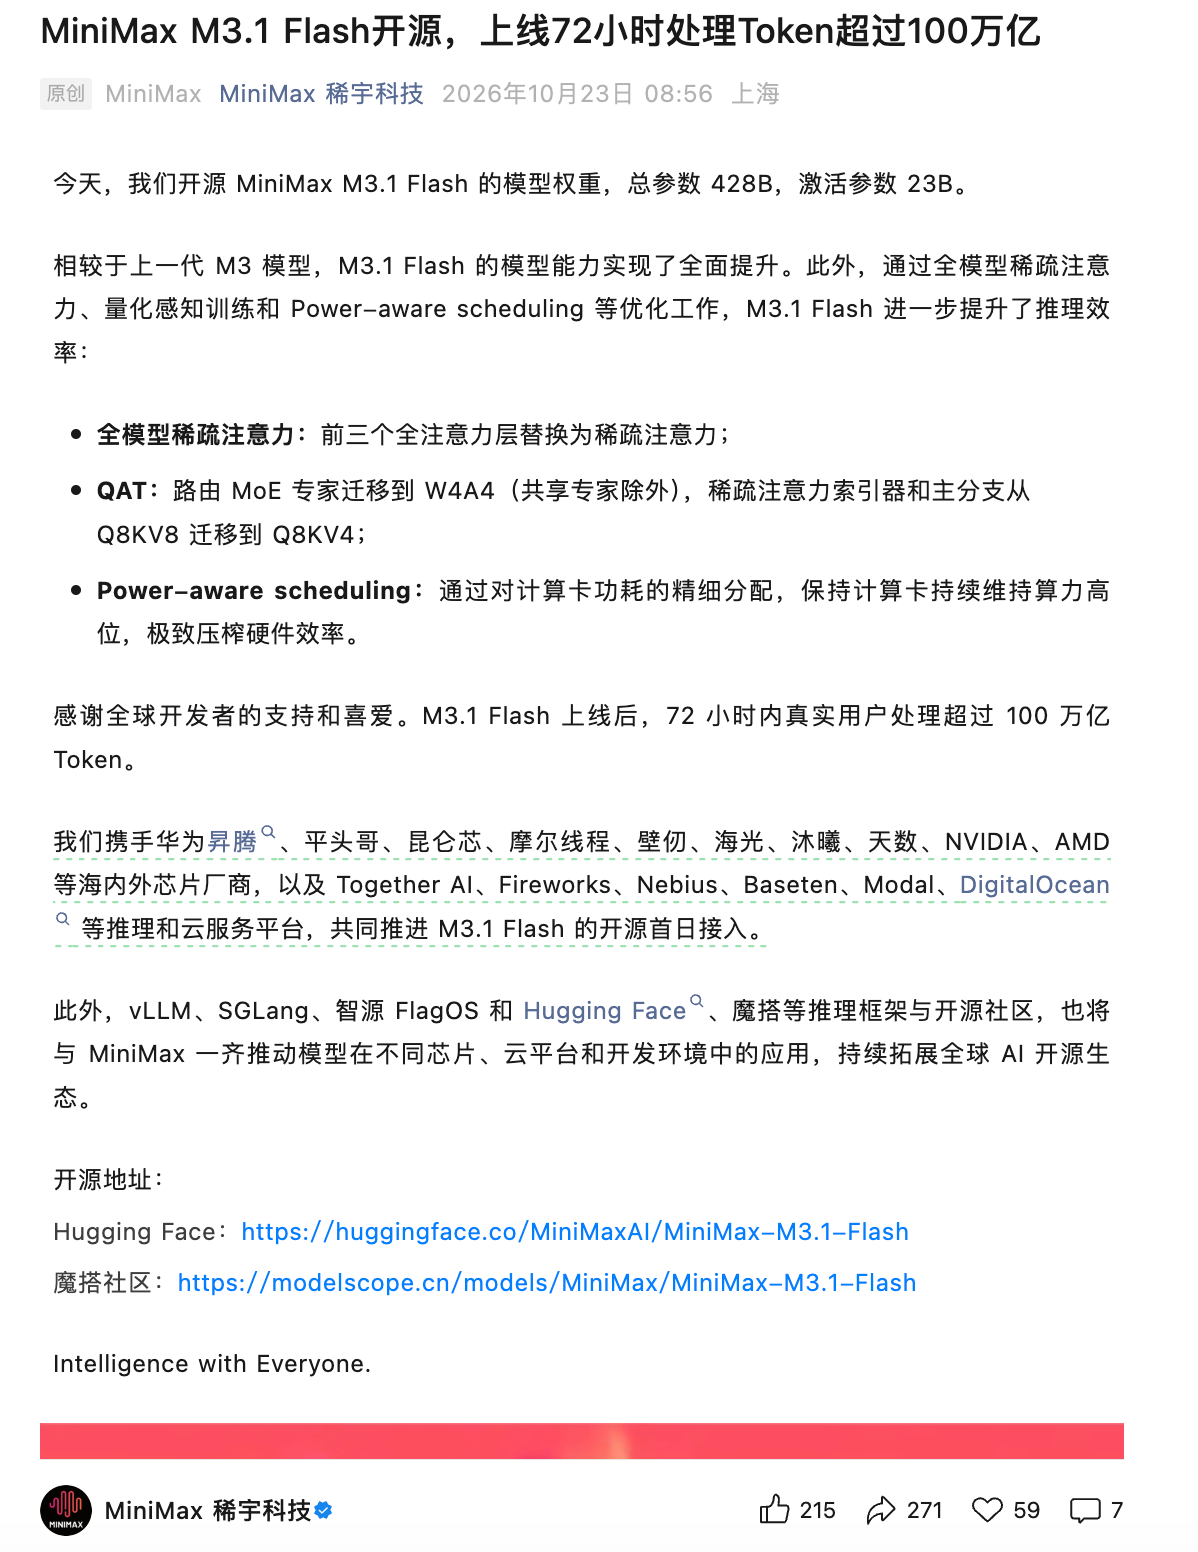
相较于上一代M3模型,M3.1 Flash能力全面提升,并通过三项优化提升推理效率:将前三个全注意力层替换为稀疏注意力;将路由MoE专家迁移至W4A4精度(共享专家除外),稀疏注意力索引器和主分支从Q8KV8迁移至Q8KV4;采用Power-aware scheduling对计算卡功耗精细分配,以维持算力高位运行。
据MiniMax披露,M3.1 Flash上线后72小时内,真实用户处理Token量超过100万亿。该模型开源首日已接入华为昇腾、平头哥、昆仑芯、摩尔线程、壁仞、海光、沐曦、天数、NVIDIA、AMD等芯片厂商,以及Together AI、Fireworks、Nebius、Baseten、Modal、DigitalOcean等推理和云服务平台。vLLM、SGLang、智源FlagOS及Hugging Face、魔搭等推理框架与社区也将同步推进该模型在不同芯片与开发环境中的应用适配。
