

 搜索


摘要:
外界或许更关心的是,已经变成AI信徒的王兴兴,究竟何时才能端出宇树自己的AI能力?
凤凰网科技 出品
作者|路春锋
编辑|董雨晴
最近几天,宇树科技一反之前的颓势连续上涨,最新股价距离10月15日盘中最低的404.3元/股累计反弹超过54%,特别是今天直接20厘米涨停,报624元/股,市值再破2524亿。
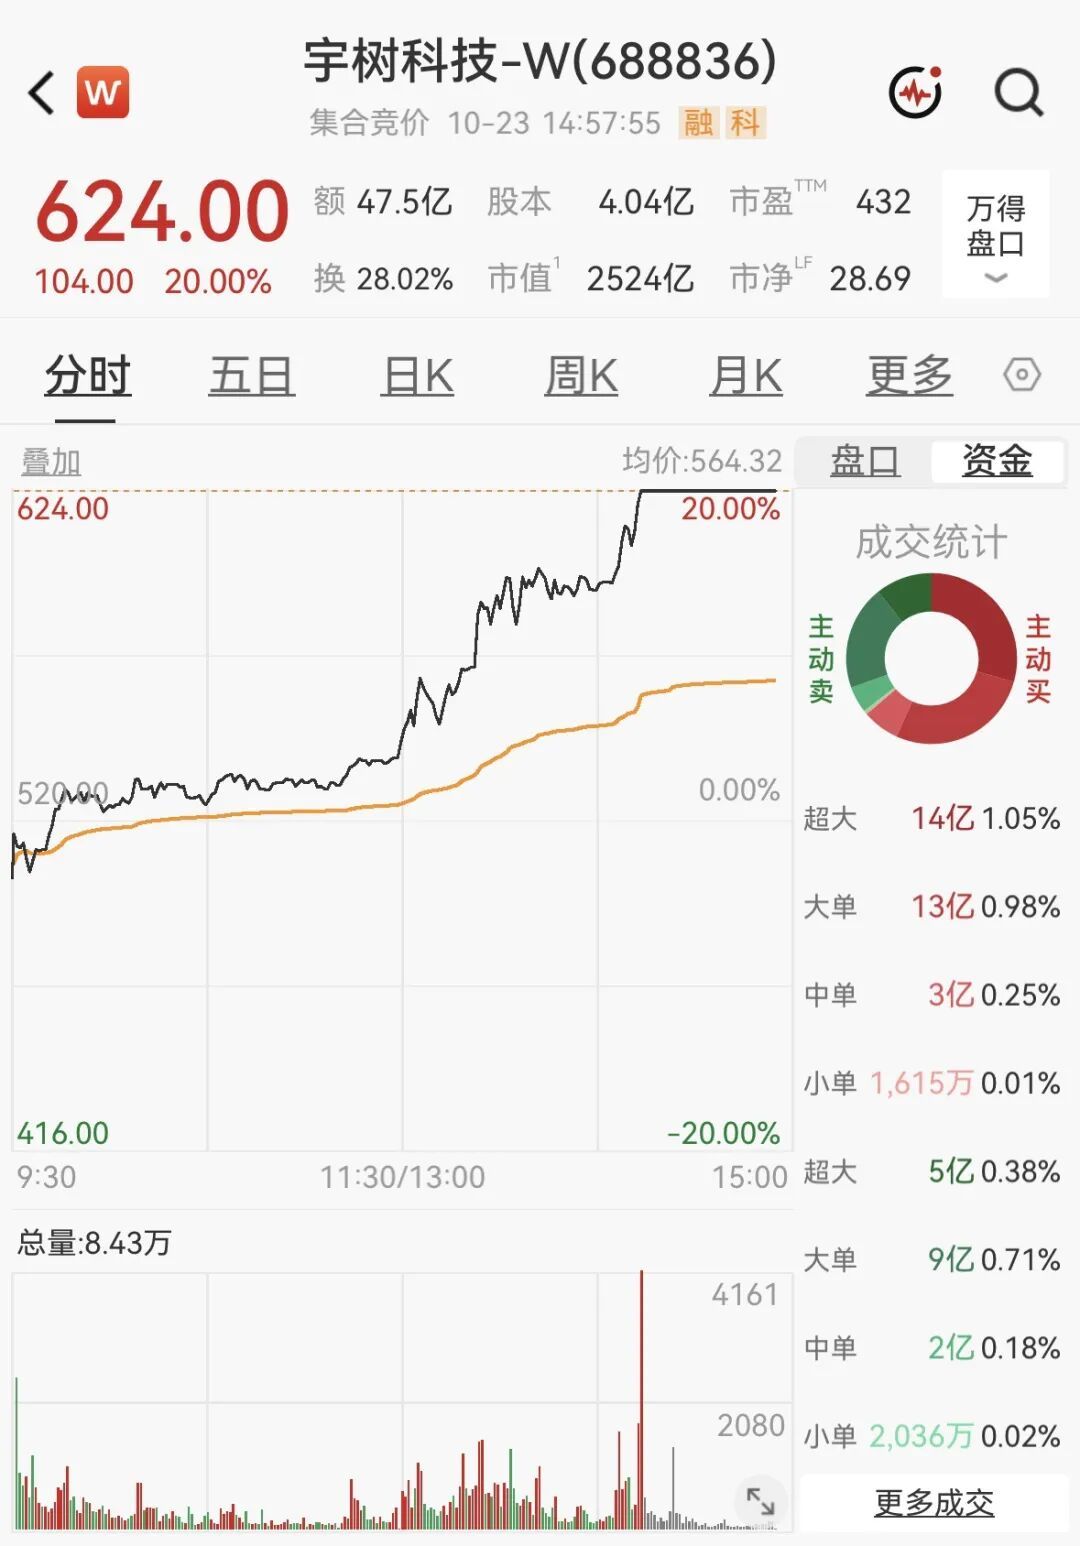
图|源自Wind
与暴涨情形一同发生的,是宇树刚发布了定位成“保镖”的H2-X功夫传奇机器人,在演示视频里,它扛起了汽车、还飞踢肘击,在负载力方面教以往的跳舞形态有了很大进步,显然还在尝试突破物理硬件极限。
而在刚刚举行的2026世界物理AI大会暨宇树合作伙伴生态大会上,王兴兴几乎用超过90%的篇幅在演讲里大谈特谈AI。
他说,“全世界包括他自己对AI的信仰都还不够”;“同事如果更关注AI,身价可能增长十倍甚至几十倍”;“真正看懂尖端AI模型潜力的人可能只有几千人”;“物理AI已经看到被击穿的苗头,快则1到2年,慢则2到3年……”
这和几年前的王兴兴几乎是全然不同,自2016年创业至今,王兴兴花了更多的精力和心思耗在对硬件的钻研上。
从这一次大会演示来看,宇树已经在推进自研物理AI模型和机器人自进化体系,但现场最直观的绘画、下围棋等演示,主要基于GPT-6 Astra的测试结果。
外界或许更关心的是,已经变成AI信徒的王兴兴,究竟何时才能端出宇树自己的AI能力?当人形机器人的硬件能力不断进步,宇树能否把自研AI从技术路线变成真正的产品能力,将成为下一阶段的重要考验。
王兴兴处处都在说AI,但宇树的AI在哪里?
遗憾的是,王兴兴反复强调AI,但在宇树生态大会上,能站得住的自研AI成果并不多。
这两天,宇树在杭州举办了十年来的第一场生态大会。新发布的Unitree H2-X很吸睛:轻松翻越汽车、飞踢肘击能把车门砸出坑、徒手抬车、从4米高台跃下平稳落地,官方称续航最长8小时。
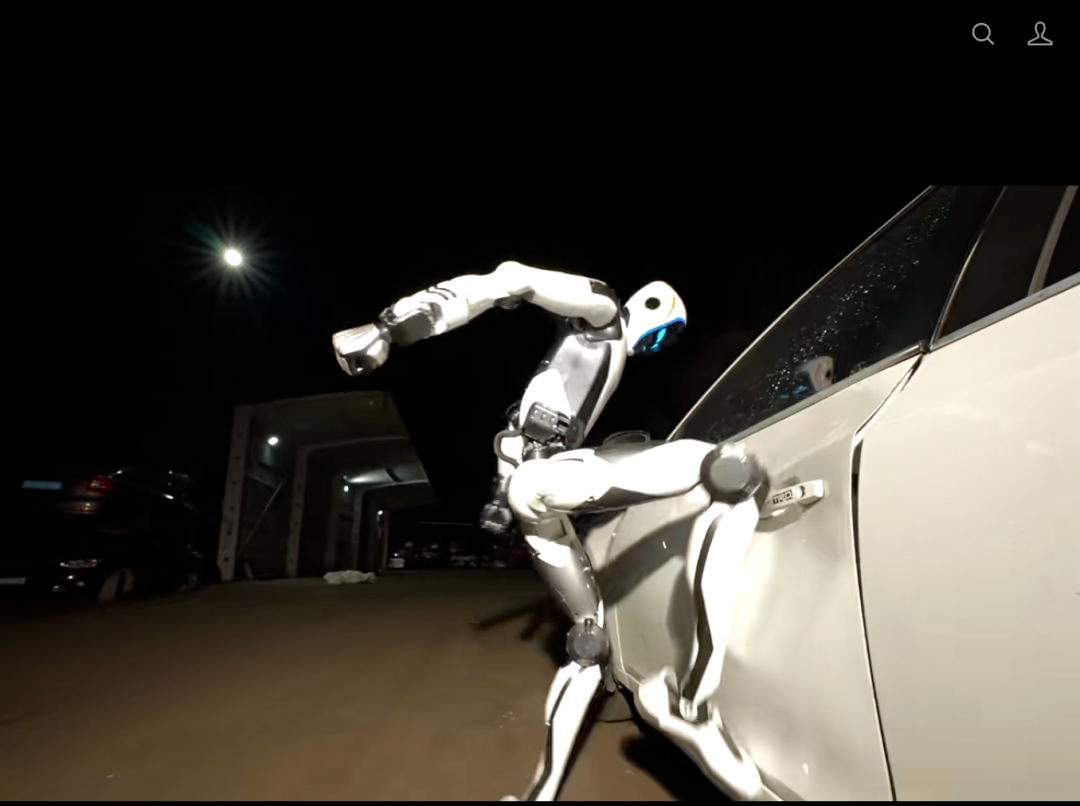
图|源自宇树官方视频号
不过,这些动作证明的依旧是宇树在硬件、运动控制和动作编排上的能力,而不是王兴兴极度看重的AI。
这场大会的主论坛主题叫“世界物理AI大会”,王兴兴的演讲题目是《相信,尽可能相信AI》。他几乎把整场演讲都压在AI上:全世界对AI的信仰还不够,包括他自己;四五年前他曾提醒同事关注头部AI公司股票,如果当时相信,个人财富可能已经增长十倍甚至几十倍;真正看懂尖端AI模型潜力的人可能只有几千人;物理AI已经看到被击穿的苗头,快则1到2年,慢则2到3年……
他越强调AI,观众就越期待看到宇树的AI成果;可落到现场,真正拿得出手的演示却并不来自宇树自研模型。
图|王兴兴演讲
首先得说,宇树是有自研AI产品的。9月,宇树曾发布通用人形机器人基础模型UnifoLM-WLA-1.0。此次大会上,王兴兴进一步介绍了正在预研的“物理AI机器人自进化V1.0”。
他还把“物理AI机器人自进化V1.0”,作为今年最重要的预研方向——让AI自主查论文、写代码,在仿真环境中训练,再进入真实机器人测试,并通过AI或人工打分反馈,形成持续迭代闭环。
但预研框架不等于已经跑通的模型,技术路线图也不等于已经落地的能力。
现场最直观的AI演示,反而来自GPT-6 Astra:机器人在零训练条件下完成绘画、洗笔、换颜料、下围棋、室内导航。王兴兴自己也承认,大模型已经能较好解决规划和导航,但真正动手操作时仍然容易出错。
这说明,外部大模型确实能驱动机器人完成部分任务,但也暴露了宇树自研模型尚未站到台前。
更重要的是,UnifoLM-WLA-1.0发布已一个多月,但在这次大会上却没有一个基于该模型的现场实操演示。观众看到的仍是GPT-6 Astra驱动的画面,而宇树自己的模型扔欠缺真刀实枪的落地。
准确的说,宇树的AI不是没有,只是还没真正走到舞台中央。
它已经搭好了骨架——模型、数据、评测、开源生态都在推进,但离“让机器人听懂一句话就去干活”还有距离。王兴兴预测具身智能的“ChatGPT时刻”最快2027年到来,这意味着宇树给自己留了一年多的追赶窗口。
问题是,窗口期里,对手不会停下来等。
硬件可以持续迭代,但智能能力才是下一道关
宇树的硬件优势是真实的。H2-X能抬车、能飞踢、能从4米高台跃下,续航8小时,运动控制能力放在全球人形机器人里也是第一梯队。
但硬件在中国没有壁垒。电机、减速器、控制器、激光雷达,供应链已经成熟,后来者靠工程迭代就能快速追上。如果恰巧去过2026世界机器人大会现场,许多人的第一感觉就是:能唱会跳的人形机器人随处可见,根本不是哪一家的独门绝技。
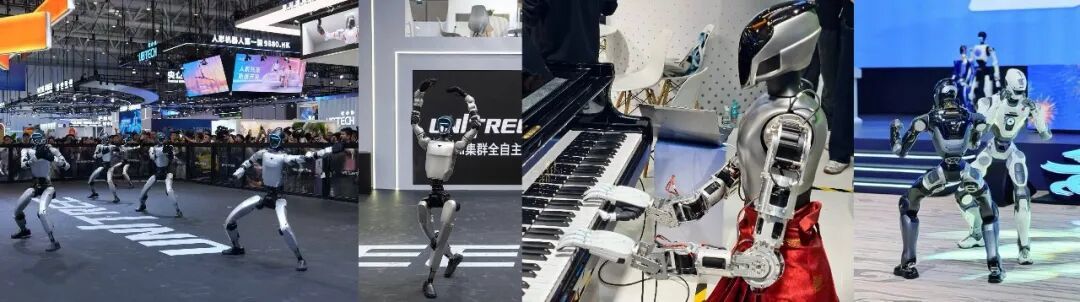
图|源自世界机器人大会,现场好似菜市场
所以,靠持续改进硬件来维持一定的先进性,这对宇树来说是远远不够的。
真正决定谁能留在牌桌上的,是智能能力。
王兴兴自己把这道坎说得很清楚。他给具身智能的“ChatGPT时刻”下了一个量化标准:在约80%的陌生场景中,通过自然语言指令完成约80%的主要任务。这个标准不低——它意味着机器人要从“特定场景下的演示品”变成“通用环境中的可用产品”。
难点在于,大模型让机器人更会“想”,但做家务不是聊天。
王兴兴承认,目前大模型已经能较好解决规划和导航,但真正动手操作时仍然容易出错。核心瓶颈是AI模型的输入输出与真实机器人之间的对齐:传感器读数有偏差,关节响应有延迟,抓取力度、摩擦力、遮挡和光线变化都会带来误差。
拿起一枚象棋也许不难,但要把细小零件装配到位、把易碎杯具稳妥放进洗碗机,最后几毫米的误差就可能决定成败。
更麻烦的是泛化性。当前AI模型在固定场景里经过充分训练,成功率可以接近100%;可只要物品位置、形状或环境稍变,成功率就可能明显下降。
家庭场景恰恰是最不“配合”的:桌面每天不同,老人小孩宠物随时改变空间状态,任务也常常模糊——“收拾一下客厅”听起来简单,背后包含识别、规划、抓取、移动、避障、纠错和失败重试。机器人不能只完成一次漂亮演示,它必须在陌生环境里反复成功。
这正是宇树自研模型需要证明的地方。
9月发布的UnifoLM-WLA-1.0是6B参数的具身多模态大模型,基于约2500小时真机数据训练,单模型统筹64项任务,在多项具身推理评测中领先开源模型。
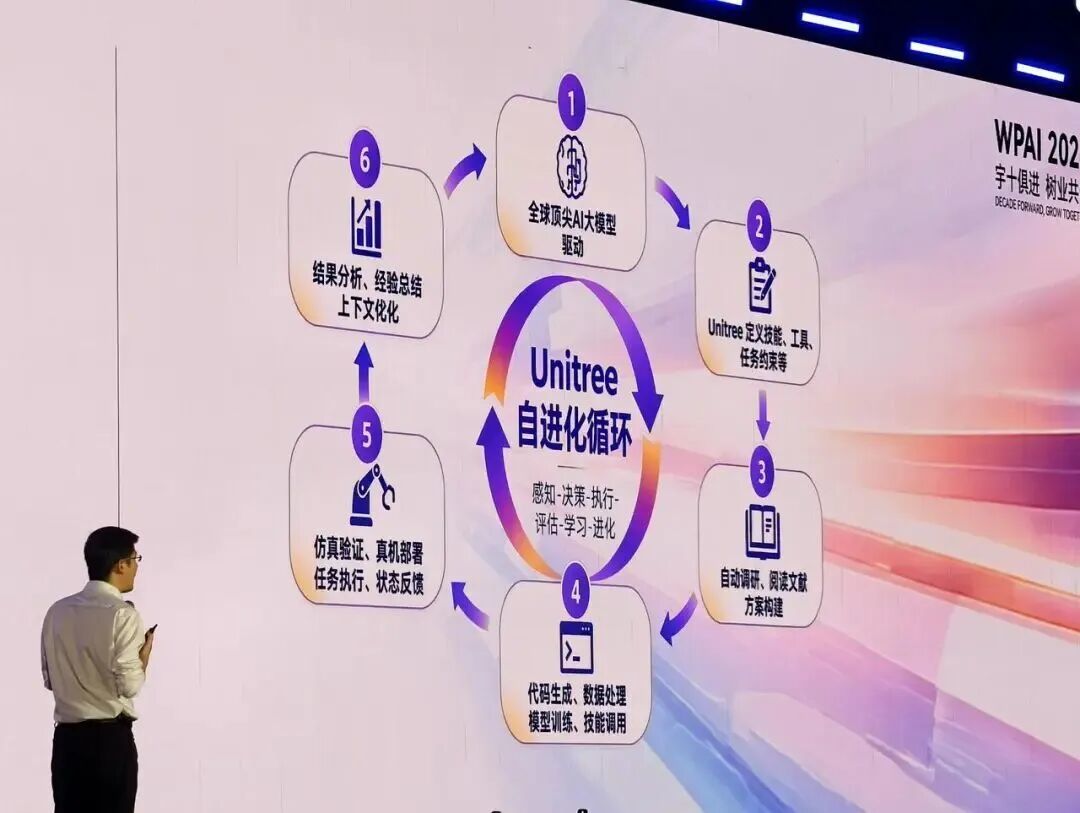
图|王兴兴讲解宇树自进化系统的运作机制
但评测领先不等于现场能打。UnifoLM-WLA-1.0发布已一个多月,这次大会上却没有一个基于该模型的现场实操演示。观众看到的仍是GPT-6 Astra驱动的画面。
这恰恰说明,宇树的自研模型还差一次“现场证明”。发布模型、提出技术路线、搭建算力集群,与证明模型的实际能力,是两回事。真正值得关注的,是自研模型能否在真实机器人上稳定完成任务,能否适应陌生环境,又能否根据执行结果持续改进。
招股书显示,宇树2023年至2025年三年合计研发费用约2.65亿元,相较于AI大模型公司在研发层面的投入,这样的资金完全不在一个量级。王小川曾透露过,一个千亿级参数大模型单次训练成本在3000万至5000万元人民币之间。而多位具身赛道从业者也向凤凰网科技感慨说,具身大脑投入巨大,日消耗在百万元级别。
机器人“会打架”已经实现,但离“会过日子”还有一段路。对宇树而言,下一阶段的竞争,不只是让机器人做出更惊艳的动作,更是让自研AI真正转化为机器人的执行能力。
到那时,人们评价一台机器人,大概不会再问它能不能扛车,而是会问:它能不能在我出门前,把厨房收拾干净,并且不把猫吓跑?
