

 搜索


GPU Kernel 优化,并不是简单地把一段可运行代码改得更快。面对真实生产环境中的 Kernel,coding agent 需要在硬件指令、内存布局、并行策略和整体架构之间反复探索,虽能在初期取得进展,但会逐渐转向更容易实现、性能上限较低的方案,最终陷入局部最优。
为解决这一问题,加州大学伯克利分校(UC Berkeley)团队提出了“持续进化 agent 团队”(EvolvingAgent Teams)。他们认为,与其增加 agent 数量,不如让中央监督器根据当前瓶颈,逐轮重组 agent 团队,调整角色分工、协作方式和知识管理策略。
论文链接:https://arxiv.org/abs/2610.36848
整个Evolving Agent Teams 框架分为两层:底层 agent 团队负责编写、编译、测试和分析 Kernel;上层监督器则观察优化进展,分析成功与失败的原因,并决定下一轮如何调整。
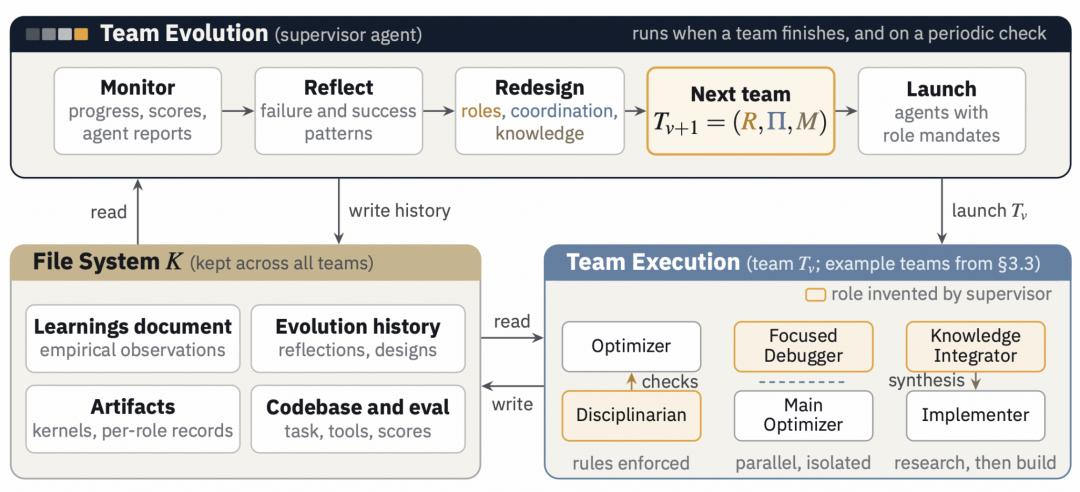
图|Evolving agentTeams 框架
如果 agent 团队在调试过程中遇到瓶颈,监督器可以引入Debugger;如果缺乏性能数据作为优化依据,则加入 Profiling Scientist;如果早期发现未能传递给后续 agent 团队,则加入 Knowledge Integrator,负责整理实验记录和行动计划。同时,系统还维护了一个跨团队持久化文件系统,用于保存代码、角色记录、失败尝试、硬件观察和已验证策略。
MLA paged decode Kernel 展示了这一机制如何帮助 agent 团队突破局部最优。MLA 是
为避免 agent 团队过早放弃,监督器加入 Disciplinarian,要求agent 团队保留 WGMMA 约束,且每次只做一项能够明确评估效果的修改。之后,任务被分配给并行运行的 Debugger 和主优化 agent:前者验证难以实现的矩阵乘法路径,后者则继续推进其他优化工作。
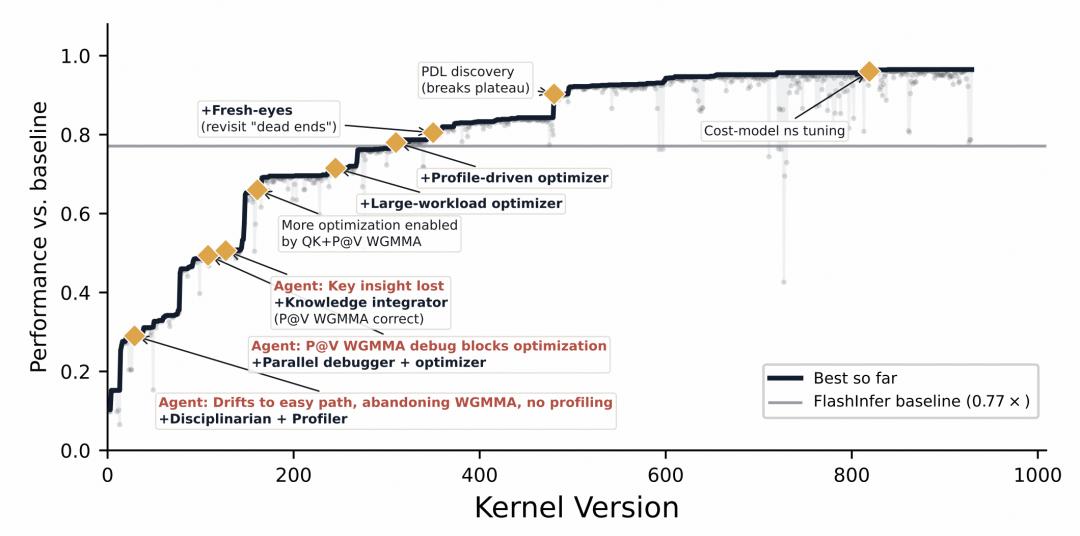
图|使用 Claude Opus 4.6 对 MLA decode Kernel 进行长时间优化的过程
当监督器发现早期实验中的关键发现没有传递给后续 agent 团队时,便会引入 Knowledge Integrator,建立跨团队经验文档。这最终帮助 agent 团队验证了 P@V WGMMA 路径。完成核心架构调整后,监督器还会要求重新进行 Profiling,进一步优化性能。
在四项 CUDA Kernel 任务中,Evolving agent Teams均超过了强 coding agent 基线。这些任务覆盖 NVIDIA B200 和 H100GPU,包括 FlashAttention-4、Gated Delta Net prefill、MLA decode,以及 GEMM 与 AllReduce 融合。
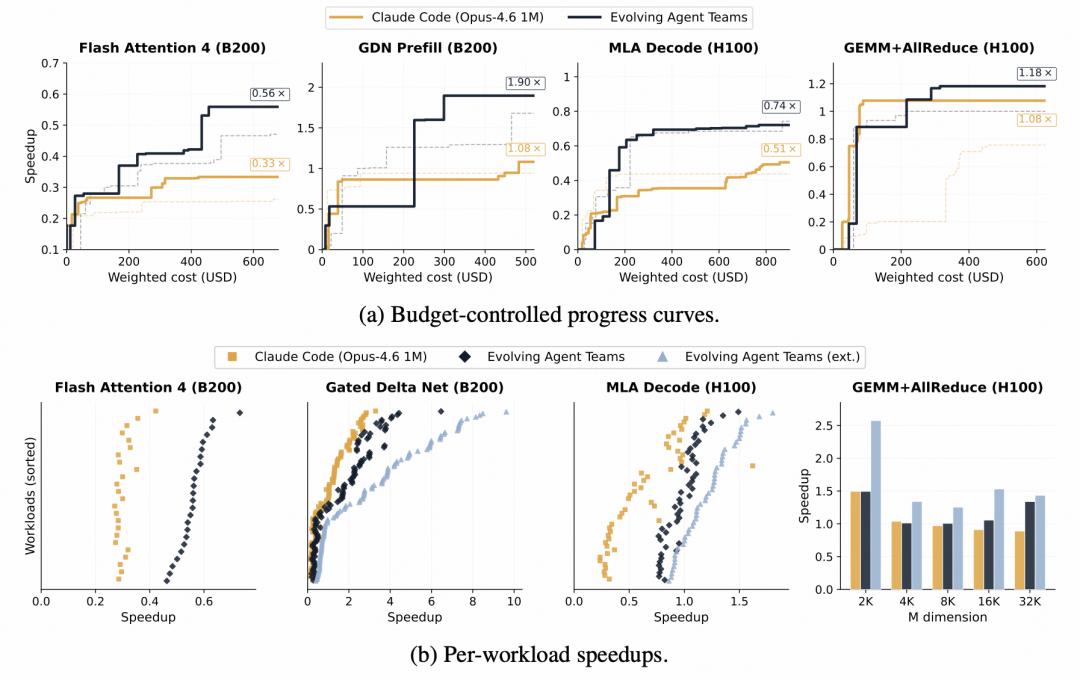
图|四项 Kernel 任务的性能对比
在相同Token 预算下,MLA decode 任务中,Claude Code 的性能约为生产环境 FlashInfer Kernel 的 51%,Evolving Agent Teams 则达到 74%。相比之下,固定四角色团队为 31%,Codex 单 agent 为 28%。这表明,性能差距不仅来自底层模型能力,也取决于 agent 团队能否随任务阶段变化而调整组织方式。
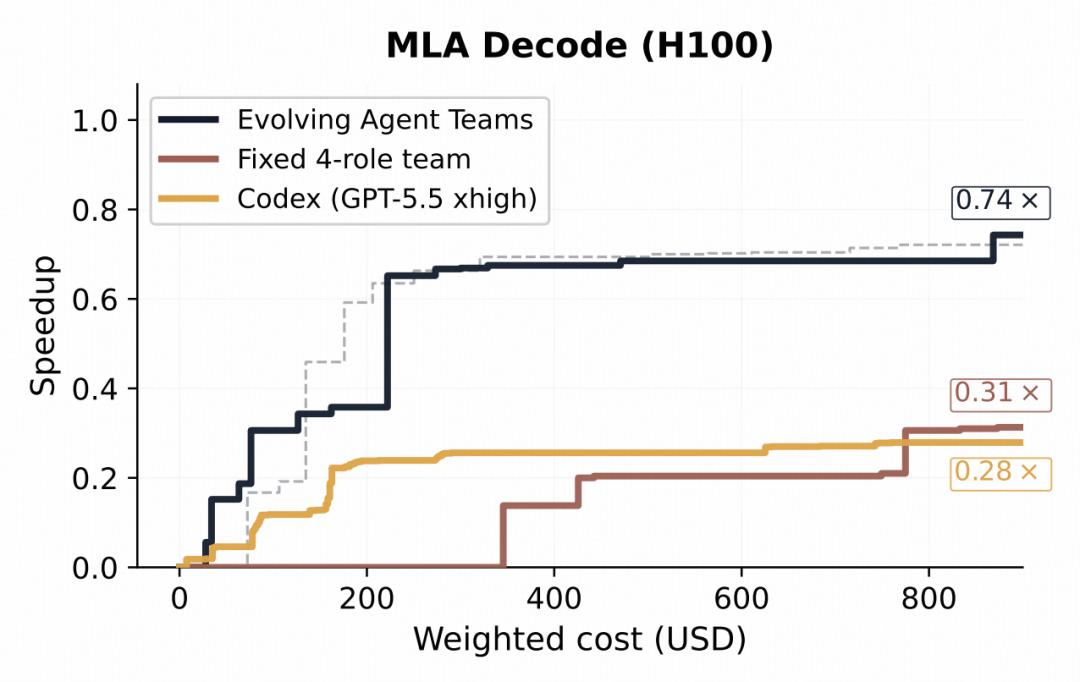
图|MLA解码消融实验
在投入更多推理预算后,Evolving Agent Teams 生成的 MLA Kernel 在 FlashInfer-Bench 的 47 个生产负载上,平均性能达到 FlashInfer的 1.21 倍,其中 36 个负载超过生产环境 FlashInfer Kernel,其余 11 个负载则处于 FlashInfer 的 0.86 到 0.99 倍之间这意味着,仍有部分负载存在差距。
随着运行时间延长,agent 团队在 Gated Delta Net prefill 上取得 4.06 倍平均加速。在 GEMM 与 AllReduce 融合任务中,它们逐步推进异步加载、Warp Specialization 和 NVLink multicast,最终达到基准性能的 1.56 倍,略高于 ThunderKittens 报告的 1.54 倍。
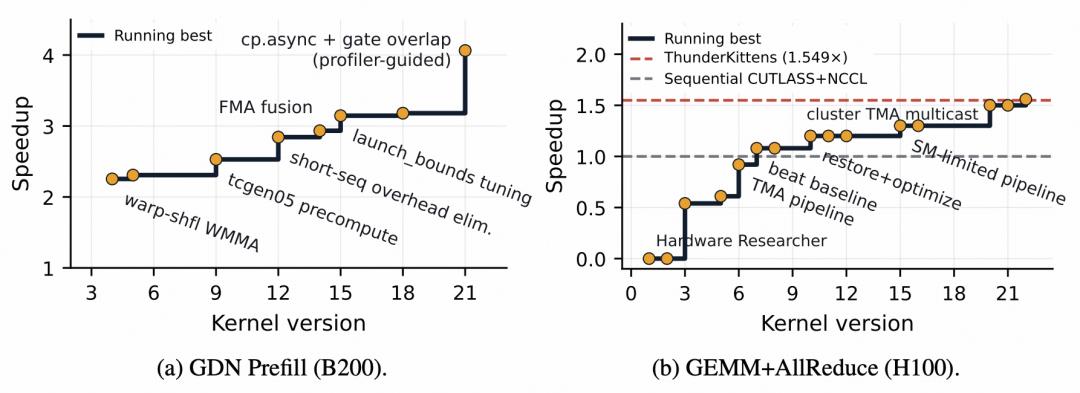
图|GDN 和 G+AR 在额外预算下的演化轨迹
在 Flash-KMeans 实验中,agent 团队将专家优化过的 Triton Kernel 改写为 CUDA WGMMA Kernel,在计算受限配置下最高将延迟降低约 1.5 倍,在内存受限配置下则与 Triton 结果接近。这说明,该框架在已有专家优化实现的基础上,同样具有进一步探索和改进的能力。
在其他场景中,agent 团队也取得了不错的结果:在 AMD MI350X 上将
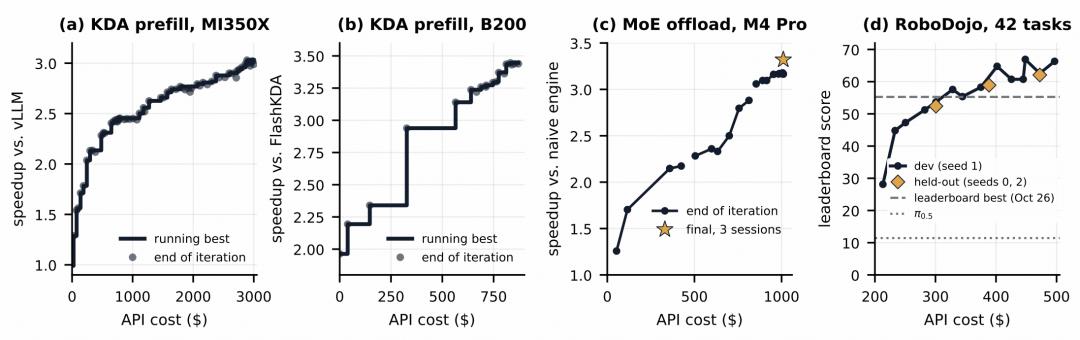
图|另外四种设置下的完整运行结果
不同于单纯增加推理预算,这些结果指向另一个方向:对于长程、开放式的代码优化任务,瓶颈不仅在于 agent 能否提出更好的修改,也在于当前 agent 团队是否拥有适合这一阶段的角色、协作协议和经验结构。Evolving Agent Teams 试图调整搜索过程本身。
不过,这项研究仍有一些局限。四项主要实验各运行两次,其他场景大多只进行了一次实验,尚不足以支持充分的统计比较。团队表示,后续工作还应包括成本与性能之间的 Pareto 分析,以及更高噪声领域中的受控研究。因此,当前结果更适合被理解为长程 agent 优化任务的系统设计探索,而不是已经普遍验证的 agent 团队协作规律。
