

 搜索


11月11日,
从10月开始,关于阿里Qwen4的消息就陆续传出。此前,匿名模型Kalmia现身大模型盲测平台Arena,被广泛猜测是Qwen4;有关其游戏开发能力的内测结果,也在社交媒体上流传。
官方也在持续预热。11月6日,
但同期大模型领域,腾讯已经先行一步。11月4日,姚顺雨掌舵的腾讯混元发布Hy4,宣称跻身最强开源模型之列。接下来,轮到刘大一恒交出答卷了。他手中的Qwen4,能否让
01 Qwen4想用大参数追高、小模型补缺?
11月9日,一份游戏开发创造力评估榜单GameFeel Bench在圈内热传:代号hawk的Qwen-4-Flash-Early API在内测中拿到49.9分,压过Opus 5.5 xHigh的47.2分;Qwen-4-27B-Early拿下44.6分,距Sonnet 5.5仅差0.4分。
据称,测试团队在Qwen4正式发布前就拿到了内测API Key,覆盖Flash版和27B部署版。不过,这份第三方榜单仍需谨慎看待。GameFeel Bench在GitHub上只有12颗星,7项评价指标中有4项依赖人工打分,结果难免受主观判断影响。
Qwen4-Max预览版发布后,我们进行了一番实测,并要求它根据第四波科技智库的主题、风格,做一个网站首页页面,首页呈现方式请适配科技智库定位,布局、交互形式请大胆创新。首页栏目包括Deep Brand、智库报告、科技资讯、品牌动态、活动、关于我们等。
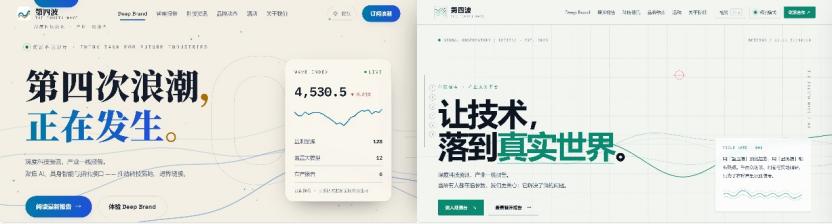
(左/Qwen4-Max预览版;右/Hy4)
约10分钟后,Qwen4-Max预览版交付了一版首页。页面结构齐全,还提供了“夜航”和“纸面”两套主题。不过,首屏没有为最新资讯预留板块,主视觉区域(Hero)的标题占据了近三分之一屏,又缺少向下滚动的提示,读者可能停留在首屏便离开。整体来看,作为初稿,这版首页相对完整。
我们又用同样的提示词,让Hy4制作了一版,框架、色系都有不少变化,右侧卡片从品牌相关指数改为公司方法论介绍。就这一次输出而言,Hy4版的页面视觉完成度更高,鼠标跟随、卡片变色、下划浏览等交互细节也做得更丰富(下滑浏览等动态截图未体现)。
这种基础的网页设计其实很难区分模型的上限,我们又尝试让模型视觉化表达“在噪声里识别出信号”:起始是一团无序粒子,逐渐收敛成一条有方向的结构,生成一段5秒左右的3D动画网页。
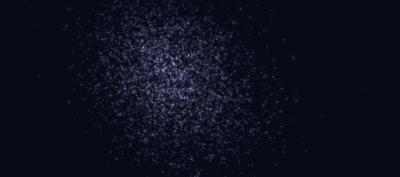
Qwen4-Max预览版制作
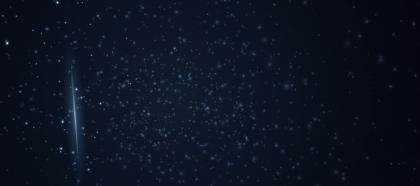
Hy4制作
从画面效果上看,Qwen4-Max预览版生成画面收敛得较粗糙,结尾颜色过曝;Hy4通过一个从左往右移动的旋转光效来表达识别这个过程,相对精致。
榜单和实测只能反映模型的部分能力,上述对比也会有主观的地方。要理解这些表现背后的技术变化,还得看看架构。阿里已于8月26日开源Qwen3.8-Flash-Next,作为Qwen4的架构预览,其技术报告显示,它的激活参数量约为上一代旗舰Qwen3.5-397B-A17B的三分之一,训练Token数量和训练计算量(FLOPs)均约为其九分之一。其用更少的算力,取得接近甚至超过上一代旗舰的测试成绩。
大参数与小模型,对
从Qwen3.8-Max的2.4万亿参数,到业内猜测Qwen4的3万亿,再到Qwen4.5、Qwen5规划的5万亿至10万亿,跻身第一梯队绕不开参数竞赛。同时,1.5B、3B、8B、27B等中小参数模型仍在持续开源,把能力铺到闭源体系覆盖不到的地方。刘大一恒在前不久的乌镇峰会上就解释道:头部闭源企业不会关注例如小语种、小众垂类应用、特殊硬件芯片适配等细分领域的问题。这些短板就需要开源中小参数模型补齐。
02 同期上线,看什么?
1993年生的刘大一恒与1998年生的姚顺雨同为“90后”技术高管。一位从Qwen早期预训练一路做上来,接任后第一次要为全新一代模型负责;另一位从OpenAI空降腾讯,直接统筹腾讯混元大模型与AI基础设施核心研发工作。
两家的全新一代模型又恰好撞档。早在8月底,26日阿里放出Qwen3.8-Flash-Next提前亮出Qwen4架构,两日后腾讯发布并开源Hy4 preview,两家的新模型对决就已经起手。
9月云栖大会上,接任
其中,模型自我改进项,即把递归自我改进(RSI)引入Qwen4的训练流程。任务越长、步骤越多,模型在执行过程中积累的真实反馈数据也越丰富,训练系统便有机会从中筛选出可用于下一轮训练的材料。
不过,RSI并非
作为同期对比的模型,长上下文方面,Hy4与Qwen4预览架构的技术选择颇具代表性。Hy4采用Gated
技术路线之外,两家比拼的另一战场,是谁先走进真实工作场景。刘大一恒强调的全模态能力,不止于“看懂图像、理解视频”,还包括将视觉感知与Agent行动结合,让模型根据现实环境中的信息连续执行任务。
腾讯混元的Hy4则首次引入视觉理解能力,并具备电脑操作(Computer Use)能力,可以结合命令行与图形界面模拟真人操作电脑,完成办公、开发等工作。
模型架构展示了模型处理信息的思路,但对于即将露面的Qwen4来说,它需要证明自己在实际任务中的能力。回归到场景里,用户只看模型能否可靠地调用工具,完成复杂的长程任务,并交付符合要求的结果。
