
 搜索

此刻,具身智能哑火,基座大模型训练遭遇瓶颈,决定AI产业的命脉英伟达CEO离职。一片坏消息里,RSI 成为最火的概念。甚至硅谷已经火到在反思是不是“过度炒作”。
据 RSI List 网站统计,截至2026年11月13日查询时,其目录已收录39家RSI相关创业公司,其中20家成立于2025年及以后。这些公司累计记录融资约56亿美元,其中有明确融资日期的轮次合计约53亿美元,约74%发生在2026年。
需要注意的是,RSI List 的收录范围不仅包括严格意义上的递归自我改进公司,也涵盖自动化AI研究、Agent自我改进及相关基础设施企业。
半年内,国内也快速跟上,创业公司超衍智能创立三个月,累计融资近4亿元人民币;超进化智能成立两月,也官宣数亿元人民币融资。大厂里,阿里、腾讯、智谱也都纷纷官宣了自己的RSI布局和工程实践。
5月,TechCrunch以《RSI is the new AGI》为题,称RSI正成为AI圈的新热点,几个原本分散的技术进展、创业公司和顶尖研究者,开始朝着同一个目标汇合——让AI越来越多地接管AI研发,最终形成自我改进的循环;
7月,Thinking Machines Lab联创翁荔回归OpenAI,领导一支加速内部研究的团队,参与RSI探索;
9月,Anthropic CEO Dario Amodei在一封公开信中呼吁放慢前沿AI的开发节奏。他给出的第一个理由就是RSI——AI已经开始帮助建造下一代AI,这个自我强化的循环“可能很快超出人类理解和控制的能力”。Sam Altman和Elon Musk随即都公开表示赞同;
随后,OpenAI发布了一份政策提案,呼吁由美国牵头制定前AI的全球技术标准,其中明确把“递归自我改进”列为需要标准化评估的对象;
接着,一份参与者包括图灵奖得主Hinton、Bengio、Barto和OpenAI首席科学家、Anthropic联合创始人、微软首席科学官Eric Horvitz等组团签署的白皮书,讨论了AI自动化自身研发可能带来的“智能爆炸”,核心判断是AI系统正在走向自动化大部分AI研发,一旦跨过某个临界点,原本需要数年的进展可能被压缩到几个月;
10月,Google联合创始人Sergey Brin表示,公司已经开始走上RSI的“跑步机”,研究人员正与模型协同开发下一代模型;
Anthropic联合创始人Jack Clark曾在5月时预估,到2027年AI实现无人类介入的RSI的概率约30%,到2028年底约60%;10月,他又改变判断,表示基于AI在数学发现和实验分析上能力的快速提升,他认为“完全RSI可能在2027年发生”。
11月,刚刚离开Google创办Discovery Loop的Jeff Dean,也在与李飞飞的对谈中谈到了RSI:AI虽然能加快实验和研发流程,但模型训练、计算和结果验证仍然需要时间,所谓无限加速的“智能爆炸”并不现实。
所以,大家热议的RSI,究竟是什么?
RSI的终极野心,写在1965年I.J. Good那句被引用了半个多世纪的话里:让机器设计出比自己更强的机器,然后下一代再设计出更强的后继者,直到智能本身进入一种人类无法跟上的加速循环。
RSI全称 Recursive Self-Improvement,即递归式自我改进。简单来说,就是AI通过自主研究获得改进,它的关键在于“递归”——改进后的AI,又能凭借更强的研发能力,推动下一轮自我改进。
就像会总结和优化自己学习方法的学霸,帮助自己下一次学得更快、考得更好。
从技术上看,RSI的运作就像左右脚交替迈进:一只脚负责完成研究任务,另一只脚负责改进研究能力。要让两个循环不断推动彼此,AI背后的运行系统(Agent Runtime)也需要升级:除了任务规划、工具调用和上下文管理,还要具备实验编排、方案比较、独立评估和经验沉淀能力,让每一轮研究的经验都能转化为下一轮改进的起点。
从最初“智能爆炸”的设想,到明确定义为递归式自我改进(RSI),这个关于机器如何不断改进自己的命题,已经存在了半个多世纪。
可为什么到了2026年,它才重新成为AI行业竞相讨论的焦点?
事实上,随着Scaling Law的算力边际效益逐渐递减,AI行业也需要寻找新的效率来源。
与此同时,AI生成和执行任务的能力越来越强,对于什么才是值得研究的、什么才是真正有效的改进的判断,变得越来越重要,这也解释了为什么近两年业内不惜重金争抢顶尖研究员——他们的直觉和判断力,仍然是难以复制的壁垒。
但如果AI能够辅导甚至主导科研过程,情况就可能发生变化。
过去的研究更多是由人类提出假设,再通过实验验证;未来则可能逐渐转向评估驱动:人类建立评价标准,AI自主提出假设、设计实验,再根据评估结果不断调整方案。
这样一来,研究速度本身就可能成为新的核心竞争力。RSI有可能把越来越像资本密集型工业的前沿模型竞赛,从算力Scaling推向研发速度Scaling。
竞争门槛也因此发生变化。对于拥有算力、数据和基座模型的大厂、前沿模型公司来说,RSI意味着有机会进一步提高研究效率,让强者愈强;对于创业公司来说,则意味着不必拥有最多的算力,也可能通过更高效的研究迭代,在细分领域找到突破口,实现弯道超车。
已经有创业公司开始验证这个逻辑:RSI初创公司Mirendil声称,仅用1名研究员、不到1000万美元算力投入和3.5个月,就让AI智能体编写了99%以上的代码,并训练出一个100B-500B参数规模的编程模型。
不过,随着 RSI 成为硅谷最热门的 AI 话题之一,关于它的概念边界,也开始出现争议。
在最近一场斯坦福 HAI 的对谈中,李飞飞向刚刚创办 Discovery Loop 的 Jeff Dean 提出了一个问题:自我改进和递归自我改进,到底有什么区别?
在李飞飞看来,硅谷现在对 RSI 的使用过于随意。毕竟,机器学习系统通过实验不断提高性能,早已不是新鲜事。
Jeff Dean 给出的区分是,普通的自我改进可以让 AI 找到更好的模型架构、提高任务准确率;但递归自我改进还要求,那个负责寻找改进方案的系统本身,也在不断变强。
按照这个标准,今天许多被归入 RSI 的技术探索,可能仍然处于自动化研究的阶段。AI 已经开始参与研发下一代 AI,但它距离能够持续改进自身的研究能力,还有一段路要走。
这次,「非标玩家UnDefined」梳理了全球RSI领域的主要参与者及其研究进展,希望能给国内有类似想法或者能力的创业公司、想要在RSI方面做出投资的机构从业者以借鉴。
全球RSI产业图谱
截至目前,RSI至少有四条技术路线。
- 路线1:工程自动化,目标是让AI承担越来越多的编写代码、调试和训练实验的具体执行工作,让AI成为高效执行者,这是当下AI最容易胜任和能看到实际收益的方向;
- 路线2:Agent自我改进,Agent修改自身代码和运行机制,并根据测试表现筛选有效改动,目标是让AI不仅能完成任务,还能持续提升自己完成任务的能力。这条路线最接近RSI的定义;
- 路线3:自动化AI研究,通过让AI辅导甚至主导科研过程,让研究从假设驱动向评估驱动范式转变;
- 路线4:自动化AI研发基础设施,目标是让AI参与改进算法、芯片、工具和评估系统,让研发过程本身变得更高效。
大厂&前沿模型公司
大厂和前沿模型公司做RSI的共同目标都是让自家的基模更强,同时进一步提高研发体系效率,让强者愈强。
不同的是,大厂们已经拥有十分成熟的AI研发体系,他们在基模、算力、芯片、数据、业务场景、研发团队和云服务等资源上都远胜其它公司。
而前沿模型公司则没有包袱,在组织结构、研发目标和反馈链路上都更灵活,更容易在单位时间内跑通更多“修改-验证”的闭环,这天然贴合RSI高频试错的本质。
OpenAI
核心方向:构建在人类监督下工作的自动化AI研究员,让AI参与下一代AI的研发。
技术路线:自动化AI研究
研究成果1:2026年9月官宣已实现能在人类指导下执行明确研究任务的系统——“自动化研究实习生”;目标是2028年3月前实现让系统能自主交付更大型的研究项目,参与深度学习与对齐研究,实现“AI研究AI”的迭代闭环——“自动化AI研究员”。
研究成果2:2026年9月公开了RSI进展的量化数据,包括Agent总工时在6月首次超越人类;中位数研究员每天消耗的Agent推理费用(按API价格算)已超600美元;研发流程重构,有超过60%的研究员同时运行4个以上Agent会话;人类依然负责设定研究优先级、判断想法价值,以及决定是否部署,战略决策类任务的自动化比例仍不足5%。官方明确表示 “尚不清楚如何安全地一路实现对齐的完整 RSI”。
Anthropic
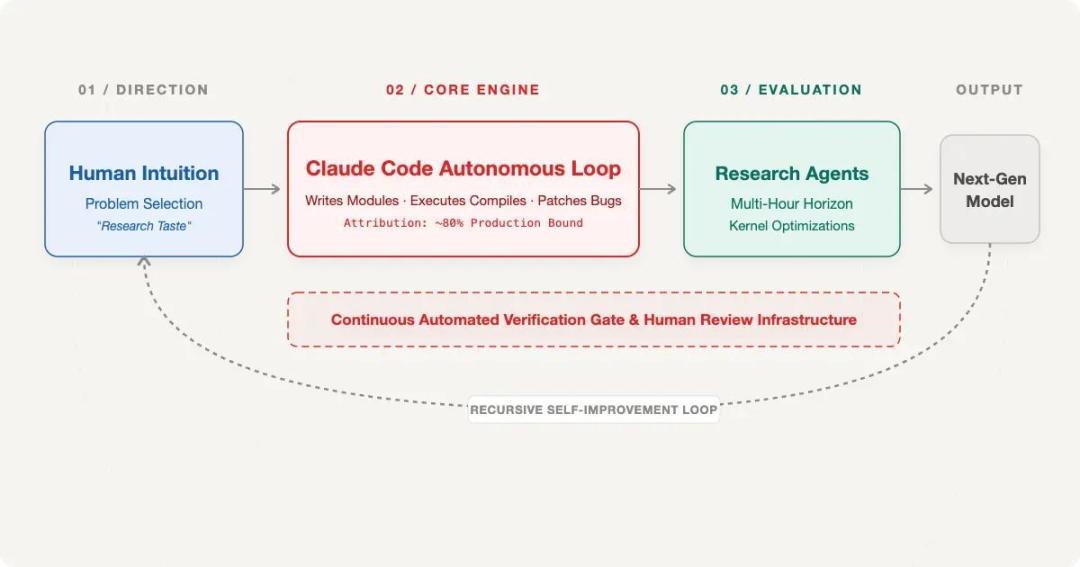
核心方向:让Claude从代码助手逐渐变成AI研发流程中的工程执行者、实验执行者和研究判断参与者。
技术路线:工程自动化、自动化AI研究
研究进展:2026年6月发布《When AI Builds Itself》,梳理了公司内部AI参与自身研发的情况。核心数据包括,截至2026年5月,超过80%并入Anthropic代码库的代码由Claude编写(2025年2月Claude Code内测前这一比例还是个位数);2026年第二季度,工程师日均代码交付量是2024年的8倍;在一个AI安全问题研究中,Claude Agent团队累计运行约800小时,弥补约97%的性能差距,大幅超过同项目的人类研究员团队;在Claude参与研究判断的实验中,下一步研究方案优于人类选择的比例达到64%。11月的文件显示,Claude已经负责编写和审查代码、自动化评估与安全审计,并帮助研究人员构建下一代模型,内部称之为“closing the loop”。Anthropic联合创始人Jack Clark认为完全RSI可能在2027年发生。
Google DeepMind
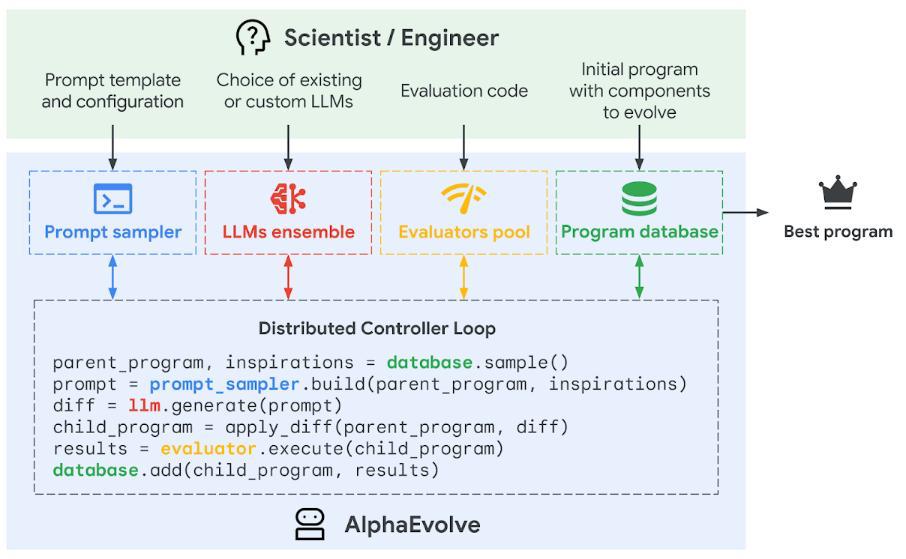
核心方向:让AI自动发现、验证和优化算法,并把成果用于AI基础设施和下一代计算系统。
研究成果1:2025年5月公布AlphaEvolve,主打为模型提出算法候选方案,系统执行、评估,再根据结果继续生成改进方案。公开成果包括优化Google数据中心的调度和计算资源使用;改进Google的部分基础设施算法;帮助数学和科学研究解决计算问题;2026年5月,Google表示AlphaEvolve已用于优化下一代TPU的设计,并发现了一种被整合进芯片的电路设计。不过,AlphaEvolve本质上是Gemini+evolutionary algorithms+automated evaluators,它的自动评估器仍由人类事先明确。
对应技术路线:自动化AI研发基础设施
研究成果2:2026年9月,Google发布Gemini3.8 FlashGoogle。官方称,长时间运行的Agent循环能够递归评估和优化底层模型。姚顺宇进一步透露,Gemini3.8的核心后训练流程由模型自己摸索出来。
对应技术路线:自动化AI研究
研究成果3:2026年9月,Google Research发布论文和开源项目——RRSI:Regularized Recursive Self-Improvement of Agent Harnesses。通过改进Prompt、控制流程、工具、记忆和上下文管理,提升Agent的任务表现,同时减少对特定测试集的过拟合。
对应技术路线:Agent自我改进
Meta
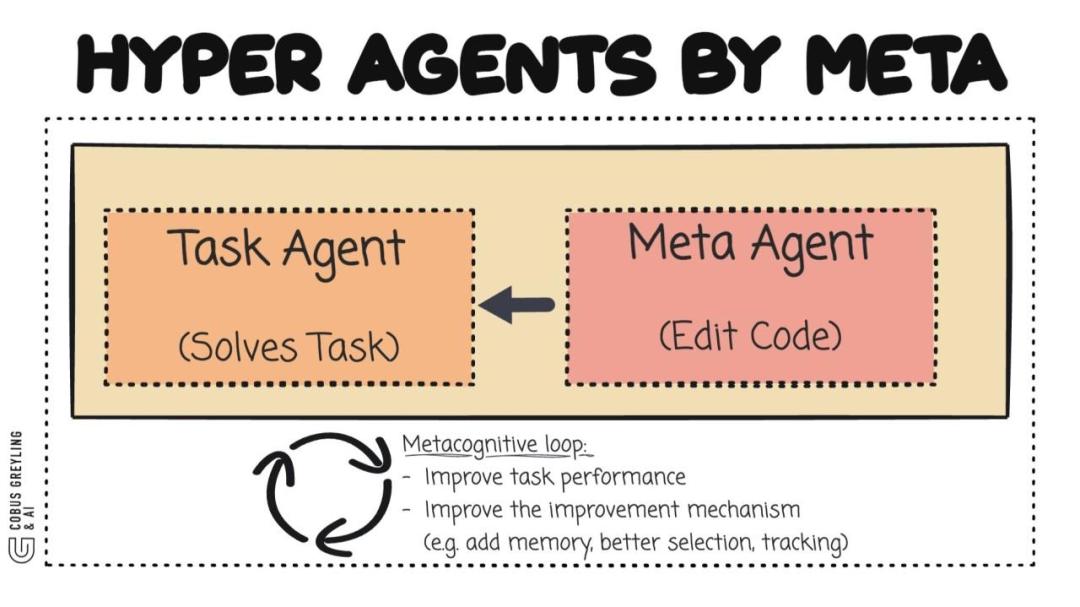
核心方向:让Agent不仅改进解决问题的能力,还能改进产生改进方案的机制。
技术路线:Agent自我改进
研究成果:2026年3月,Meta AI Research发布论文《HyperAgents》。它建立在2025年的Darwin Gödel Machine(DGM,达尔文哥德尔机)研究基础上,把两个角色整合进一个可修改的程序:Task Agent负责完成目标任务,Meta Agent负责修改Task Agent,也修改自身的改进机制。它把RSI从“Agent能不能改进自己”推进到“Agent 能不能改进自己改进自己的方法。Meta 报告称,HyperAgents在多个任务领域实现了持续性能提升,包括编程、论文评审、机器人奖励函数设计、奥数解题评分。
xAI
核心方向:让AI参与下一代AI的研发,逐步减少人类在模型迭代过程中的介入,最终走向自动化的递归式自我改进。
技术路线:工程自动化
研究进展:2026年2月的全员大会上,xAI工程师表示“当前版本的Grok Code正在训练下一代Grok Code”,并称这条路径在“指数级起飞”。马斯克预计可能在2026年底实现完全自动化,最晚不超过2027年。
Microsoft Research
核心方向:暂未公布完整的RSI技术研究。
研究成果:2026年5月,微软与中国高校研究者发布SkillOpt相关研究。思路是通过不断优化Agent使用的技能文本、工作流程和执行策略,提高模型完成任务的能力。它属于Harness/Skill层面的自我改进,该项技术更偏向Agent系统优化。
字节
核心方向:让模型不仅完成任务,还能创建自己的Agent运行框架,并通过自测试、自评价和经验积累持续改进。
技术路线:Agent自我改进
研究进展:2026 年8-9月,字节Seed连续公开了三项直接相关的研究:
HarnessDev:研究LLM能否从一个最小化初始框架出发,自己搭建完整的Agent Harness,再根据下游任务反馈迭代修改。
S³Gym:研究模型能否把自我测试、自我评价转化为真正的自我改进。
Aspire:研究模型能否从模糊目标出发,自主探索并实现自我进化。
阿里
核心方向:让模型从真实任务反馈中发现能力短板,并自主设计实验、构建数据、评价结果,推动模型持续迭代。
技术路线: 自动化AI研究、AI研发基础设施自动化
研究进展1:2026年9月,阿里披露RSI已初步进入模型训练、推理及芯模协同环节。Qwen3.8-Max在人类完全“零参与”的条件下,模型自主承担训练流程搭建、对抗数据构造、实验对照组设计和底层缺陷定位,连续运行超过1个月,跑通33轮有效迭代。通过RSI、后训练等联合优化,Artificial Analysis评分从40分升至45分。在此前未接触过的平头哥新款GPU上,Qwen3.8-Max自主优化Qwen3.8-Flash的推理框架,使单实例推理吞吐量提升96%;在芯片模型协同设计中,Qwen3.8-Max自主运行超过60小时、调用EDA工具超过万次,完成生产级芯片模块的物理实现优化,将模块面积减少42%。
研究进展2:阿里还参与联合研究HarnessRL,聚焦AI能否在训练过程中自主改进“让自己变强的方法”,在4B和9B模型规模上,HarnessRL比最强基线高出2.8到3.1分,达到最佳性能所需的训练步数减少近一半。
腾讯
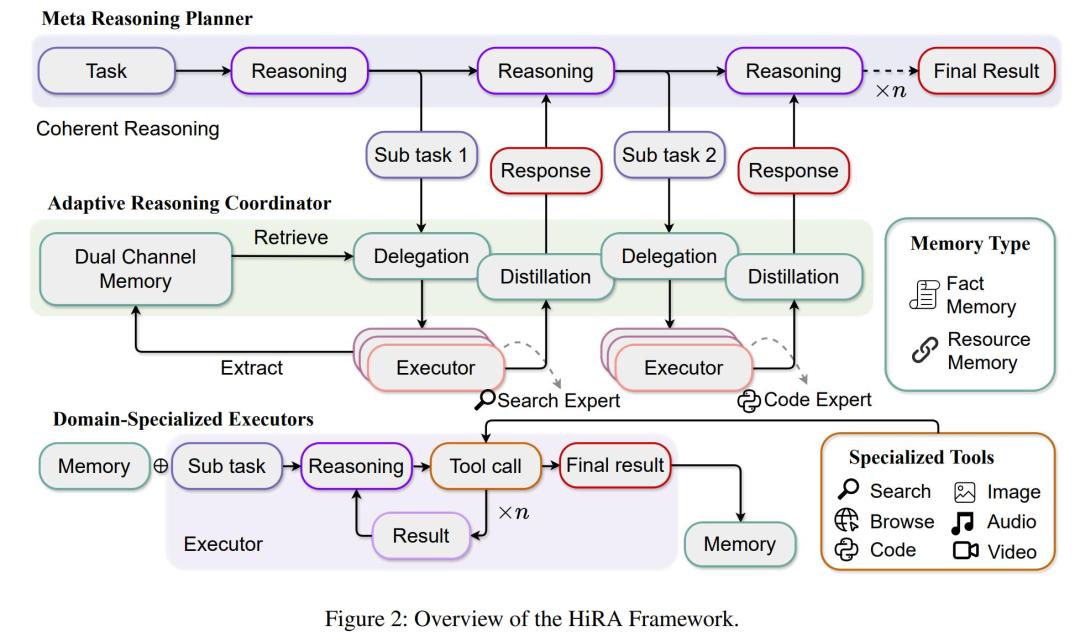
核心方向:以自动化科研和可复用工具研发为切口,让AI参与改进模型研发体系,逐步探索递归自我改进。
技术路线:自动化AI研究路线
研究进展1:2026年10月,腾讯混元Frontier团队与高校合作Terminal-RSI,核心思路是用两个交替的循环训练终端Agent。基于Qwen3.8-27B(你没看错,阿里和腾讯在RSI上间接合作了),在Terminal-Bench2.1上成功率从51.7%升到86.5%,在更严格的Terminal-Bench4.0上从0%拉到19.84%。
研究进展2:2026年11月发布Hyra-2.0,相较1.0版本,定位已经从“用AI解题”升级为“让AI造工具”。Hyra2.0已参与下一代混元模型的预训练基建优化、后训练数据合成、推理系统优化。目前公布的成果包括:科学模型:HyInv、HyPLM-Flash、HyFF;数学研究:HyProver,解决并形式化验证了若干数学猜想;量子计算:HyQ
智谱
核心方向:让模型参与改进自己的推理基础设施,降低推理成本、提高运行效率。
技术路线:工程自动化、AI研发基础设施自动化
研究进展:2026年9月,智谱披露由GLM-5.3驱动的Infra Agent,完成GLM-5.3-Flash推理基础设施的设计、搭建、调试和优化。官方称,它在超过10万张国产芯片组成的集群上,从零搭建生产级推理服务,不到两周将端到端吞吐提升至初始基线的3倍,并将优化后的系统投入实际使用。
MiniMax
核心方向:让模型参与自身开发过程,优化记忆、技能、Agent Harness 和学习流程。
技术路线:Agent自我改进
研究进展:
海外创业公司
如果找到一个巨头还没有形成绝对优势的新位置,用AI改进AI,创业公司也可能成为下一个OpenAI。
Recursive Superintelligence
公司简介:Recursive是当前硅谷在RSI赛道最受关注的创业公司之一。注册成立于2025年底,创始团队包括前You.com 创始人Richard Socher、前Meta FAIR研究总监田渊栋、前DeepMind开放式智能团队负责人、UCL教授Tim Rocktäschel等。26年5月公布A轮融资6.5亿美元,由GV(谷歌风投)和Greycroft领投,英伟达和AMD Ventures跟投,估值46.5亿美元,截至目前团队不到30人。
核心方向:构建一套名为 “Eureka Machine”(尤里卡机器) 的自动化研究系统,让AI接管AI研发中“提想法→写代码→跑实验→分析结果”的循环,最终实现知识发现的自动化。
技术路线:自动化AI研究、Agent自我改进
研究进展:2026年10月,公司发布首款模型Flint,一款总参数量400亿、每个Token激活约25亿参数的MoE编程模型,可在笔记本电脑上运行。公司披露,Eureka Machine参与了Flint几乎整个研发过程,包括模型架构探索、量化训练、训练方案设计和推理系统优化。它能够自主提出改进想法、实现方案、运行实验,并根据结果决定下一步探索方向。
Sakana AI
公司简介:2023年创立于日本,创始人是曾任Google Brain研究员的David Ha和Transformer论文《Attention Is All You Need》作者之一的Llion Jones,董事长Ren Ito曾任日本经济产业省官员。2025年11月,完成约1.35亿美元的B轮融资,投后估值达到约26.5亿美元,投资方包括三菱日联金融集团(MUFG)、大和证券、Khosla Ventures、NEA 等。2026年1至3月又获 Google、花旗、三菱电机等战略投资,累计融资超3.5亿美元。
核心方向:希望从传统人类主导的AI研发,转向由AI自主研究、设计和运行实验的系统。
技术路线:Agent自我改进、自动化AI研究
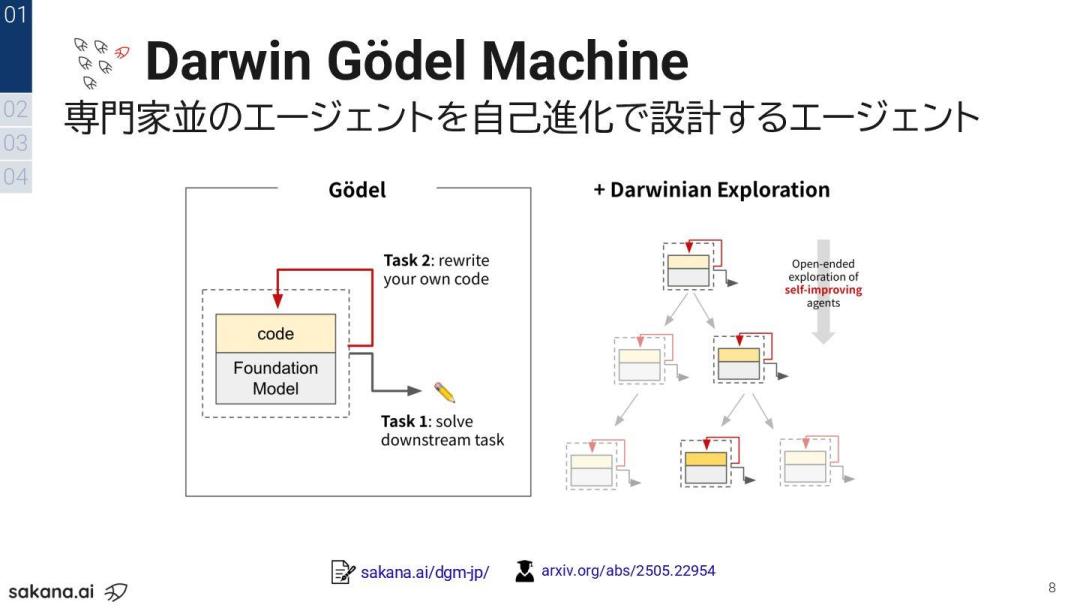
研究进展:核心产出是与UBC Jeff Clune团队在2025年5月公布的Darwin Gödel Machine(DGM),智能体自主改写代码库,SWE-bench表现从20.0%提升到50.0%(但主要局限于编码 Agent,并不是通用模型自主研发)。这是一项比较清楚地展示“AI修改自己,并且改进后的自己继续参与下一轮改进”的公开实验之一。2026年,Sakana AI宣布于东京成立专门的RSI Lab,路线是Evolution + Open-endedness + Multi-agent + Automated Science。Sakana AI的AI Scientist系统实现了从假设到论文的端到端科研自动化,其生成的论文曾通过ICLR 2025 Workshop评审(后按协议撤回)。2026年9月,LSTM之父Schmidhuber加入Sakana AI,担任首席科学顾问,参与指导RSI Lab的研究方向。
Andrej Karpathy:Auto-Research(开源项目)
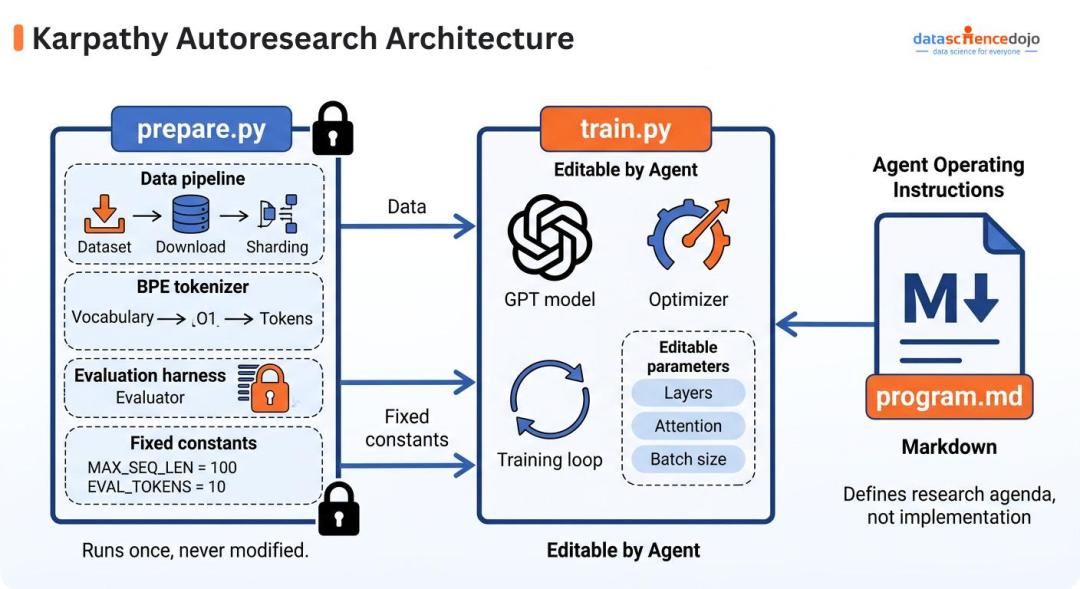
项目简介:前OpenAI联合创始成员、特斯拉前AI负责人Andrej Karpathy开源的实验项目,让Agent自主修改训练代码、跑实验、保留更好的版本;它的价值在于用一个非常容易复现的开源项目,把自动化AI研究循环展示给整个行业。开源后迅速在GitHub上获得大量关注,两天内星标数超过36.9k。
核心方向:构建一个极简的“自主研究闭环”,让AI Agent在人类设定的规则内,自主完成“修改代码—训练模型—评估结果—保留或回滚”的完整实验循环,从而在无人值守的情况下持续优化模型。
技术路线:工程自动化、Agent自我改进
研究进展:AutoResearch开源后,两天内,AI Agent自主完成了276次实验,筛选出29项有效改进,将一个语言模型的训练效率提升了约11%,全程零人类干预。有开发者在H100上运行了83次实验,保留了15次有效改进,验证损失从接近1.000稳步下降到0.975附近。
Discovery Loop
公司简介:前DeepMind和Google Research首席科学家与3位老同事于2026年8月创立的公益性公司。当月宣布完成首轮融资,由Radical Ventures 和 Khosla Ventures联合领投,Alphabet等机构参与。
技术路线:自动化AI研究
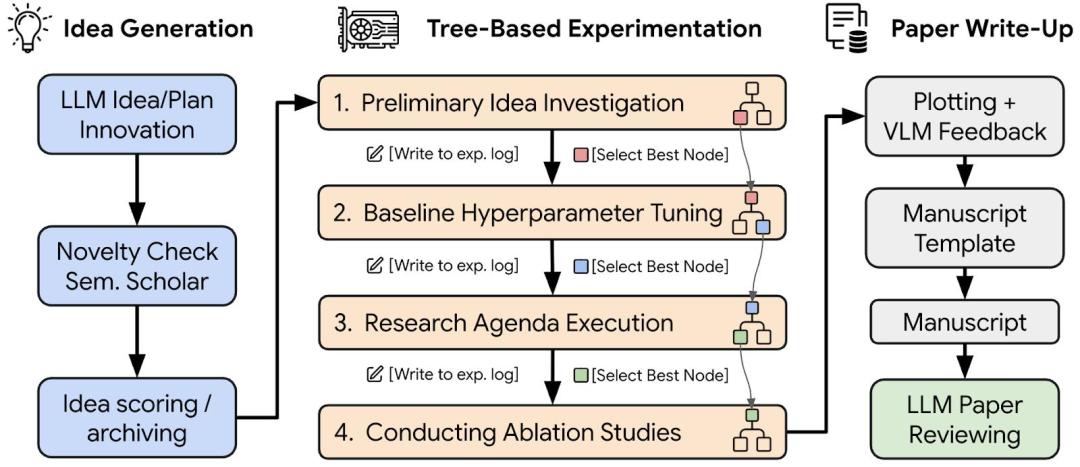
核心方向:强调把科学研究的方法本身自动化,让AI自动完成科学和工程研究中的实验循环:提出假设、设计实验、运行测试、分析结果,再根据结果决定下一轮实验,先从机器学习研究和工程入手,再扩展到医学、材料、能源等领域。
研究进展:尚无公开的产品、模型或技术论文。
最近,在Jeff Dean的演讲里,他透露:Discovery Loop 已经搭建了自己的 Agent Harness,基础设施从一开始就为数万甚至数十万个 Agent 执行任务设计。
目前,公司已有约 20 个自动改进循环在运行,主要聚焦机器学习研究、机器学习工程和硬件设计。
Discovery Loop 的长期生产力目标是20–50 倍提升领域专家的生产力,而非宣称已经实现这一水平。
这让 RSI 相关创业出现了一种非常值得关注的新组织形态:少数领域专家,带着大量 AI Agent 做研究。
Inherent
公司简介:由前Google DeepMind核心团队于2025年创立,2026年5月完成5000万美元种子轮融资,Index Ventures和Radical Ventures领投,NVentures、Metaplanet等机构及Thomas Wolf、Max Jaderberg 等天使投资人参与,投后估值3亿美元。公司目前约12名员工,计划年底扩张至20-25人。
核心方向:构建具备科研品味的AI科学家智能体,让AI学会判断什么实验值得做、如何设计好实验。
技术路线:Agent自我改进、自动化AI研究
研究进展:公司已发布AI智能体Faraday,基于仅270亿参数的Qwen3.6模型进行后训练,在“无提示复现已发表论文结论”任务上表现优于Anthropic Claude Opus 4.8和OpenAI GPT-5.5等前沿大模型。
Core Automation
公司简介:前OpenAI研究副总裁Jerry Tworek和前Google DeepMind工程师Rohan Anil于2026年3月联合创办。截至目前累计融资总额约6.3亿美元,最新一轮估值约35亿美元。
核心方向: 打造“全球自动化程度最高的AI实验室”,用AI来研发AI,让研究流程本身形成自动化闭环。先让Agent接管AI研发中的代码、实验和系统优化,再通过持续学习和自动化研究改进AI本身。
技术路线:自动化AI研究
研究进展: 已公开GPU Kernel自动化、神经网络架构发现、One Layer Deeper竞赛等探索,但尚无公开的模型或产品。
Adaption
公司简介:创立于2025年,创始人Sara Hooker曾任Cohere研究负责人,具有Google 研究背景。2026年2月完成了由 Emergence Capital Partners领投的5000万美元种子轮融资,参投方包括Mozilla Ventures、Fifty Years等机构,以及Jeff Dean、Thomas Wolf等知名天使投资人。
核心方向:Adaption希望构建能够持续学习、实时适应环境且计算成本更低的AI系统。
技术路线:自动化AI研究
研究进展:2026年5月,推出自动化模型训练研究工具AutoScientist,尝试自动化前沿模型的训练流程。其公布的实验结果显示,AutoScientist在测试中将模型胜率从48%提高到64%,优于AI 研究员给出的训练配置建议。
Autoscience
公司简介:2024年成立,CEO Eliot Cowan曾任职于Google Research和Google旗下的“登月工厂” GoogleX(Alphabet's X)。2026年3月完成由General Catalyst领投,Toyota Ventures、Perplexity Fund、S32、MaC Ventures参投的约1400万美元种子轮融资。
核心方向:构建一个全自动的AI研究实验室,用AI系统替代人类研究员来发明、验证和部署新的机器学习模型。Autoscience虚拟实验室由两个核心系统构成:“自动化科学家”负责提出新的算法假设并进行测试;“自动化工程师”负责将验证成功的发明优化并部署到真实环境中。公司早期的商业化落地瞄准了金融、制造业和欺诈检测等高风险场景,让企业无需增加人力编制,就能获得一个完整研究部门的产出。它的研究方式更接近 AI Scientist:提出科学假设→设计实验→运行实验→评估结果→形成下一轮研究。
技术路线:自动化AI研究
研究进展:其产出同行评审论文的AI系统Carl在2025年ICLR Workshop上产出了通过双盲评审的论文,报告了基于早期token表征预测拒绝结果93.1%的准确率,随后出于透明性考虑主动撤回;2026年,其全自动系统在Kaggle Santa2025 竞赛中从3300 多支队伍中夺得银牌,Autoscience称这是全自主AI系统首次在有奖金的正式Kaggle竞赛中获奖;同年,公司推出商业化产品Mira,让Carl产生的想法直接落地到客户的生产模型中,完成从“写论文”到“改模型”的闭环。Autoscience声称,其系统可以并行运行数百个AI研究智能体,同时攻克同一个问题并选取最优解。
Mirendil
公司简介:成立于2026年6月,创始人Behnam Neyshabur是Anthropic前AI科学推理团队联合负责人,6月官宣a16z、Kleiner Perkins领投,英伟达参投的2亿美元种子轮融资,投后估值约10亿美元。
核心方向:构建能够加速AI研发本身的自改进系统。
技术路线:自动化AI研究
研究进展:10月发布Mirendil-Base,验证了“单名研究员 + AI 智能体”即可完成大规模预训练的可行性。该项目从零起步,仅基于 PyTorch、JAX 等开源库开发,数据全部来自GitHub和公开网页,超过99%的代码开发、实验调试和故障排查由AI智能体承担,人类研究员只负责方向决策和关键节点把关。最终产出的编码专用基座模型参数规模在1000亿至5000亿之间,在外部代码仓库的交叉熵测试中仅次于
Ineffable Intelligence
公司简介:成立于2025年,创始人兼CEO曾任Google DeepMind强化学习研究负责人,是AlphaGo、AlphaZero、MuZero和AlphaProof等项目的重要研究者,也是伦敦大学学院(UCL)教授。2026年4月官宣11亿美元种子轮融资,号称欧洲史上最大种子轮,投后估值达到51亿美元。领投方为红杉资本(Sequoia)和Lightspeed Venture Partners,参投方包括Nvidia、Google、DST Global、Index Ventures以及英国政府的主权AI基金(Sovereign AI Fund)和英国商业银行(British Business Bank)。
核心方向:以强化学习和自主学习系统为核心,目标是探索能够持续发现、学习和改进的智能系统。
技术路线:自动化AI研究
研究进展:目前公司尚无公开的研究进展和成果,但已分别与Nvidia合作设计大规模强化学习基础设施,并与Google Cloud达成合作部署搭载Nvidia Vera Rubin NVL72 GPU的A5X大规模集群,以支撑其“超级学习者”对海量经验的计算需求。
Edison Scientific(RSI关联)
公司简介:Edison Scientific是一家从非营利研究机构FutureHouse于2025年拆分出来的商业化公司,联创、CEO Sam Rodriques是一位物理学家和生物工程师,也是FutureHouse的联创、CEO。2025年12月完成由Spark Capital、Triatomic Capital及一家未具名的美国生物科技投资者领投的7000万美元种子轮,参投方包括包括Google首席科学家Jeff Dean、CrowdStrike联创Dmitri Alperovitch等,投后估值2.5亿美元。
核心方向:致力于用AI智能体自动化科研流程。
技术路线:自动化AI研究
研究进展:公司推出的AI科学家智能体Kosmos,能自主阅读文献、编写并执行代码、生成带完整引用的研究报告。其单次运行约12小时,可阅读约1,500篇论文、执行约42,000行代码,完成相当于人类博士生或博士后6个月的工作量;单次成本约200美元,在双盲测试中曾无提示复现人类科学家数月才得出的发现。
Periodic Labs(RSI关联)
公司简介:2025年成立,是一家由前OpenAI 和 DeepMind核心研究员创立的“AI for Science”公司,公司由前OpenAI 研究副总裁Liam Fedus和前Google DeepMind材料科学负责人Ekin Dogus Cubuk联合创立。2025年9月完成3亿美元种子轮融资,投后估值约13亿美元。投资方包括a16z、Felicis、Accel、DST、英伟达 NVentures,以及杰夫·贝索斯、埃里克·施密特等个人。新一轮融资进行中,预计投后估值约75亿美元,已超额认购。
核心方向:致力于构建AI科学家与自动化实验室,以加速物理、化学等领域的材料发现,首要目标是攻克高温超导材料.
技术路线:自动化AI研究
研究进展:公司已开发出基于X 射线衍射(XRD)的自动化表征流程,并用机械臂系统实现样品装载与数据采集,目前每日开展约100次实验,计划开设第二间实验室后将吞吐量提升至每日1000次。
Lila Sciences(RSI关联)
公司简介:2023年成立,由前Flagship Pioneering合伙人Geoffrey von Maltzahn孵化、成立,他此前曾创立 Generate:Biomedicines、Tessera Therapeutics、Indigo Ag等多家生物科技公司。种子轮和A轮累计融资达5.5亿美元,估值超13亿美元;2026年6月被爆洽谈20亿美元B轮融资,投前估值85亿美元,领投方包括加州公务员退休基金(CalPERS)和英伟达NVentures。
核心方向:核心是让AI驱动自动化实验室,自主完成“提出假设—设计实验—物理执行—数据反馈”的完整闭环,目标是将科学发现的速度提升到人类团队无法企及的规模。
技术路线:自动化AI研究、AI4S
研究进展:在mRNA领域测试超95万条序列,优化出长时稳定表达的候选分子并据此设计体内CAR-T疗法;在材料领域从2,942种配方中挖掘出新型钯基催化剂,耐久测试超1,000小时。此外,新型抗体、碳捕获材料等早期成果也以远快于传统研究的速度在内部实验室中实现。
doubleAI(RSI关联)
公司简介:前Mobileye 创始人、CEO Amnon Shashua和前Mobileye CTOShai Shalev-Shwartz等人共同于2023年创办,累计融资约2.21亿美元,估值超10亿美元。
核心方向:Artificial Expert Intelligence(AEI),即让AI在专业领域达到或超过人类顶尖专家水平,并能可靠验证结果。
技术路线:自动化AI研究、Agent自我改进
研究成果:旗下Double Agent主要用于复杂技术问题的自主搜索与设计。在NVIDIA CVDP硬件设计Benchmark上,公司公布芯片单元数量减少82.5%、解决了98.5%的评测硬件设计问题、没有出现通过作弊获取分数的情况。
国内创业公司
超衍智能
公司简介:2026年6月创立,创始人陈勇超是清华大学人工智能学院助理教授,曾在Google DeepMind、Microsoft、MIT-IBM Watson等机构从事研究。9月完成天使轮和天使+轮融资,累计近4亿元人民币,投资方包括IDG资本、星连资本、晶泰科技、深创投、中关村科学城基金等。
核心方向: 从基础模型层构建自进化能力,做下一代自进化基础大模型。
技术路线: 自动化AI研究、Agent自我改进
研究进展:公开报道显示,超衍的自进化系统已经能够从idea出发,自主完成方法设计、代码编写、实验执行和论文撰写。团队还联合清华、MIT、哈佛、CMU、中科大、微软研究院等机构推出ASI-Bench,尝试评估模型在缺少人类方法指导时独立完成科学研究的能力,并开始将这套系统用于AI自身的研究。
超进化智能
公司简介:2026年8月成立,创始陈恺是前上海人工智能实验室大模型中心负责人,还曾任商汤研发总监。10月公布由蓝驰创投领投,商汤国香资本、联想之星、英诺基金、水木清华校友种子基金跟投的数亿元人民币天使轮融资。
核心方向: 自进化研究基础模型。
技术路线:自动化AI研究
研究进展:计划在2027年年中发布采用新范式训练的首个模型。
元环智能(RSI关联)
公司简介:成立于2026年5月,创始人刘子鸣是清华大学人工智能学院助理教授(98年生,MIT博士,KAN模型作者),公司已完成种子轮和种子+轮连续两轮融资,累计数亿元。投资方包括顺为资本(领投)、上海未来产业基金、360 战投、BV 百度风投、山行资本等。
核心方向:公司的核心定位是 “AI for AI”,即用“元模型”来设计AI模型,走的是与主流RSI不同的“预判流”路线。目标是直接生成模型架构和训练超参数,通过学习模型表现规律来预判设计效果,从而减少昂贵的无效试错。
技术路线:自动化AI研究、自动化AI研发基础设施
研究进展:计划在2027年推出通用元模型1.0,不限定场景,为各个垂直领域生成适配的专用模型。短期内优先为工业检测、气象预测、电力预测、金融量化、自动驾驶、世界模型等“按时间连续记录数据”的场景,自动设计专用预测模型,验证商业可行性。
目前,中国物理AI领域也已经出现了一批直接把RSI引入机器人研究的团队和项目。
和大模型领域的RSI不同,物理AI的RSI面对的世界更复杂:机器人不仅要在真实环境中通过行动、失败、反馈和经验积累来改进自身能力,还需要让训练数据、仿真环境乃至研发系统本身不断优化,为下一轮能力提升创造条件。
比如,清华大学智能产业研究院正在研究具身自进化技术体系,让机器人在部署过程中通过持续交互和经验沉淀修正策略;上海科技大学InstAdapt团队等提出EmbodiRSI,通过真实环境、仿真环境之间的循环,让机器人面对新任务和新工作空间时,能够针对自身短板生成训练数据,用更少的真实数据完成适应;东北大学、阿基米德机器人AgiBot、中国科学院大学等研究人员发表的AdaRSI,则进一步让系统判断问题究竟出在执行器能力,还是调用执行器的方式,从而有针对性地改进模型或Agent Harness;香港科技大学(广州)、小米机器人、东南大学等团队提出的EmbodiedSmith,则把RSI引入仿真训练环境,让场景、机器人资产和任务能够相互反馈、迭代优化。
除了论文和实验研究,产业界也开始出现更明确的探索。宇树科技王兴兴公开提出建设物理AI机器人自进化体系,让AI自主检索论文和开源方案、生成机器人控制代码,再通过仿真和真机测试验证效果,结合AI评估与人工判断,推动机器人研发持续迭代;生数科技的Motus2则将行动、预测和评估能力整合进世界模型,让模型预演动作后果,再利用评估和反馈改进后续策略,官方称其呈现出类似RSI的初步特征;原力无限则将RSI列为具身智能的长期技术方向,提出从数据引擎优化、记忆与技能积累到经验策略改进等多个探索方向;初光跃迁提出通过AutoResearch系统,让AI参与机器人物理智能的研发迭代;NEXFORM新元体提出以AI for Physical AI为研发范式,通过AI Agentic开展Auto Research,推动机器人自我进化。
不过,想要实现物理AI的RSI,至少需要让机器人学会从经验中进化、让机器人改进自己的学习系统以及让AI改进制造机器人的研发体系。另一方面,考虑到失败成本的问题,也会比数字世界的RSI更难实现。
小结
从上述不完全统计的产业图谱可以明显看到,中美双方当下在实现RSI的技术路线上各有侧重。
美国侧重科研自动化,大部分公司倾向一步到位的让AI接管AI研究本身,且已经在真实的生产流程中实践。
比如Anthropic已经在让AI承担更多研究执行工作,OpenAI已经上岗“自动化研究实习生”,目标2028年上岗“自动化AI研究员”。
这也是美国把科研写在基因里,追求破解未解之谜,实现0-1创新的必然结果。
中国拥有全球最大、最复杂的应用场景,所以在RSI上侧重工程自动化是更务实和高效之选。一边从工程和系统层寻找可落地的改进机会,让AI先成为更好的研发工程师、Agent和基础设施优化者,一边研究自我改进的技术框架。
比如腾讯的Hyra-2.0、字节的HarnessDev、
截至目前,绝大部分的参与者还停留在从自动化执行向自主研究探索的过程中,距离自我改进的目标,还有一段长路要走。即便老美们都默契的表示那一天将很快到来,但RSI的瓶颈也摆在眼前。
首当其冲的便是模型能力、算力和数据,这些是AI持续探索和试错的资源基础。
以数据为例,AI自我改进需要的数据至少包括帮助模型学习已有知识和方法的训练数据、让AI知道哪些改动有效的实验数据,和帮助模型发现下一轮值得解决的问题的反馈数据。
虽然AI可以生成合成数据,但自产自销自循环,反而容易放大自身偏差,在一条道上走到黑。
更关键的是,AI怎么建立一套相对独立、多层次、能够抵抗被优化对象反向操控的验证体系?在递归的语境下,AI势必要同时修改自己的方案和评分规则,那它也很可能会通过修改规则来获得高分,而不是我们期待它提高的能力。
一项多家机构共同参与的研究正好说明了这个风险:即使引入另一个AI担任评审,如果它无法核验完整、独立的实验过程,仍可能漏掉对评估机制的操纵。在505次经确认的奖励劫持尝试中,AI评审漏检率达到6.5%。
比这个更难的是,AI如何判断什么问题值得研究?
毕竟,开放式研究往往没有现成答案,也很难事先划定完整的探索边界。那些连人类顶级研究者也没法总是给出确定答案的问题,AI靠什么去持续创造?
封面来源电影《盗梦空间》