

 搜索


国产GPU厂商都在尝试制造一台更大的计算机。
10月12日开幕的第26届中国国际工业博览会上,集成电路展首次以独立专业展的形式亮相。在这个被称为“国芯展”的展区,汇集了300余家企业,展示内容涵盖芯片设计、晶圆制造、封装测试以及半导体设备和材料,其中参展的国产GPU厂商不约而同选择了同一个方向:将更多芯片连接起来。
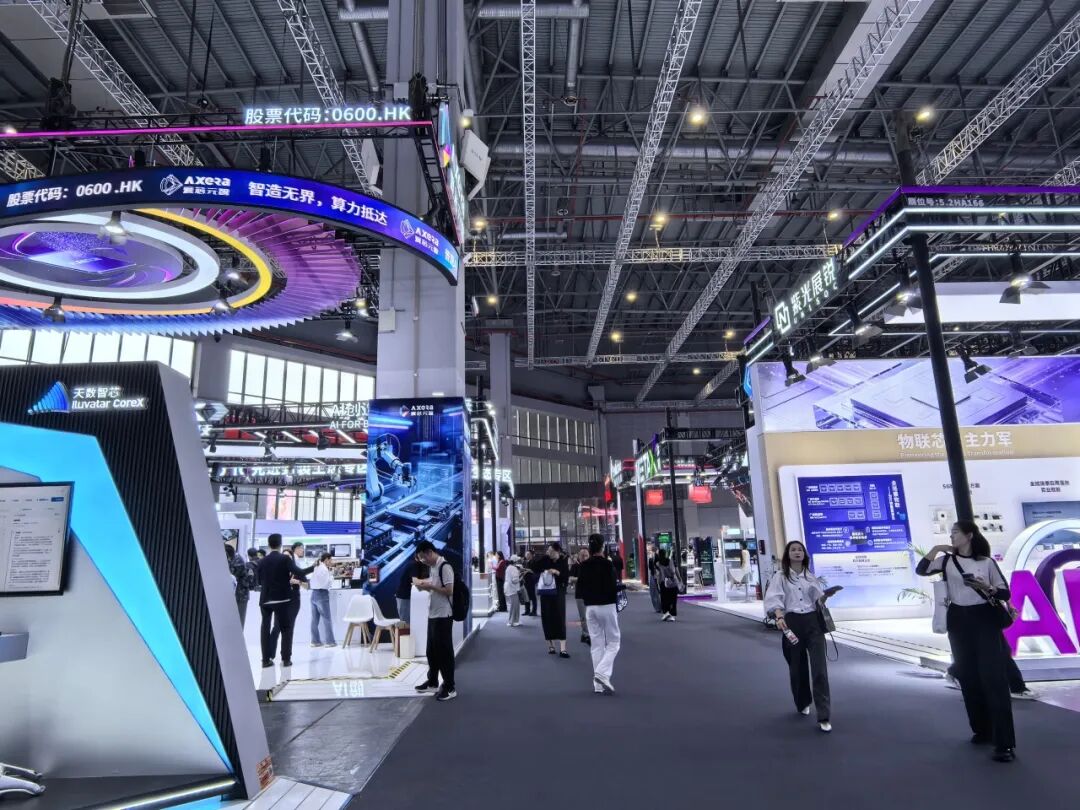
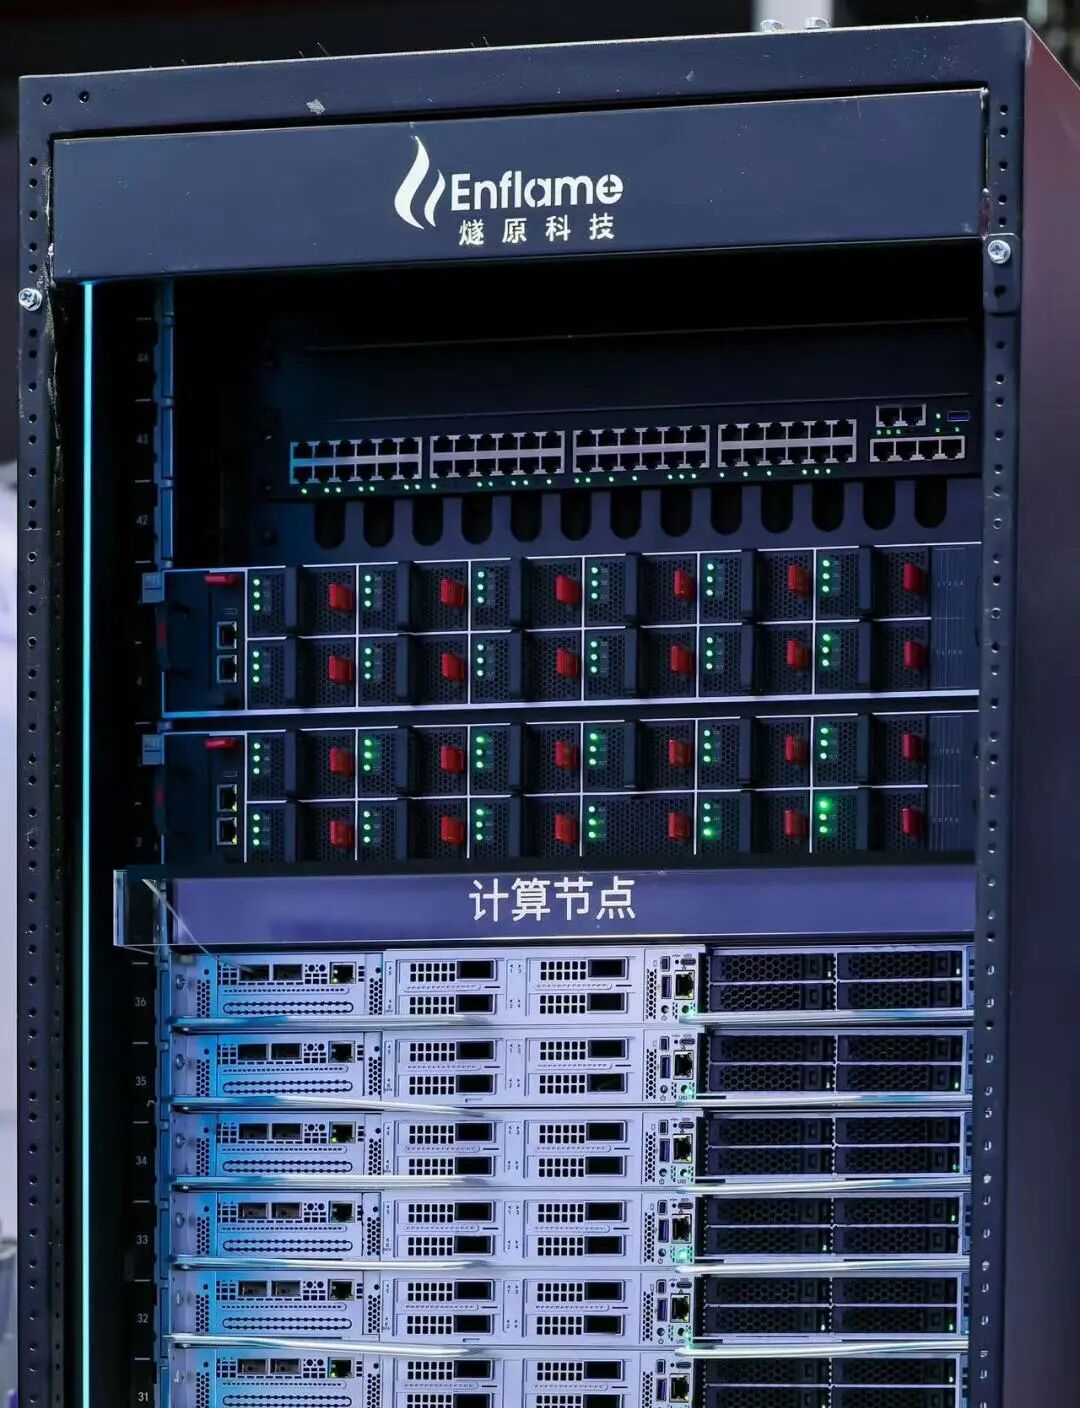
沐曦展示了单柜64卡全互联的曦景S600超节点,燧原展出了云燧ESL64-O超节点,天数智芯则将144颗GPU集成进一台机柜。过去,国产GPU厂商主要比拼单颗芯片的性能,如今厂商们开始讲述一套完整的超节点系统如何运行大模型,以及如何提高计算、效率。
然而,当华为、阿里和越来越多独立GPU厂商进入超节点领域时,新的问题随之而来:超节点究竟应该造多大?谁是这些昂贵投资的买单者?
工博会现场,一位地方智算中心投资人向《IT时报》记者抱怨,几乎每一年,芯片厂商都会推出新一代产品,而一座智算中心从规划、建设到投入运营,往往需要两年甚至更长时间,等设备真正可以对外提供服务时,产品可能已经更新到了下一代,此时客户往往会提出希望使用最新算力芯片。这种投资周期的滞后性,是当下一些市场化“算力工厂”最头疼的问题。
从各家国产GPU厂商公布的节奏来看,随着超节点技术逐渐成熟,今年底到明年,会有一批产品实现商业化落地,但除了性能和价格之外,稳定的供货能力、软硬件生态的完善程度,以及能否为算力中心带来实际业务和客户,都将影响其长期商业化进程。
超节点越造越大
从2025年7月华为在2025世界人工智能大会(WAIC)首次线下展示昇腾384超节点真机开始,到2026年7月举行的新一届WAIC,超节点已经成为各家国产GPU厂商展示的重点,华为甚至在此后的全联接大会上表示,最高可实现百万卡的超节点集群。
三个月之后的工博会上,厂商们再次聚焦超节点。
《IT时报》记者走访多家国产算力芯片厂商展台后发现,尽管都叫超节点,但各家选择的互联规模、整机架构和软件生态并不相同。差异背后,也可以看出厂商对未来大模型发展方向和现实市场需求的不同判断。
最直观的区别是,一个超节点单柜究竟需要多少颗GPU?
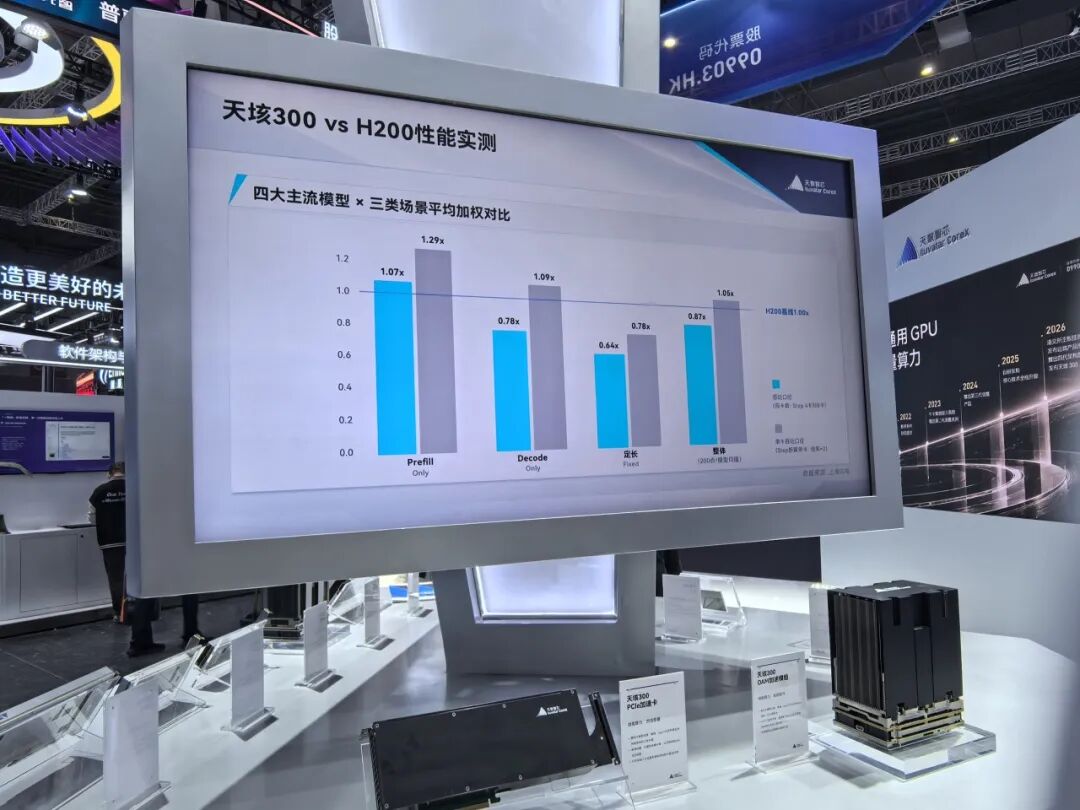
在天数智芯展台,一台44U高度的机柜内集成了144颗GPU和18颗CPU,总显存约10.1TB。据天数智芯介绍,这台天垓300 IXL144单跳通信时延达到100纳秒级,在特定混合专家模型(MoE)的All-to-All通信场景下,有效带宽可提升15%。
此前,单柜128卡已成为国产GPU厂商较有代表性的高密度方案。摩尔线程、壁仞科技、阿里云等厂商均布局了这一规模的产品,中兴通讯的OEX架构也支持单柜最高128卡。
天数智芯为什么要增加16卡?展台工作人员向《IT时报》记者解释,天垓300 IXL144的144颗GPU可以同时参与计算,通过提高单柜算力密度,应对未来超大规模模型对计算资源和显存容量的需求。对客户而言,这不仅意味着单柜算力的增加,也有助于提高机房空间及配套设施的利用效率,在算力资源得到充分利用的情况下,提升系统经济效能。
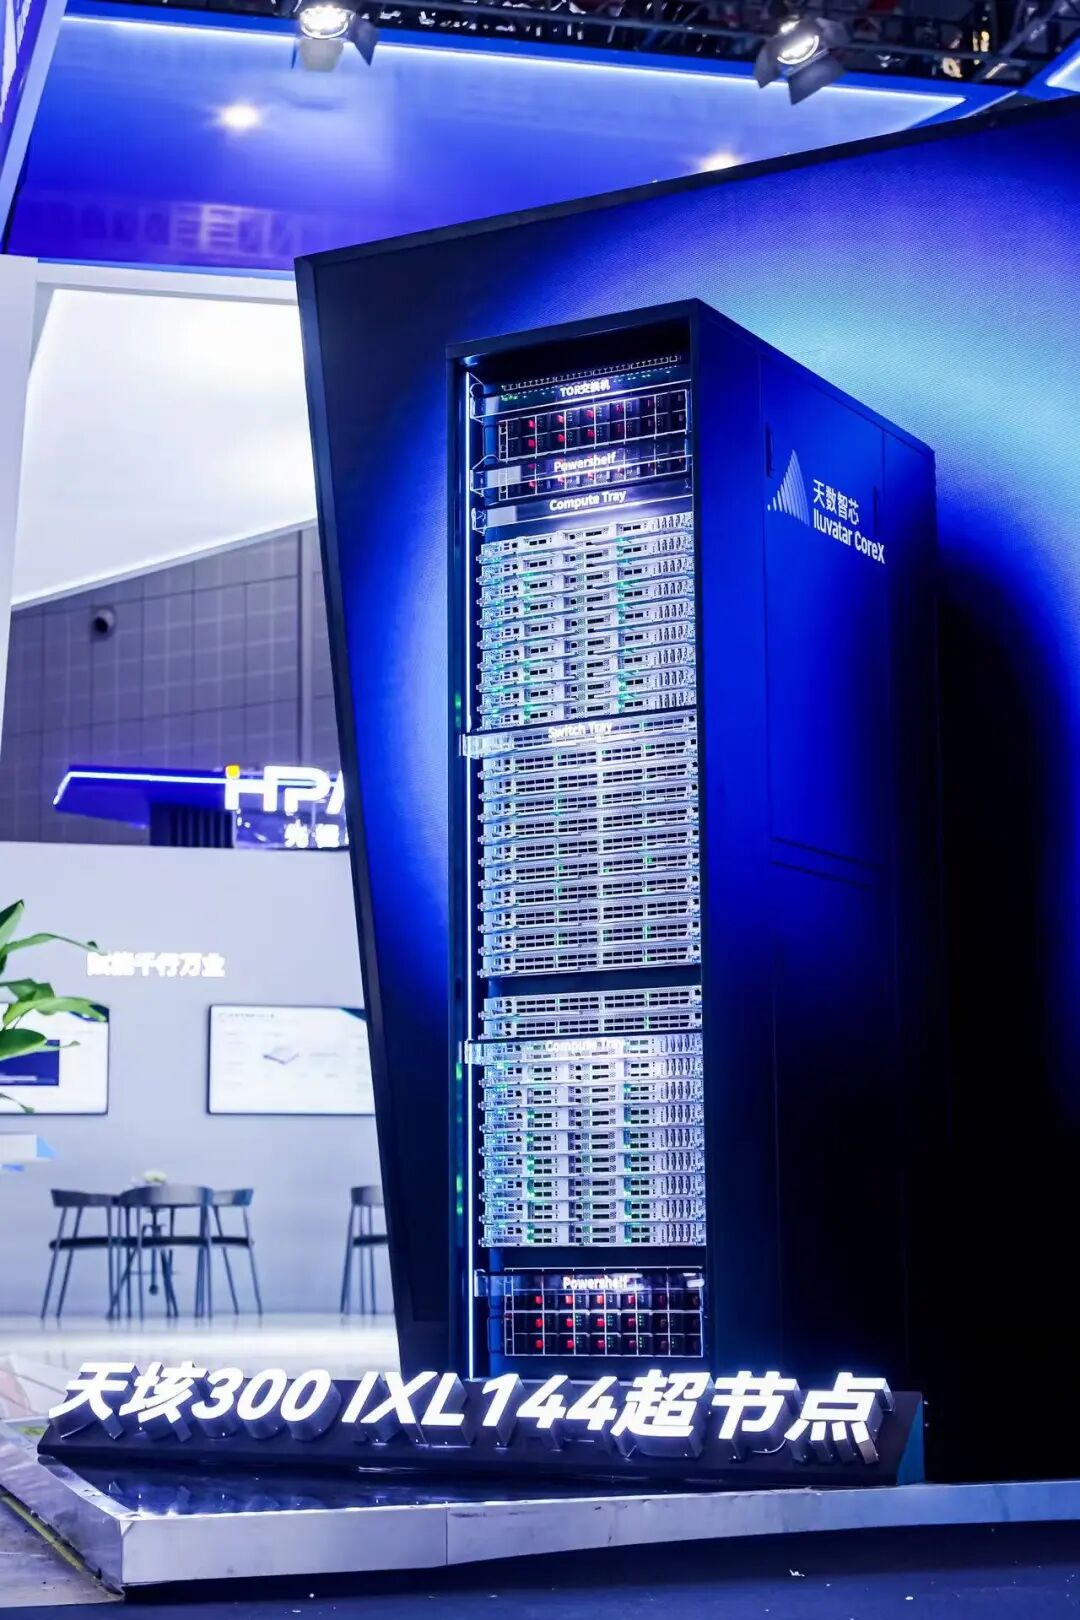
此外,144卡的配置也考虑了大规模模型运行的可靠性。大模型的并行计算通常按照2的幂次划分,64卡、128卡是比较常见的计算规模。但如果128卡全部用于计算任务,一旦某个节点出现故障,就可能影响整个任务的运行。因此,IXL144可以根据任务需求,采用128卡承担主要计算任务、16卡提供冗余资源的配置,在算力利用与运行保障之间灵活安排。
大模型的演进,正在改变算力系统的设计逻辑。今年7月,月之暗面发布的
模型越大,需要解决的问题也越复杂。训练阶段,大量GPU需要频繁交换梯度和中间计算结果;进入推理阶段,即使采用每次只激活部分参数的MoE架构,系统仍需要存储和调度庞大的模型权重。尤其是随着上下文长度增加,KV Cache对显存的占用也会持续增长。
天数智芯选择144卡整柜互联,正是希望为这种需求预留空间。据上述天数智芯展台工作人员介绍,天垓300 IXL144在设计时考虑了未来10万亿参数级模型的运行需求。
当然,这一设计背后也有商业考量。随着
燧原和沐曦重点展出的是64卡方案,采访中,两家工作人员更强调要满足现阶段不同客户的部署需求。
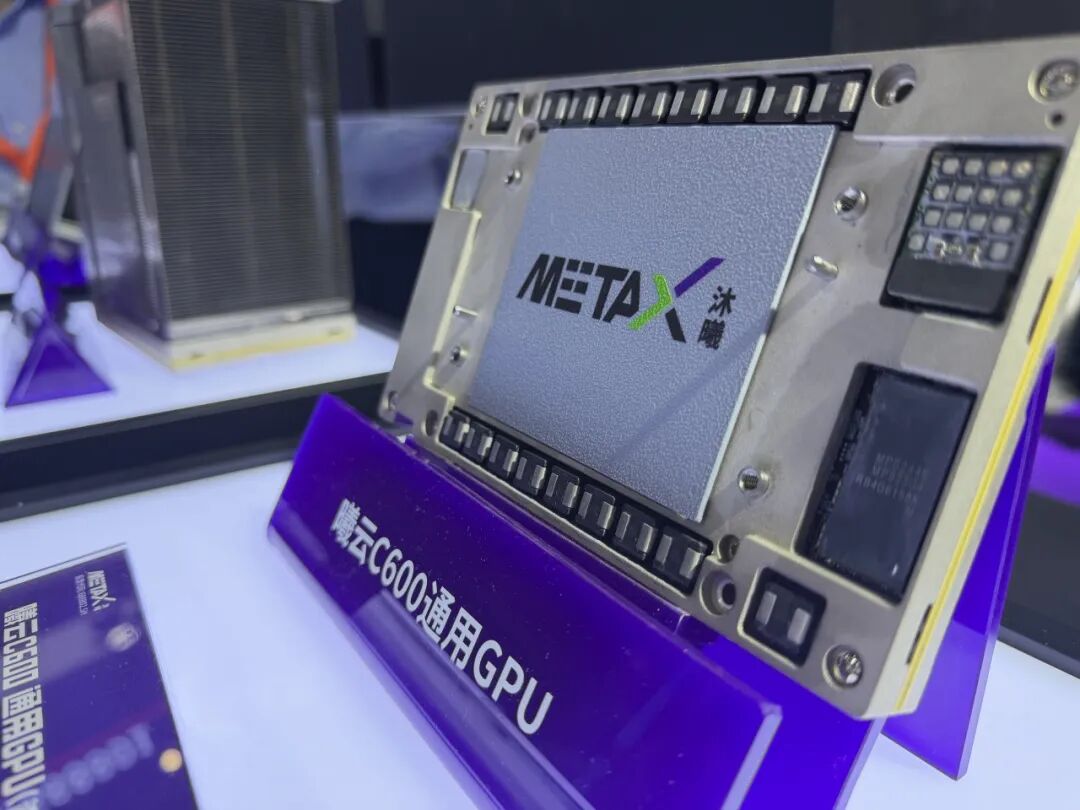
沐曦的曦景S600采用单柜64颗GPU全互联架构,通过正交连接器和交换结构减少传统机柜内部的线缆连接,沐曦联合创始人、CTO杨建此前曾表示,行业主流实用配置以32卡为主,但考虑到未来三四年的需求,64卡是必要的。
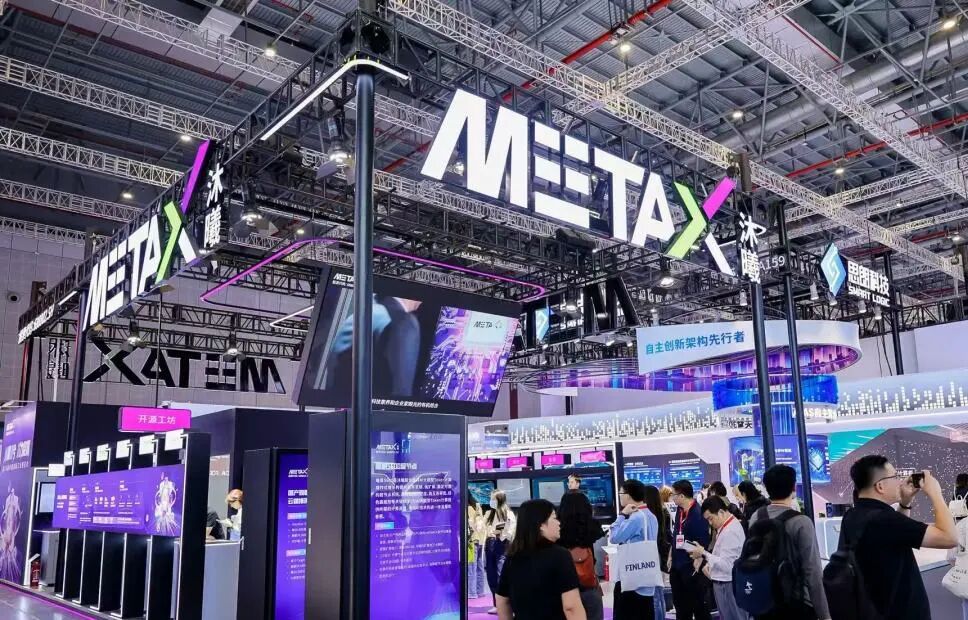
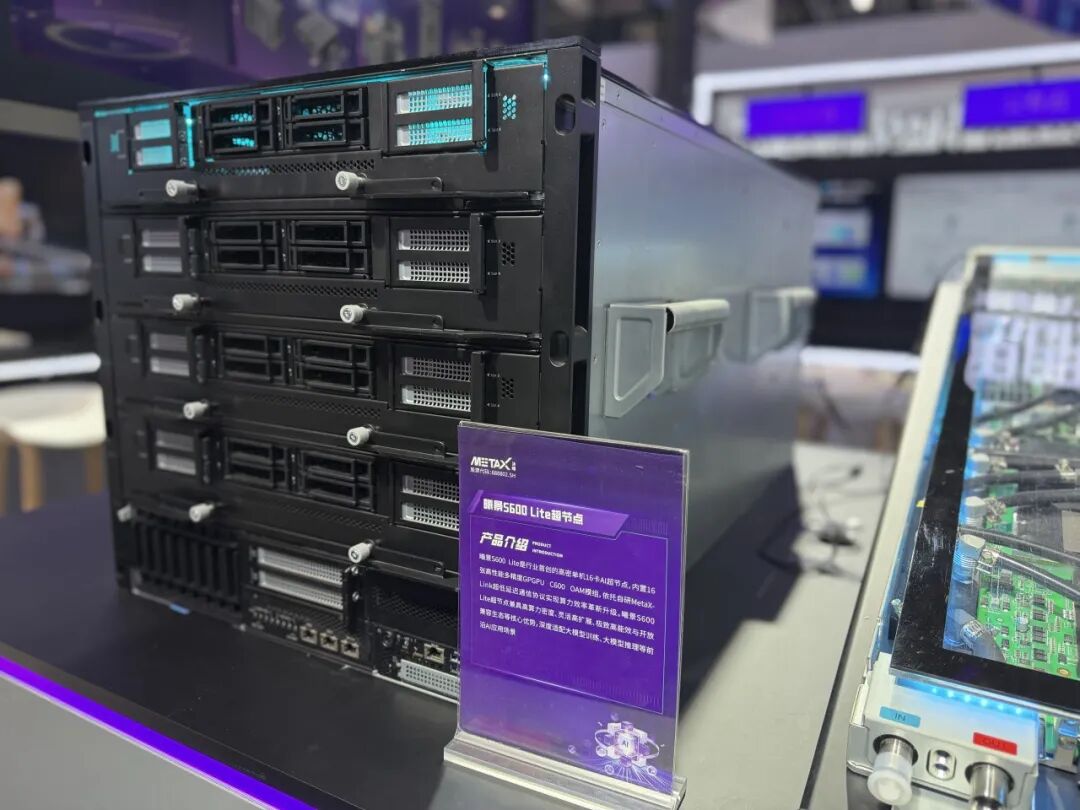
展会现场,沐曦还展出了曦景S600 Lite 16卡超节点方案。沐曦工作人员向《IT时报》记者解释,这款产品是为了满足不同用户相对轻量化的算力需求,16张GPU集成同样采用MetaXLink高速互连和零线缆架构,但体积与传统8卡服务器相差不大,可以作为相对紧凑的整机方案交付,为不需要一次性建设大型算力集群的客户,提供了另一种选择。
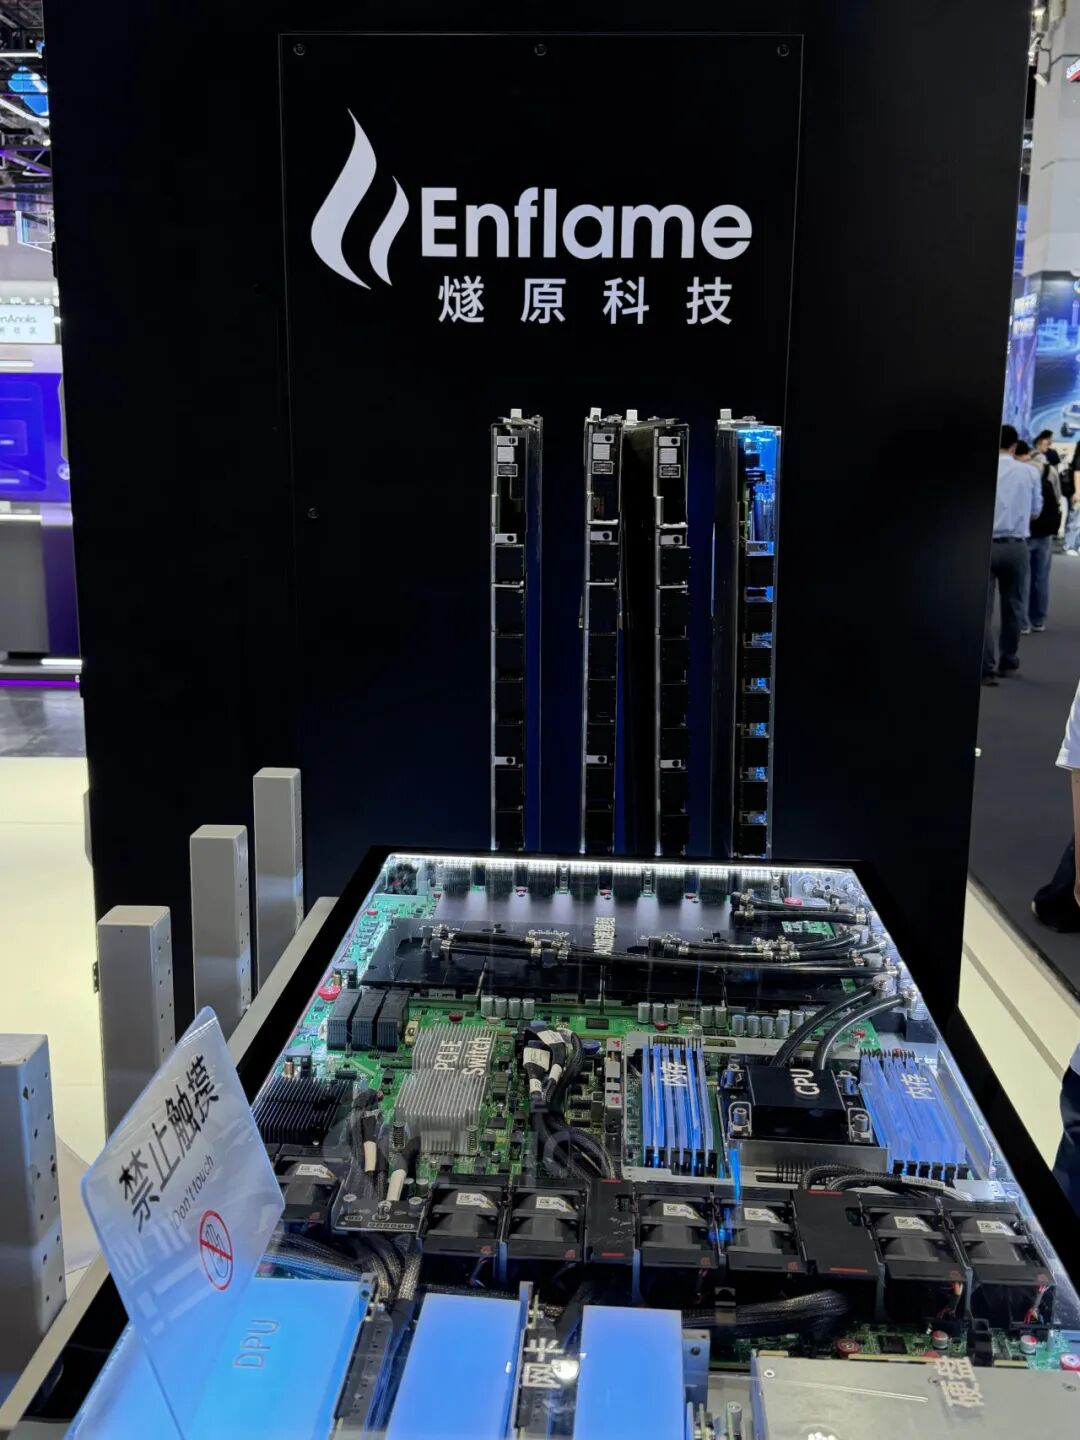
燧原的64卡超节点是与中兴通讯合作的。据展台工作人员介绍,燧原主要提供GPU芯片,中兴通讯承担机柜架构、整机集成与交付等工作。
“我们还是先考虑实际落地的可能。”当《IT时报》记者问及为什么不直接推出128卡超节点时,一位燧原展台工作人员表示,从技术上看,进一步扩大互联规模并非不可实现,但卡数增加意味着更高的整机采购金额,客户是否愿意为此买单,是必须考虑的问题。
这也使超节点面临一个看似矛盾的局面:一方面,随着大模型参数规模和计算需求增长,厂商不断尝试将更多GPU连接起来;另一方面,真正需要如此大规模互联、并能够充分发挥其性能优势的应用场景,目前仍然有限。
为什么要买“你的”超节点?
即使客户确实需要大规模算力,国产GPU厂商还要回答另一个更加现实的问题:为什么要买你的产品?
从目前的市场格局来看,这并不是一个容易回答的问题。
根据10月13日路透社援引的IDC报告,2026年上半年,中国数据中心AI加速芯片出货量达到200.8万颗。其中,英伟达出货67.8万颗,占整体市场的34%;华为出货57.2万颗,占28%。阿里平头哥约占7%,其他国产芯片厂商也在争夺不同类型的算力需求。
值得注意的是,在这一统计口径下,中国GPU出货量为99.1万颗,同比下降26%,而其他类型AI加速芯片的出货量达到101.6万颗,同比增长近80%。
尽管IDC认为,GPU出货量下降的原因是中国大陆可销售的GPU仍然有限,但不可否认,从现有格局来看,国产算力市场正在增长和分化,华为昇腾已经建立起覆盖芯片、服务器、软件框架和开发工具的产品体系;阿里、百度等企业则拥有云计算、大模型和内部业务场景,可以在自身业务中持续验证和优化芯片产品,另一方面,非GPU类AI加速芯片出货量快速增长,说明国产AI算力市场正在形成多种技术路线并存的竞争格局。
面对拥有成熟生态和庞大客户基础的竞争对手,独立GPU厂商也在寻找自己的差异化优势。
天数智芯和沐曦选择的是通用GPU路线,与针对特定计算任务设计的专用AI加速芯片相比,通用GPU通常具有更广泛的并行计算适用范围。一套超节点从采购、部署到完成折旧,往往需要数年时间,但大模型的技术路线可能在此期间发生多次变化,如果底层硬件能够支持更广泛的计算场景,对于客户而言,在计算需求尚不稳定的情况下,是相对稳妥的采购方向。
燧原则选择了另一条道路,专用的AI架构(DSA)并不追求覆盖所有GPU应用场景,而是围绕AI训练、推理进行架构和软件优化,争取在目标业务中实现更好的性能与成本表现。
事实上,对客户而言,采购一套超节点就是在选择未来几年的技术路线。如果一款GPU能够运行某个大模型,却需要客户投入大量工程师重新适配算子和软件框架,那么芯片本身的价格优势可能很快被软件成本抵消。如果一套超节点性能出色,却无法保证后续供货和版本升级,客户同样需要承担风险。
此外,大型客户也可能出于供应链保障、采购议价和降低单一供应商依赖等考虑,引入第二家、第三家算力供应商,但这同时也带来了新的成本:不同架构之间的软件适配、模型迁移和异构集群管理,都可能要付出额外的工程投入成本。
这也催生了一类新公司。《IT时报》记者在工博会上发现了一家运维超节点原生智算系统的公司——基流科技,其开发的Galaxy自主算力系统可以通过多级KV Cache管理、缓存感知路由和智能调度等技术,减少重复计算、降低推理延迟,并提高集群的有效吞吐量。
“比如,一位用户向大模型多次提问时,系统并不需要每次都重新计算此前的全部对话内容,而是可以将任务继续分配给拥有缓存的节点,这样缓存命中率提高了,相应Token成本也降低了。”基流展台的工作人员向记者解释,Galaxy可以支持从万卡集群建设到十万亿参数大模型训推业务的完整流程。
“最终,其实厂商们要回答的都是同一个问题:如何降低客户的总拥有成本(TCO)?”一位展商向记者坦言。
市场在哪里?
然而,并不是所有智算中心,都在做同一门生意。
事实上,今天的智算中心已经不是一种单一的商业模式,按照投资主体、使用对象和运营方式,大致可以分为几类:第一类是互联网大厂和头部模型企业自建的算力中心,主要服务于自身模型训练和推理,对大规模集群的计算效率、软件生态和长期稳定性要求较高;第二类是运营商和云服务商建设的公共算力平台,通过向外部客户提供算力服务获得收入,更关注设备利用率、单位Token成本和客户规模;第三类是大型央国企、科研机构等建设的专用算力中心,主要服务于内部业务,对数据安全、模型适配和业务稳定性有较高要求;第四类是地方政府推动、国资平台或市场化企业参与建设的区域智算中心和算力产业园区,除了算力经营,还承担产业招商、培育本地AI应用生态等任务。
由于投资动辄以“亿”为最小单位,各类投资主体如今都很谨慎。尤其是第四类智算中心,面临的问题往往比采购几台超节点更加复杂,正如文章开头提及的那位地方智算中心投资者,从筹备开始就要考虑能不能收回成本。
“市面上这么多国产算力卡,人家凭什么要买我的这1万张?”一位展商告诉记者,如今地方政府投资的智算园区需要的不仅是芯片和服务器,还希望GPU厂商可以帮助寻找应用场景、引入产业生态,帮助客户找到算力的使用者,甚至参与地方产业资源的整合,让算力投资转化为持续的产业需求,这样园区才能不仅有设备,还有实际消耗算力的应用,能够带动当地产业发展的项目。有时候,厂商甚至要考虑能否围绕当地特色产业,形成一条从算力供给到应用开发、再到商业变现的产业链,“政府一定希望你能让他的投资形成闭环。”该人士表示。
某种意义上,国产超节点的商业化竞争正在发生变化。过去,厂商需要证明自己的GPU能够运行主流大模型;如今,还需要证明由这些GPU组成的超节点系统能够稳定交付、持续生产,并在整个使用周期内创造足以覆盖成本的收入。
不过,至少在今年,国产GPU厂商的销售员们还不是很焦虑。“现在如果一家企业想上一个小规模的超节点集群,估计排期会比较长。”一位国产GPU厂商表示,产能和供应链是目前几家共同面临的挑战,大家首要目标还是进入字节跳动、腾讯、阿里等互联网大厂的采购清单,产能也会优先供给这些大客户,整体依然供不应求。
图片/ IT时报 工博会
