搜索


平头哥算力峰会,我在现场听完两场演讲,一场 CPU,一场网卡。
回来的路上一直在琢磨,这场子为什么留给 CPU 和网卡?回来后又捋了一遍,发现台上两个人绕了一大圈,讲的其实是一件事,GPU 之外的仗。
怎么理解呢?我试试看能否讲得明白。
先说 CPU 那场,主讲人平头哥半导体产品总监黄伟,上台定的调是,agent 时代,CPU 的角色发生了根本变化。为什么?他说你得看活儿变了没有。
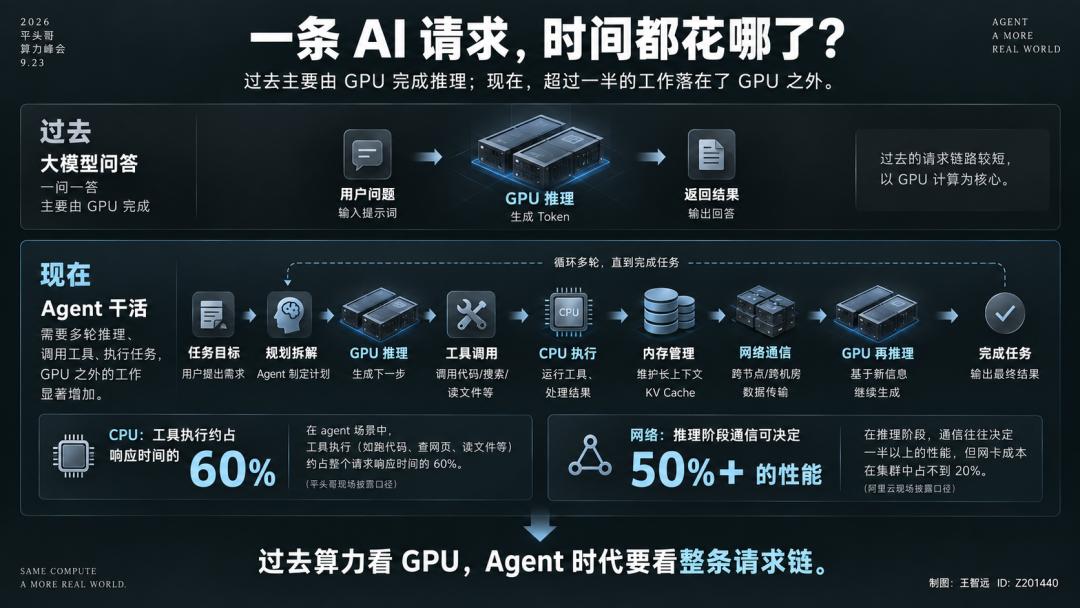
过去大模型推理,是一问一答,这活儿基本是 GPU 在扛。
agent 不一样,它为了完成一个任务,要不停地循环,推理一步,调个工具,看看结果,再推理下一步,直到把事办完。
调工具这一步,不管跑代码、查网页还是读文件,干的都是 CPU 的活。
还有那份必须一直留在手里的长上下文,模型跟你这一单的来龙去脉,每一轮推理都要拿它当原料,主要是 CPU 侧的内存在养着它。
他甩出三个数。
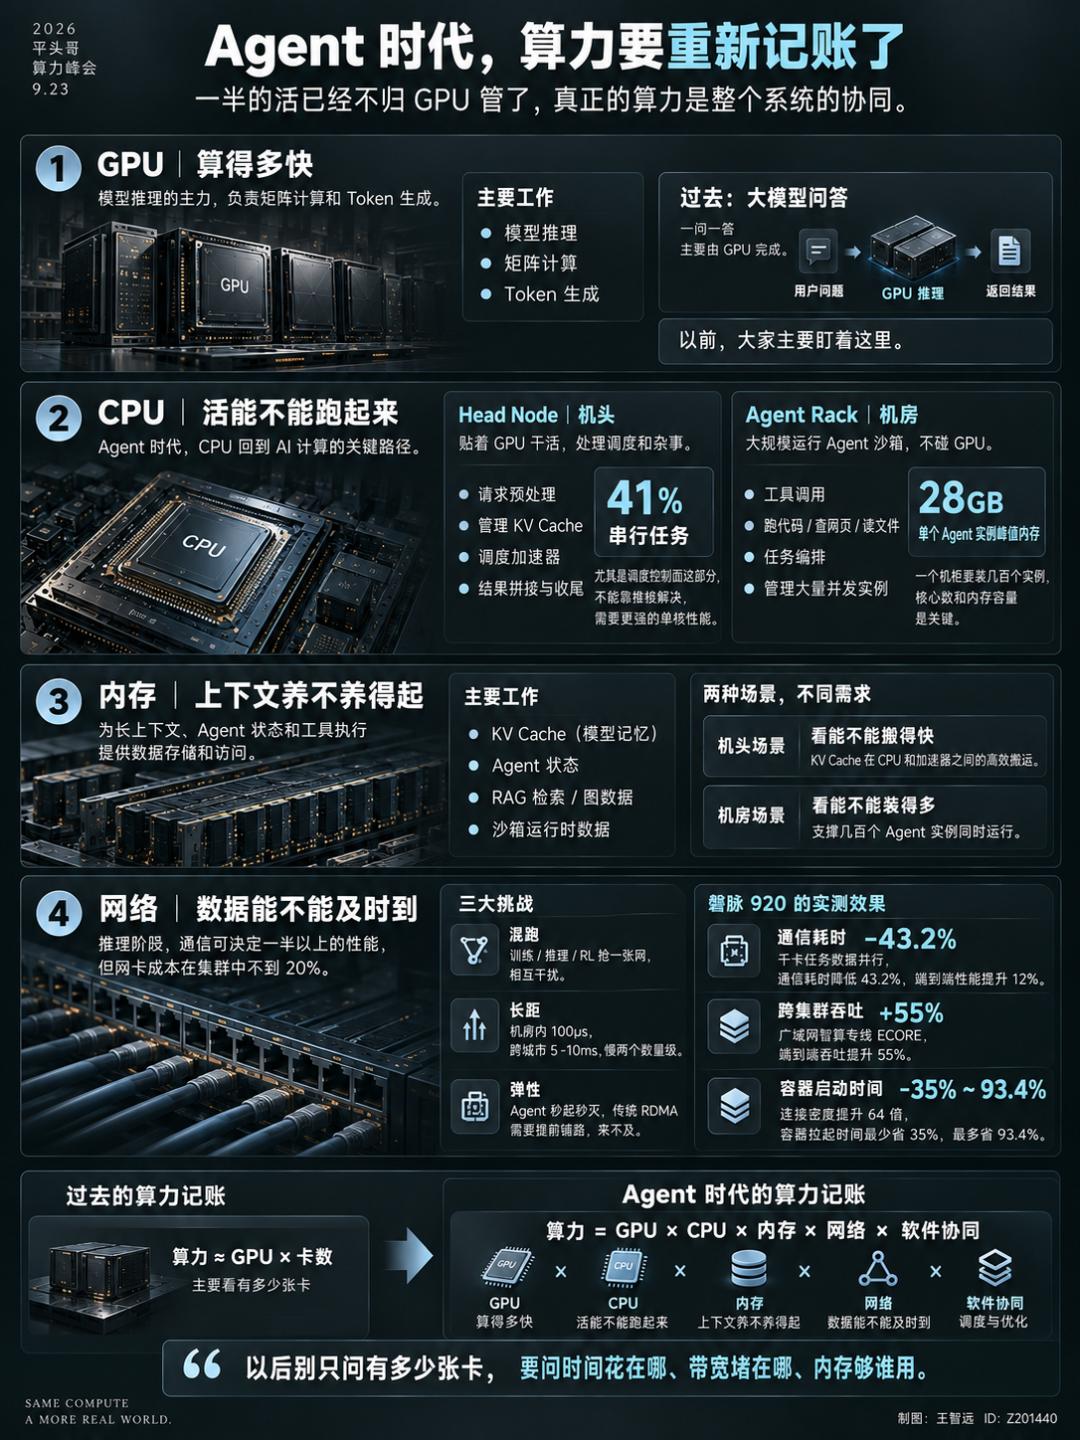
在 agent 场景里,光工具执行一项,就占到整个请求响应时间的六成左右;编码 agent 的场景,容器初始化加工具执行,在 CPU 这边要占 55% 到 60%,总的算下来,CPU 已经扛起了过半的负载。
数据是他现场给的,实验条件没展开,结论倒很干脆,CPU 重新回到了 AI 计算的关键路径。
他把活儿分成两类,这是整场演讲我印象最深的框架。
一类贴着 GPU 干活的,他的叫法是 head node,机头。GPU 出大体力,机头管杂事,像司机带了个副驾,请求进来先归它预处理。
KV cache 归它打理,这是模型顺手记的草稿笔记,记着前面算过的东西,答下一句就不用从头再算一遍,笔记放哪、怎么搬,都是它的事。
什么时候唤起加速器开工,最后结果怎么拼回去,也是它调度和收尾。这活儿卡在关键路径上,机头慢一步,按小时烧钱的 GPU 就空等一步。
所以,给机头改 CPU,处处冲着单核速度。
前端做宽,相当于把进料的单行道拓宽,一个节拍能多吃进几条指令。
乱序窗口放大,好比老师傅炒菜不会等一道出了锅再备下一道的料,窗口大,就能往后看几十步,哪条能先算哪条先算。
KV cache 在 CPU 和加速器之间来回倒腾,地址翻译老是查不到门牌号,每回像翻字典一样一页页找,解法是页表预取,教 CPU 提前把下一页翻好。
还有个隐蔽的,两条本来不相干的操作,被系统误判成占了同一个地址,明明能并行却被排成了一条队,内存重命名就是拆穿这种误判,把路让开。
软件那头,连 Python 解释器派发指令的开销都一条条地抠。
缓存这头,把 KV cache 的元数据在三级缓存和内存之间分层摆放,常用的放近处,别让加速器等一份该在手边的笔记。
另一类是跟推理脱钩的,agent rack,一排 agent 机房。
一个机柜里塞进几百个沙箱,每个沙箱里一个 agent 在干活,调工具、跑代码、规划步骤、编排任务链条、管自己的状态。
这些全不碰 GPU,全在 CPU 上。这活儿不求快,求多,一个机柜尽量多塞 agent,还得让几百个实例别互相抢食。
解法是另一套。
agent 的循环里有大量不规则的跳转,CPU 干活靠预判下一步,传统预判法在 agent 身上老猜错,就引入神经分支预测,让 CPU 靠经验养出直觉。
RAG 检索、图数据遍历这类活,是顺着一根藤要挖出一串薯,数据在哪条依赖链的下一环,CPU 别等用到再找,图预取就是顺着链提前挖。
几百个沙箱共用缓存,等于几百户抢一个储藏室,动态缓存替换按各家的活跃度勤换货,把没人用的腾出去。
MPAM 则是给每个沙箱定水电表配额,核的周期、带宽,各用各的,谁也不能把公区挤瘫。
他给这两类活有句原话,挺形象,机头看内存,看能不能搬得快;机房看内存,看能不能装得多。
全场还有两个数字容易被滑过去,我觉得才是地基。
一个是 41%。他说机头场景下一次迭代任务里,41% 的活没办法靠并行摊掉,尤其调度控制面这部分。
这数字背后是阿姆达尔定律,串行的活加人没用,一锅水烧开了,再多人往灶里添柴也快不了。
整个系统的响应时间,下限就是这 41% 的串行段决定的,想让机器快,只剩一条路,单核本身变快。机头对单核性能的执念,根子在这。
另一个是 28GB。
机房上实测,单个 agent 实例到峰值,要的内存能到这个量级。一个机柜要装几百个实例,内存不堆到天上,门都没有。
这也是为什么这颗 CPU 光有核不够,容量本身就是竞争力。
这些分析不是白做的,第二天云栖主论坛,平头哥首次公布倚天 CPU 路线图,2027 年出倚天 720 和 730,之后是 750,第二代自研核,自研片间互联直连真武 AI 芯片。
黄伟页尾只提了一句路标,其实他就是给那份路标写的说明书。
第二场,网卡。主讲人阿里云智能集团高性能网络研发负责人付斌章,一上来先算账。
他说前面好几场嘉宾都提到,现在到了推理阶段,往往是通信决定一半以上的性能。但网卡本身的成本,在集群里占不到 20%,有的甚至一成。
意思是,整个机房投入产出比最高的一项,是大家不太回头看第二眼的小板子。
他摆了三件麻烦事。
第一件,混跑。集群租出去,租户跑什么你说了不算,训练、推理、强化学习,三种流量挤一张网;训练的流量像高速上匀速的大货车,推理的流量是不断变道的轿车,货车一被打断,整个车队跟着降速。
第二件,长距。
现在的推理流行 PD 分离。一道题拆成两段干,读懂题、打好草稿算一段,把答案一个字一个字往外蹦算一段,两段分别用不同的 GPU 跑,省卡。
麻烦在两段一旦不摆同一批机柜,数据就得跑出机房,上广域网。机房里跑一个来回一百微秒,跨了城市是 5 到 10 毫秒,慢两个数量级。
网络传数据本质像车队行军,先派探路车报路况,大部队才敢加速。探路回报慢一百倍,大部队只能降速,有效带宽掉下悬崖。
第三件,弹性。
agent 的活儿说来就来,容器秒拉起,干完就销毁。可 RDMA 这种快车道(机器绕开 CPU 直接互读内存的高速通信方式),要提前把整条通路的资源、地址都铺排好才肯干活,像包专线货运,发车前先排时刻表。
只活几十秒的容器等不起,所以,很多人最后退回 TCP 这种随叫随到的通用方案,性能损失自己咽。
对付这三件麻烦,他先铺开一张地图,这块信息密,记一句就行,分场景修路。
训练走 HPN(高性能网络),一代比一代吃得下更多接入。上一代靠 51.2T 的交换芯片撑 7.0 版本,主力 8.0 用 102.4T,在研的 9.0 上 200T,T 是万亿比特,芯片吞吐的单位。
卖点是两层网络就挂几十万个 800G 的接入端口,相当于立交桥只修两层,却上得下几万台车。
推理走新架构 TPN(按 token 性能设计的网络),干的事一句话,把两张从没打通的网连成一张。
机房里本来两张网,机头网络跑业务进出,机尾网络连 GPU 之间的高速数据,互不相通。
没配机尾的小卡做 PD 分离,只能挤机头那条道,机尾空着;TPN 在两道墙中间开了门,同一个集群里各组机器(行话叫 pod)能互相喂数据,分离的两端不出机房就能对上话,长距传输直接省掉。
真要跨集群,流量走骨干网里的智算专线,阿里给它起名叫
超节点内部的互联另有一张,叫 UPN(超节点网络),光互联,机器物理上不用绑死,一层铺得下千卡。
然后,是主角,磐脉920。他报的规格是 400G 的带宽,一秒能过 4000 亿比特的数据,面向智算和存储两个场景。
他讲得最起劲的倒是另一个设计。
这张网卡里内置了一个交换机,等于自带一块分电板。各家 CPU 对 PCIe 这条数据通道的脾气不一样,没有这块板子,换个计算平台就可能踩一次坑。
有了它,同一张卡插到不同平台上,都能稳定输出 GPU 直接读写网卡、不绕 CPU 的那套性能。
协议它跑两套,业界标准的 RoCEv2,加上阿里自研的 SolarRDMA。
自研这套最早在存储场景里磨,后来才用到智算,他的原话是把存储和计算的坑都趟完了;最值钱的功能是按连接逐条自动选路,新卡碰新卡,自动走自研的快道;碰上老卡,退回标准协议。
老集群不用拆了重建,一张一张换就行,业务不停。他说这种无感的增量部署,工程上价值非常大。
四张成绩单,口径都是现场给的实测。
第一张之前,他先拆了一个流传很广的误区。他说两年以前,你要说预训练用不上好协议,没毛病。大模型训练就是单一大任务,环形算法轮着传,每张网卡只跟自己的邻居说话,带宽就是一切。
今天这话过期了,现在是训推一体的集群,推理的流量随时闯进来,预训练被搅得跟着降速。
千卡任务实测,把大传输拆成小包、多条路同时飞,哪条拥塞或者哪台硬件坏了就自己绕行,数据并行的通信耗时降 43.2%,端到端性能提 12%。
第二张,跨集群长距。
端侧给流量打标,广域交换机照着标挑更优的路,丢包只补丢的那几张,不用整摞重发。端到端吞吐提 55%。
第三张,弹性。
新的虚拟化技术把资源分配挪到软件控制路径,连接密度是传统网卡虚拟化的 64 倍,容器拉起时间最少省 35%,最多省 93.4%。
他撂了句狠话,这个弹性不拿性能换,套了虚拟化跑通信,速度和硬件直通几乎一样;按他的说法,专线的速度和网约车的灵活,目前只有这张卡能同时给齐。
第四张,小包。高性能计算传的数据正文很小,包裹没封箱带厚。这张卡走「以太网+」协议,削前导码、绕开链路层开销,正儿八经的内容能占到 85.4%,他说业界最高。
落地的交代很短,磐脉920 已经跟着灵骏真武 M890 超节点上线,超节点配的就是这张卡。
两场演讲,单听各管一摊,放一起看,挺有意思。
黄伟说,agent 场景里 CPU 扛起了过半的负载。付斌章说,推理阶段过半的性能由通信决定。两个过半,口径不一样,一个量时间,一个量性能。
但指向是同一个。请求进来之后,GPU 算完的那一段,在整条路上越来越不稀罕了,剩下的大头,落在 CPU、内存、网络上。
模型有多聪明,比 GPU,agent 把活干得多利索,比这些地基。
黄伟下台前收尾,希望倚天为 Agentic AI 时代的普惠算力,贡献一份计算底座。付斌章没说场面话,他只留了个落地,就是前面那句超节点上线。
倒是串场的主持人,给了句不错的总结。
人工智能的竞技场,已经从参数规模角逐,转向工程落地的深水区,单点的突破,撑不起智能体时代的系统级负载。
台上两个人讲了四十分钟,都在给这句话当证词。
我这趟带回来的,其实是个记账方式的变更,过去聊算力,问你有几张卡?往后可能得问,一个请求进来,你的时间花哪了,带宽堵哪了,内存够谁用。
卡多不等于活好,这个账,行业刚开始认真算。
注释:
[1].本文内容来自我 2026 年 9 月 23 日在平头哥算力峰会分论坛的现场记录,演讲实测数字均为现场披露口径