
 搜索

随着智能体AI(Agentic AI )成为产业共识,数据中心的计算范式正在经历根本性重构。当前绝大多数AI芯片,本质仍是为大模型推理/训练设计,服务“被动问答”;而Agent智能体是自主规划、多步推理、工具调用、循环决策,会出现大量反复思考—调用—回读—再生成的行为。面向Agent原生的芯片,目标是成为自主迭代思考+记忆管理的系统加速器。它要能够解决多步闭环推理、记忆读写、多子任务切换带来的时延与能耗瓶颈,推动整个软硬件栈从“被动问答大模型”向“自主 Agent 系统”的范式迁移。
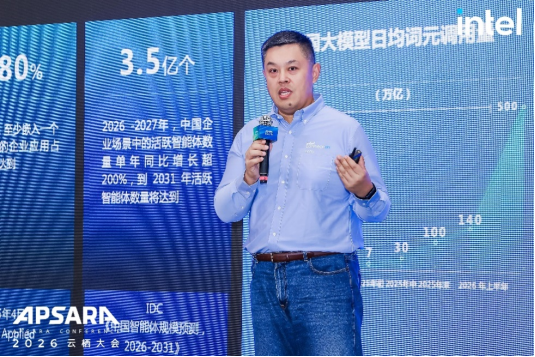
在近日召开的2026 云栖大会英特尔专场“智启 Agent・算筑中枢”上,英特尔首次完整披露了其下一代至强处理器Diamond Rapids的架构细节与技术路线图。Diamond Rapids也是英特尔首款面向AI智能体(Agentic AI)原生设计的服务器CPU,实现了从“适配大模型”到“原生支撑智能体”的转型。
Agent浪潮倒逼算力重构
传统AI的单轮推理模式下,计算高度集中在模型生成环节,GPU承担核心算力,CPU仅负责前后端数据预处理与交付,行业普遍形成“1颗CPU搭配4颗GPU”的算力配比。但进入智能体时代,整个计算链路变成了“思考-规划调度-工具执行-反馈校验”的多轮模式,处理器需要执行大量规划编排、工具调用、状态管理、安全治理等非模型计算环节,这些都高度依赖CPU算力。
有数据显示,到2030 年,数据中心80% 的工作负载将与AI相关,其中推理占比将达到37%;CPU与GPU 的算力配比正从传统的1:4 1:1快速演进。CPU的重要性在智能体时代正在不断提升。但现实是当前市面上的主流 CPU,均不是为智能体场景原生设计的。
对此,阿里云智能集团资源总监、首席服务器架构师卓久在活动现场表示:“现在大家说的‘Agentic CPU’并不准确,它们只是在某些环节有优势,本质上还是面向传统工作负载设计的架构。”
Diamond Rapids的原生创新
英特尔技术专家龚海峰表示:“智能体时代评判一颗CPU,不再是数多少核心、跑多高频率,而是看它能承载多少个智能体、每个智能体能多快完成任务。”围绕这一评价标准,Diamond Rapids从架构、指令集、缓存、带宽、硬件加速等多个维度实现了突破。
在传统多核架构中,不同核心访问内存与I/O的路径差异极大,多智能体并发运行时极易出现资源热点,导致时延恶化。英特尔在Diamond Rapids上采用Fan-out Fabric全新架构,整个芯片以2个Fabric Hub芯片为中心,周围分布多个计算模块(CBB),采用全连接拓扑设计,所有核心都能通过均衡路径访问内存与I/O资源,从物理层面消除了跨核心、跨Die的访问差,大幅降低了软件NUMA调优的复杂度,保障多智能体高并发场景下的时延稳定性。
在指令集方面,针对智能体工作流中大量的数据搬移、状态切换场景,Diamond Rapids 引入了全新的APX标量指令集。其核心升级有两点:一是通用寄存器从16个翻倍至32个,让更多数据可以保留在寄存器中,减少内存与寄存器之间的频繁搬运;二是新增New Data Destination(NDD)寻址模式,允许指令结果写入独立目标寄存器,避免覆盖原始数据。对于充斥着大量状态切换、上下文处理的智能体工作流而言,这意味着单任务的指令开销大幅降低,直接提升端到端执行效率。
在缓存方面,Diamond Rapids将三级缓存容量提升至1.28GB。对于智能体场景而言,更大的缓存意味着可以承载更多的上下文数据与 KV Cache 热数据,大幅减少对内存的频繁访问,既降低了时延,也缓解了内存带宽压力。
内存容量与带宽是制约智能体部署密度的核心瓶颈。按照行业通用测算,单智能体运行通常需要 2GB 内存,高密度部署下对内存容量与通道数的需求极为严苛。Diamond Rapids配备16 个内存通道,内存带宽达到1.6TB/s,支持最高12800MT/s的MRDIMM,大幅提升了内存容量上限与数据吞吐能力。这一设计让 CPU 既能支撑更高密度的智能体沙箱部署,也能更好地承担GPU溢出的算力负载。
智能体全链路中,数据预处理、KV Cache 压缩解压缩、内存搬移、沙箱加载等通用任务,会占用大量CPU核心算力。Diamond Rapids保留并全面升级了AMX、QAT、IAA、DSA四大内置硬件加速器,将这些通用任务从CPU核心卸载到专用硬件。
“加速器的价值,不只是快,更是让 CPU 核心算力聚焦在真正的智能体编排与执行上。” 英特尔技术专家胡勇表示,“通过硬件卸载,我们能在同样的硬件配置下,承载更多智能体,同时降低整体 TCO。”
AI算力竞赛进入深水区
Diamond Rapids的亮相表明,AI算力的竞赛已经从“训练算力规模比拼”,进入了“推理与执行效率比拼”的深水区。智能体作为下一阶段 AI 落地的核心载体,正在重新定义数据中心的算力格局。
此外,英特尔与阿里云还在本次论坛上,就许多其他热点话题进行了分享。针对智能体推理中普遍存在的 MoE 负载不均、KV Cache 膨胀两大行业痛点,英特尔提出了 CPU+GPU 异构协同的落地方案。对于 MoE 模型专家冷热不均导致的单卡过载问题,方案利用 CPU 大容量内存与 AMX 算力优势,承接 GPU 溢出的热点专家,无需中断推理即可实现算力弹性补充,避开了跨卡权重迁移的性能损耗。针对 KV Cache 体积大、小块数据搬移效率低的问题,通过 DSA 硬件加速器加速缓存数据搬移,全程不占用 CPU 与 GPU 核心算力;结合 QAT 硬件压缩可实现 20%-30% 的缓存体积缩减,且不会造成首 Token 时延损失。
存储层面,阿里云基于英特尔至强 6 平台打造的磐久存储九代服务器,通过管控链、数据链、压缩链三层软硬协同优化,整体吞吐达到上一代平台的 4 倍。其中 QAT 硬件压缩将压缩带宽提升 400%,同时释放 75% 的 CPU 核心算力;DDIO、DSA 技术深度卸载数据搬移与校验负载,单线程处理能力提升 40% 以上。英特尔也同步推出了标准 2U JBOF 与小型化 IPU 两种存储形态,结合 KV Shrink 分层方案,支持 KV Cache 向存储层下沉,RDMA 单跳访问仅比本地盘增加约 10 微秒时延。
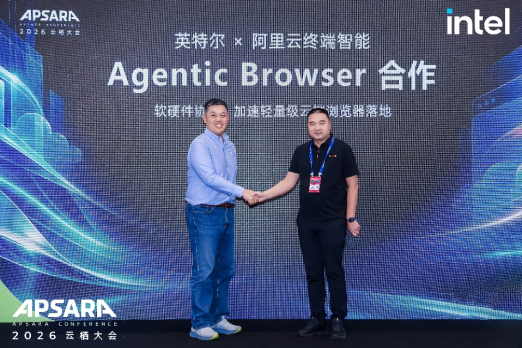
阿里云与英特尔联合发布的 Agentic Browser 方案,首次系统回应了 “智能体如何高效上网” 的新命题。针对智能体作为新型互联网访问主体的需求,方案在保留 Chromium 生态兼容性的基础上,对 Blink 渲染引擎与 V8 引擎进行面向 Agent 场景的深度裁剪调优。依托英特尔 AVX512、IAA、QAT 等硬件加速能力,单浏览器实例内存开销最高降低 30%,为高密度并发部署留出空间。通过沉淀可复用 RPA 工作流,同类重复任务的执行成本仅为传统办公 Agent 的百分之一,同时支持上百个浏览器实例并行运行,成为智能体对外执行任务的核心入口。