

 搜索


这两天看到几条科技新闻,我觉得放在一起看,比单独看任何一条都有意思。
先是英伟达。10月21日,它发布了一套名为DSX POD的新方案,准备把AI数据中心需要的计算设备、机架级供电、网络布线和液冷等系统提前集成好,再以模块化的方式运到现场部署。按照英伟达公布的目标,在场地基础条件已经具备的情况下,原本可能需要六个月的现场部署工作,最快可以压缩到14天。
英伟达这些年靠GPU已经赚得盆满钵满,现在连数据中心怎么建、怎么装、怎么交付,都开始认真研究了。
但真正让我觉得有意思的,不是那个集装箱,也不是14天这个数字,而是英伟达正在把自己的竞争力,从芯片延伸到整套算力系统的交付。
几乎同一时间,国内也有一连串动作。中兴通讯推出了新一代模块化智算基础设施产品,华为此前发布了3D数据中心架构,国产1024卡液冷超节点也传来了新的进展。另一边,三星和SK海力士正在推进中国NAND闪存工厂的技术升级。
这些新闻看起来没有直接关系,但我觉得,它们恰好说明了一件事:AI产业接下来的竞争,可能不只是看谁拥有更多、更强的芯片,而是看谁能把算力更快、更高效地变成真正的生产力。
而当竞争开始朝这个方向发展,中国企业长期积累的制造、通信、电力和工程能力,可能迎来一次新的价值释放。
一、英伟达为什么开始操心数据中心怎么建了?
过去几年,AI行业最容易吸引眼球的数字,往往是GPU数量。哪家公司采购了多少张计算卡,谁家的算力集群规模又扩大了多少,已经成为衡量AI投入的重要指标。
但这里其实有一个容易被忽略的问题:买到了GPU,就意味着马上能用上这些算力吗?
显然不是。
一座AI数据中心从设备采购到真正投入运行,中间还有大量工作。服务器需要稳定的电力供应,液冷系统需要处理越来越高的热负荷,高速网络要把大量计算设备连接起来,整套系统还得经过安装、调试和验证。任何一个环节跟不上,都可能让昂贵的计算设备迟迟无法投入使用。
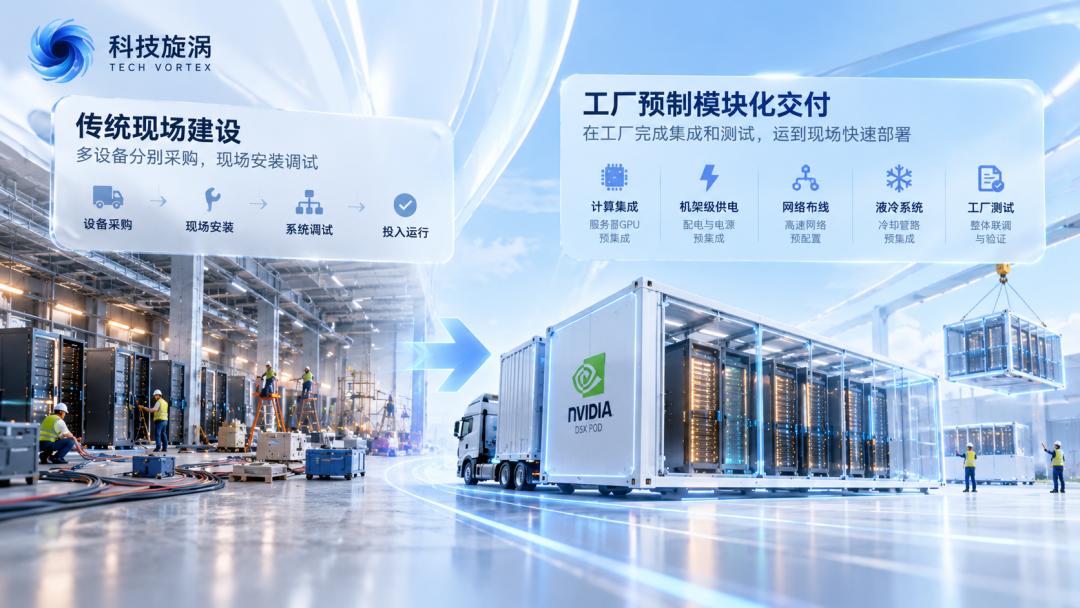
英伟达这次发布的DSX POD,就是试图解决其中一部分问题。它希望把原本需要在数据中心现场完成的大量集成工作,提前搬到工厂里。设备在工厂完成集成和测试,再运到现场部署,尽可能减少施工和调试的不确定性。
当然,模块化数据中心并不是英伟达发明的。DSX POD目前也主要是一套围绕新一代Vera Rubin计算平台设计的参考架构,相关合作伙伴预计从2027年初开始提供产品。所谓最快14天的部署周期,同样建立在外部供电、冷却和网络等基础条件已经准备好的前提下,并不意味着从零建设一座数据中心只需要两周。
但这些并不影响我对这件事的判断。
过去,英伟达最重要的优势来自GPU性能和CUDA生态,客户买到设备之后,还需要解决大量系统集成与部署问题。现在,英伟达正在进一步介入这些环节,试图让客户更快地把采购的硬件变成可以实际运行的算力。
这里面的商业逻辑很直接。对于投入巨大的AI数据中心而言,计算设备闲置一天,就意味着成本和潜在收益的损失。随着AI基础设施越来越昂贵,部署效率、运行效率和长期成本的重要性自然会不断提高。
英伟达已经不满足于让客户买到更强的芯片,而是开始关心这些芯片什么时候真正跑起来。
在我看来,这可能比14天部署的宣传数字更值得关注。
二、中国企业的机会,恰恰藏在这些“不起眼”的环节里
如果沿着英伟达的思路继续往下看,会发现一个有意思的现象:当AI基础设施越来越强调模块化、标准化和快速交付,原本没有GPU那么耀眼的制造与工程能力,反而变得越来越重要。
就在英伟达发布DSX POD的前一天,中兴通讯推出了ZXEDC M8000智算微模块方案,将液冷机柜、网络、供配电和监控等系统进行模块化集成,面向高密度AI计算场景。
这类产品没有新一代GPU那么容易制造话题,但解决的问题非常实际。过去建设数据中心,很多设备需要分别采购、安装,再由不同团队完成连接和调试。现在,厂商开始尝试把这些工作提前整合,让数据中心建设从大量现场施工,逐渐转向更加标准化的系统交付。
更值得关注的是,中兴这次并不只有产品发布。
根据中兴官方披露,2025年,它曾获得国内某互联网企业长三角算力中心项目666套IT模块订单,其中345套M8000 IT POD已经完成交付。从订单下达到设备抵达现场,大约用了一个月。
这里需要注意,一个月指的是从下单到设备到达现场,并不是整个数据中心的建设或投运周期,也不能直接拿来和英伟达的14天部署目标比较。
但这个案例至少说明,模块化智算基础设施在国内已经不只是发布会上的产品概念,而是进入了实际项目交付。
我觉得这比简单争论谁先提出模块化更有价值。因为真正的竞争不在于谁把方案讲得更漂亮,而在于能不能把复杂的设备系统做成可重复生产、可稳定交付的产品。
华为9月发布的3D数据中心架构,则从另一个方向回应了同样的问题。它尝试把供冷、IT设备、供电和备电系统进行立体分层组织,改善高密度计算设备的部署条件,并结合工厂预制、现场装配等方式提升建设效率。
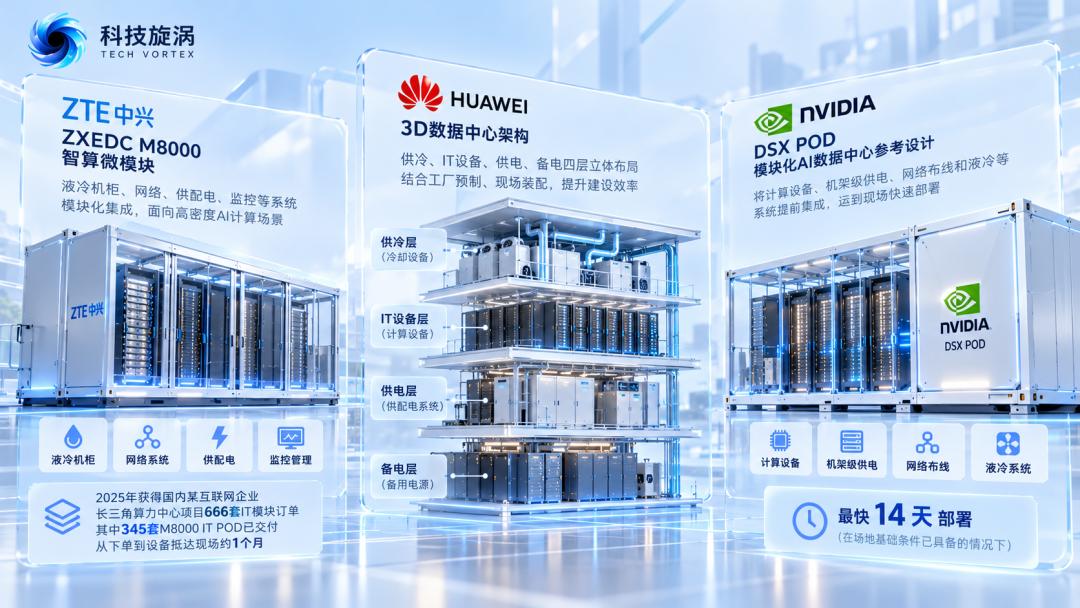
中兴、华为与英伟达的方案并不完全相同,技术路线和适用场景也有区别,不能简单比较谁更先进。但它们都在回答同一个问题:当AI计算设备越来越密集、越来越昂贵,怎样才能更高效地建设和运行这些基础设施?
我觉得这里有一个很值得关注的变化。
过去讨论国产AI,我们很容易把注意力集中在模型和芯片上。哪个模型刷新了榜单,哪款国产芯片性能提升了多少,往往更容易成为热点。但当AI进入大规模应用阶段,供电、散热、网络和工程交付的重要性,会被越来越多的人重新认识。
而这些环节,恰恰与中国制造业长期积累的能力密切相关。
中国有庞大的电子制造和通信设备产业,有成熟的供配电、散热和工程建设体系,也有大量数据中心建设与运维经验。当AI基础设施逐渐从定制化工程走向标准化产品,这些能力就有机会被重新组合,形成新的竞争优势。
这并不意味着中国企业已经在所有技术上领先,但至少说明了一点:
英伟达正在推动的产业变化,并不只会扩大英伟达自己的优势,也可能让中国企业找到新的竞争空间。
而且,国内最近还有一个案例,让我对这种可能性有了更具体的认识。
三、1024卡超节点,真正值得关注的不是1024这个数字
10月15日,据同期公开报道,首套1024卡昇腾Atlas 950 SuperPoD液冷超节
这条新闻很容易被理解成国产算力规模又变大了,但我觉得,它真正值得关注的地方,并不是1024这个数字,而是国产计算平台正在尝试解决一个更难的问题:如何让大量芯片不只是放在一起,而是真的能够高效协同工作。
大模型计算尤其是采用MoE架构的模型,对芯片之间的数据通信提出了很高要求。如果互联效率不够高,计算设备即使数量很多,也可能花大量时间等待数据,最终无法充分发挥理论算力。
华为的超节点采用高速互联架构,试图把1024张昇腾NPU组织成一个更加紧密的计算系统,同时通过液冷和系统级设计,解决高密度部署带来的散热与运行问题。
这件事与英伟达正在推进的数据中心产品化,其实处在同一条产业链的不同环节。英伟达希望让计算系统更快完成部署,而国产超节点则在探索如何让大量计算芯片更有效地协同运行。
当然,设备点亮并不等于已经完成长期生产环境验证。超节点的实际计算效率、稳定性和成本表现,还需要更多真实业务负载和独立测试来证明。
但我觉得,这至少说明国产AI算力的讨论正在发生变化。过去大家更关注单张计算卡的性能,现在越来越多企业开始把高速互联、内存、液冷和软件调度放在一起考虑。
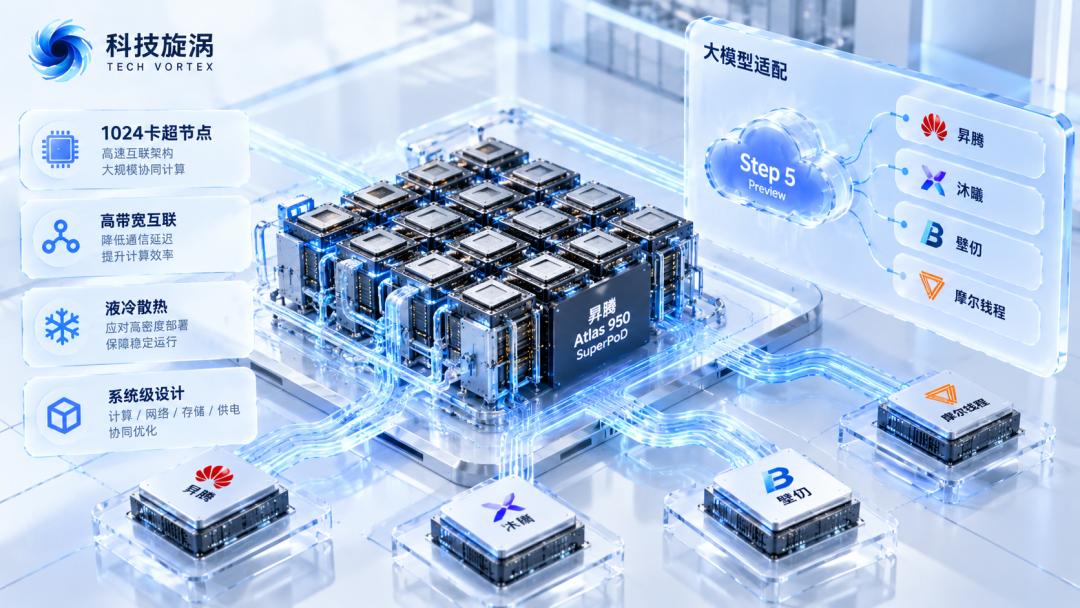
同一天,多家国产计算平台宣布支持阶跃星辰的新模型,也体现出另一层变化。对于开发者来说,一套硬件系统再强,如果新模型无法及时适配,实际价值也会受到限制。模型发布与计算平台适配之间的时间差,正在成为衡量生态能力的一个现实因素。
当然,宣布支持不等于已经完成所有场景的性能优化,但模型和硬件之间能够更快建立适配关系,本身就是国产计算生态需要持续完善的能力。
把这些进展放在一起看,会发现国内企业已经在从不同方向解决AI算力落地的问题。超节点关注计算效率,模块化数据中心关注部署效率,模型适配关注应用能否顺利运行。
它们还没有形成一套已经全面验证的统一方案,但正在逐渐构成国产AI基础设施发展的不同环节。
中国AI真正值得期待的,可能不只是下一颗性能更强的芯片,而是这些能力能不能逐渐连起来。
四、三星和海力士的中国工厂,提醒我们别忽略制造体系
就在关注这些AI基础设施新方案的时候,我还注意到另一条新闻。
10月21日,路透社报道称,三星和SK海力士正在推进中国NAND闪存工厂的技术升级。其中,三星西安工厂涉及更高层数的NAND工艺,SK海力士大连工厂也在进行相关产线升级。两家公司确认了升级工作,但报道中的部分具体技术目标仍来自知情人士。
这件事发生在先进半导体设备出口限制仍然存在的背景下,因此格外值得关注。相关升级仍然受到美国设备出口许可等要求的约束,不能简单理解为所有技术升级计划都已经获得批准。三星也明确表示,此次升级并非扩建产能或新建工厂。
但我觉得,比起简单讨论企业为什么还要继续升级中国工厂,更有价值的问题是:为什么这些已经运行多年的制造基地,仍然具有如此重要的价值?
一座成熟的半导体工厂,价值从来不只是设备和厂房。它背后还有多年积累的工艺经验、工程人才、生产管理体系和供应链协同。即便拥有资金,也很难在短时间内把这些条件完整复制到另一个地方。
对于三星和SK海力士这样的全球存储企业,中国工厂是长期全球制造布局的重要组成部分。随着存储技术不断迭代,保持现有产线的竞争力,本身就是企业正常的产业经营需求。
与此同时,中国本土存储产业也在发展。根据路透社援引的Omdia数据,2026年第二季度,长江存储在中国NAND市场的份额达到38.5%。这只是中国市场的数据,并不意味着中国企业在全球存储产业已经全面领先,但它说明本土企业正在形成越来越强的市场竞争力。
我不觉得有必要把这件事写成国际企业与中国企业之间简单的胜负关系。真正值得关注的是,中国正在形成一个既有国际企业长期制造布局,也有本土企业持续创新的存储产业体系。
NAND闪存虽然不是GPU,也不是大模型训练所需的HBM高带宽内存,但它是企业级SSD等存储设备的重要基础。随着AI数据中心规模扩大,计算设备之外的存储、网络和其他基础设施,同样需要持续升级。
三星和SK海力士的产线升级,与英伟达DSX POD并不存在已知的直接配套关系。但它从另一个角度提醒我们:
先进计算系统可以不断更新,支撑它们的工业制造体系却需要长期积累,而这种积累本身就是竞争力。
对于中国而言,这可能是比单纯讨论某一项技术领先或落后,更值得长期关注的产业价值。
五、下一阶段,中国有机会用自己的方式参与竞争
过去几年,我们讨论国产AI,太容易把注意力放在某一款芯片能不能追上英伟达上。
这个问题当然重要。先进计算芯片、制造工艺和软件生态上的差距,并不会因为中国拥有庞大的制造业基础就自动消失。国产AI要真正建立长期竞争力,核心技术突破依然是绕不开的任务。
但看完最近这些新闻,我反而越来越觉得,下一阶段值得关注的,可能还有另一件事。
当全球AI产业开始比拼算力交付效率,中国那些原本分散在芯片、制造、通信、电力和数据中心里的能力,终于有机会在同一条产业链上发挥作用。
这不意味着国产AI已经赢了,也不意味着系统集成可以替代核心芯片的性能进步。但如果未来AI竞争真的从“比谁拥有更多芯片”,逐渐走向“比谁能更快把算力变成生产力”,中国就不该只是一个追赶者。
因为这场竞争需要的不只是先进芯片,还需要制造能力、供应链组织、工程经验、软件适配,以及长期稳定运行的能力。中国企业在其中一些环节已经积累了相当丰富的经验,也正在通过新的产品和项目不断探索。
真正需要继续证明的,是这些分散的能力能否形成完整、可靠、成本合理的解决方案,并在实际应用中经得起长期验证。
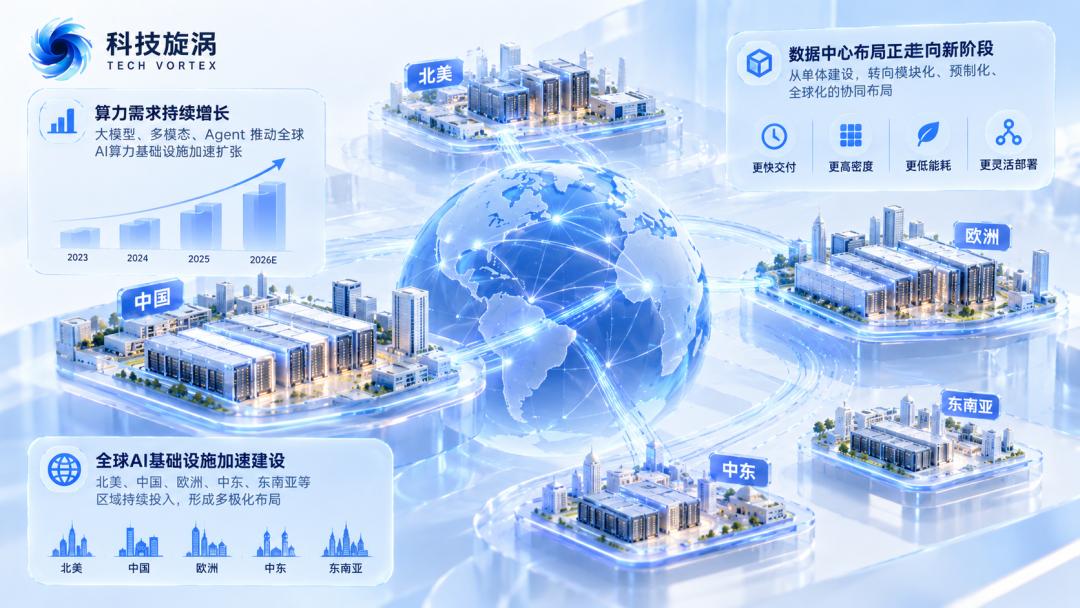
英伟达的新动作,让我们看到了全球AI产业竞争边界正在扩大。而国内企业最近的一系列进展,也让我更加确信,中国AI未来的竞争力,不一定只能沿着海外巨头已经走过的路线寻找答案。
下一阶段的AI竞争,当然还要拼芯片、拼模型。但谁能把这些技术真正变成可用、好用、用得起的算力,可能才是更值得长期关注的事情。
这场比赛,我们有自己的打法。
资料来源
NVIDIA Newsroom,2026年10月21日,DSX POD AI Factory官方发布。
中兴通讯官网,2026年10月20日,ZXEDC M8000智算微模块产品及项目交付情况。
华为官网,2026年9月16日,3D数据中心架构发布。
IT之家等同期报道,2026年10月15日,1024卡昇腾液冷超节点及Step 5 Preview模型适配进展。
Reuters,2026年10月21日,三星、SK海力士中国NAND工厂技术升级,以及Omdia中国NAND市场份额数据。
