

 搜索


“智谱已经实现了最小的闭环。模型优化系统,系统服务模型。”
近日,智谱首席科学家唐杰在社交媒体上,用这句话概括了智谱向递归自我改进(RSI)迈出的一步。
在智谱发布的《通往递归自我改进》中,一个由GLM-5.3驱动的Infra Agent,参与了GLM-5.3-Flash推理服务的搭建与优化。这套服务运行在十万张以上的国产AI芯片上,从第一次跑通到承接全部线上流量,只用了两周。
模型开始给自己干活了。它帮助优化自己赖以运行的系统,让推理更快、成本更低;优化过程中积累的任务、验证结果和修正经验,又可以成为后续研发的资源。唐杰所说的“最小闭环”,就从这里转了起来。
这距离AI完全自主研发下一代AI,仍有距离。但它带出了一个越来越具体的问题:当模型逐渐接过原本由人完成的研发工作,我们怎样知道,自我改进究竟走到了哪一步?
一次推理提速,可以用吞吐量和时延来验证;一个模型究竟承担了多少自身研发,又该拿什么来衡量?如果参与其中的Agent越来越多,人还能否看清它们在做什么,并及时干预?
Anthropic近日发布的《衡量前沿实验室内部AI的发展速度》,恰好把讨论推进到了这里。它提出了三个测量维度:AI承担了多少AI研发工作,Agent的行动受到怎样的监督,以及算力在模型研发和安全工作之间如何分配。这相当于给正在运转的研发流程装上三块仪表盘,让实验室外的人也能看到里面的变化。
按照Anthropic披露的数据,截至今年8月,Claude已经在人的监督下“主导”了26%的模型研发工作,2月时这一比例还不到1%。不过,在它测量的研发工作中,尚无任何一类达到完全自主的程度。
智谱展示的工程实践,让“AI参与改进自身”有了具体的样本;Anthropic提出的测量方法,则尝试让这种变化能够被持续观察和检验。闭环怎样转起来,转起来之后又如何衡量、监督,两篇文章由此接上了同一个问题。
什么是RSI的最小闭环?
在理解RSI最小闭环之前,得先理解唐杰的新观点。过去人们理解RSI,第一反应是“模型变聪明了,聪明到能自己进化”。
唐杰的理解恰恰相反,让循环转起来的,并不是智能,而是闭环。
一个系统哪怕不够聪明,只要它能持续地改一个东西、又有人能持续地判断它改得对不对,循环就能成立。反过来,一个再聪明的模型,如果没有人告诉它“你刚才那一步对不对”,它就算跑几个月,乃至几年,也只能在原地打转。
因此,在唐杰看来,想要凑齐闭环需要三块拼图。
第一,需要一个可被改进的对象。
模型不能碰到自己的权重,却能优化服务模型所配套的推理系统,比如kernel、并行策略、通信、内存管理、调度。
就像是你在办公室里需要喝咖啡来提神,但是咖啡机和饮水机离你太远,每次去喝咖啡的时候都要走很远。于是你把咖啡机搬到你的工位附近。
这样即使你每天干的活不变,也能提高工作效率。
唐杰认为,这套推理系统,就是实现闭环的关键。
第二,一个可验证的裁判。
改完得有人立刻拍板告诉模型,改得对还是不对,而且这个裁判还不能贵,这个过程叫做密集反馈。
正确性有参考实现,吞吐和时延有可比指标,对错能被客观裁决,也就是说,得有一把又便宜又硬的尺子。
第三,一个能自我供给的回路。
这一轮完成的任务本身,会变成下一轮的训练场,循环因此不需要外部不断投喂,而是自己长出下一圈。
三块拼图凑齐,循环才能自转。而智谱这次真正闭合的,就是第一块拼图,模型去优化推理系统。
虽然这个最小的闭环没办法真正意义上提高模型的智能,但是它降低了模型在自己造自己的成本。只有把自己的工位调明白,才谈得上提高效率。
推理更便宜,意味着同样的预算里能留更多算力给训练。服务系统更高效,那么下一代模型就可以站在一个更稳的台阶上。
基于这个闭环,GLM-5.3-Flash的生产推理服务跑在十万张以上的国产AI芯片上,从第一次跑通到承接全部线上流量只用了两周,端到端吞吐提升约三倍。
更关键的是循环里流动的东西。模型从SGLang、Flash Linear Attention、DeepGEMM这些现成kernel里提炼“优化骨架”,把适用条件和验证证据一并沉淀下来,验证过的做法回流成库,下一轮就更省力。
Agent完成的每一个任务,都能从中继承,训练不再是一次性的,而是变成了一种复利。
就像我在写文章之前会去找参考资料,要不然根本没办法理解智谱这篇文章里面提到的关键信息。然后我再把这些信息转化成为大家都能理解的大白话。同时我也能在找信息的过程中,提升我对RSI的理解,以便在下一篇文章中写得更好。
那接下来,这个循环能扩多大?
唐杰认为,扩大的本质,是把“可验证环境”从工程域复制到更多域。究竟能扩多大,取决于第二块拼图。
正如前文提到的,这个裁判得便宜、快速,而且它输出的结果能被客观验证。
凡是满足这三条的领域,都能被卷进RSI当中,比如代码、数据处理、形式化验证,以及任何可被测量的系统。
反过来,没有客观裁判的地方就扩不动,像是战略、审美、叙事,那里找不到一把又便宜又硬的尺子。你说一个故事讲得好不好,模型说好、你说不好,谁说了算?
决定Agent是反馈
这个循环到底卡在哪。
唐杰在长文里这样表示,当那个Infra Agent卡住的时候,很少是因为它写不出代码,而是因为它不知道事情为什么变坏了。
比如说,这个裁判反馈给AI,说它“吞吐掉了20%”。那只说明有东西坏了,它不说明是哪一层坏的、当前假设错在哪里、下一步该测什么。
唐杰说,这是强化学习里遗留下来的老问题:稀疏奖励和信用分配。
你往往要在一个动作全部做完、端到端跑完之后,才拿到一个“好”或“坏”的信号,而这个信号又无法归因到具体哪一步,探索自然就慢。
就像考试,考完老师说你得了60分,但是不告诉你具体哪道题出错了。于是你只能把整张卷子重做一遍,猜着改。
可能改了个根本没错的地方,真正错的那个地方还留着。
不仅如此,端到端的benchmark动辄要几个小时。模型提一个假设、改一处代码,就得等上半天才知道对不对,探索因此慢到痛。
然而这里面有个很神奇的现象,一个干了10年infra的老工程师看到同样的问题,他去优化这些问题,可能只需要不到1个小时。因为他有一套说不清的直觉。改完一段代码,他可能自己都不知道自己怎么判断的。
这些老工程师的想法就是“嗯,感觉不对,我去看看时间线”“嗯,这里可能要跑个microbenchmark比一下”。
这套东西长在他脑子里,他说不出来步骤,也写不成文档,可就是管用。
唐杰想做的事情,就是把老工程师脑子里那套“说不清但管用”的直觉,变成模型可以直接调用的分层验证接口。就像老师傅带徒弟一样,讲给AI听。
正确性反馈回答“算对了吗”,就用参考实现和误差容限判断计算是否正确;系统行为反馈回答“时间花在哪了”,就用执行时间线和运行时事件,揭示计算、等待、通信之间的时序关系;性能反馈回答“哪个方案更好、在什么条件下”,就用受控实验和可比指标,判断哪条路真的更优。
原文给出了三个案例用于解释。
第一个是KV transfer。工程师先给Agent定了一个验收条件:同样的负载下,Prefill加传输和纯Prefill的差距不该超过5%。
结果Agent发现,某些场景下这个差距超过了20%。这条反馈没有直接给出答案,但它把调查范围收窄到了KV传输引入的额外开销和并发交互上。
师傅在灶上炒菜,菜炒好了就要端到餐厅去。本应该是师傅炒下一道、服务员同时端走上一道,两不耽误。
结果传菜门只有一把钥匙,师傅炒菜的时候把钥匙揣自己兜里了。服务员要端菜出门,得等师傅掏钥匙开门。师傅炒嗨了,忘了掏钥匙这茬,服务员就站在门边上干等。
Agent顺着时间线甚至一路追到了Python和C++,DeepEP的节点内路径没有显式释放GIL,同一进程里负责传输的Python线程因此抢不到锁,本该与计算重叠的KV传输被调度堵住。
进入C++并不会自动释放GIL,正是这个细节,解释了为什么底层明明支持异步,高层却没兑现。修好之后,Prefill加传输与纯Prefill之间的差距,从两成以上压到了1%以内。
第二个是KDA精度漂移。在kernel验证过程中,CP与非CP路径的结果出现了差异,调查于是转向并行执行引入的状态传播与合并计算。
Agent发现根源是tf32。原始实现里tl.dot默认用tf32计算以求性能,即使输入是fp32,这种更低的精度也会在状态矩阵的链式合并中不断累积误差,序列越长越明显。
老师在台上说了一句话,让第一排学生记下来,传给第二排,第二排传给第三排,一排一排往后传。
但是有个学生记笔记的时候偷懒了。他不是逐字记,只记了个大概意思。就像tf32为了跑得快,把小数点后面的位数砍了一半,每算一步就四舍五入丢一点精度。
第一排传给第二排,意思差了一
修复办法是显式把精度提到tf32x3,在尽量保留Tensor Core性能的同时压低累积误差。这个修复后来还被合并回了Flash Linear Attention上游(PR #1180)。
第三个是解码kernel。Agent接到“计算是主要瓶颈”的反馈后,发现原始实现沿着V维度切分,导致同一段FP32归一化和门控计算被重复算了四遍。它把切分合并进同一个线程块,让中间结果常驻寄存器,用一次warp级归约替代重复计算,最终相对上一版提速1.71倍。
清华那一课:他布置的作业,,就是这篇文章的循环
这两天唐杰在清华开课,教室里人山人海。有意思的是,唐杰这门课作业非常多。
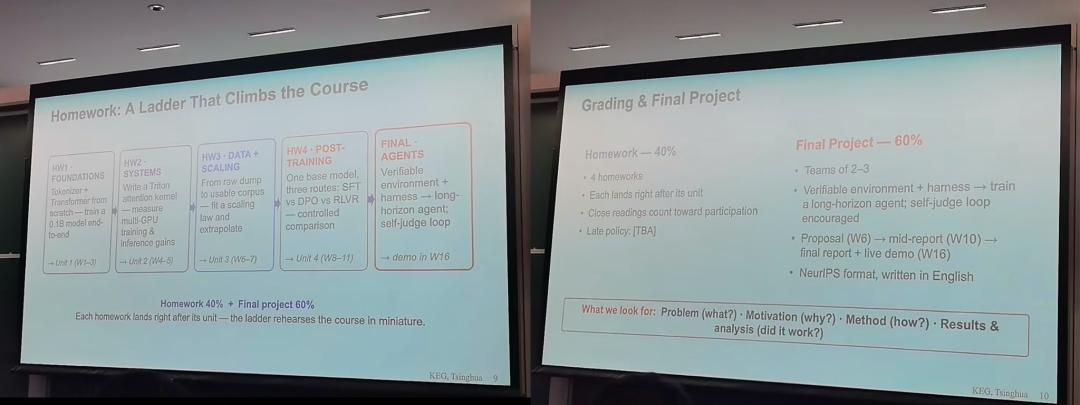
作业清单如下:
从零写Tokenizer加Transformer,端到端训一个0.1B的模型;手写Triton attention kernel,自己测多卡训练和推理的增益;从raw dump洗语料,拟合scaling law再外推;在同一个基座上把SFT、DPO、RLVR 做对照;搭可验证环境加harness,训长程Agent,鼓励self-judge loop。
交付方式为2到3人组队,英文NeurIPS格式,第16周现场 demo。作业占40%,大项目占60%。
搭可验证环境、训长程Agent、鼓励 self-judge loop,这三者其实就是“密集反馈”循环的青春版。
可验证环境,对应那个可被客观裁决的裁判;长程Agent,对应循环里那个执行者;self-judge loop,则对应“完成的任务变成下一轮训练场”的自举机制。
好消息是,Anthropic给唐杰留下的作业做了补充。
Anthropic认为,公众看不见前沿实验室里究竟如何在RSI。为了补上这道信息差,它提议给“AI发展速度”装三块仪表盘。
第一块,用来计算AI到底替人干了多少研发,基于Epoch AI的AL0到AL5六级标尺给每类研发任务打分。
截至2026年8月,Claude已经“主导”了26%的模型研发任务,而2026年2月这个数字还不到1%。
第二块,是计算对AI Agent的监督了多少。
在Anthropic最常用的内部平台上,随时约有3万个Agent在干活。它们的一举一动都要过两道监控:线上监控在执行前实时拦截,线下监控在事后复盘。
2026年8月,超过十亿次决策里只有0.002%(约四万七千分之一)被拦下;线下监控每周标记约十万条记录,其中约五十条升级给人工复核。
第三块,追踪算力花在哪。在7月13日到20日这一周,Anthropic投向AI研发的算力里约6%用于安全,投向“AI驱动的研发”的算力里约12%用于安全。
Anthropic也承认,这些数字眼下只能自己报,既缺跨实验室的统一口径,也难免“自己评自己”。它的打算是引入独立第三方评估者,把内部流程、系统和数据向它们开放。
