

 搜索


你有没有碰到过这种场景:
把一堆资料交给AI,让它写报告、核对出处,再做成PPT。
第一版出来后,你觉得结构不对,在对话框里打了几个字:「把结论提到最前面」;
第二版出来后,你又来了一个想法,补上一句:「再补一页竞品对比」。
在你的界面上,你不过是多打了两句话。
但在后台,你每追加一次要求,应用都可能再次把原始材料、任务说明和聊天历史交给模型。如果这些旧内容没有命中缓存,就需要重新处理。
你只改了两句话,后台却可能又算了一遍早已读过的材料。每一次重新阅读,都在烧掉你的计算费用与等待时间。
这笔藏在后台的重复开支,正是OpenAI最近一次升级瞄准的问题。
9月22日,OpenAI公布了GPT-6提示缓存(Prompt Caching)的重磅升级,提高默认缓存命中率,并提供更细的监测、诊断和控制手段。
能省多少?
按官方公布的费率计算,同一段材料连续使用10次,如果首次写入后,后续9次全部命中缓存,仅这段重复输入的成本,理论上就能省下78.5%。
其中,命中缓存的输入,读取价格只有普通输入的十分之一。
当AI开始替我们承担耗时几小时的复杂工作时,挑选工具就多了一道考量:除了「能不能做完」,还要看「等多久」和「花多少钱」。
但缓存输入打一折,我们的总账单也能跟着打一折吗?
缓存到底存了什么?
把「算过的草稿」留下来
要搞懂它怎么省钱,先得明白AI是怎么「阅读」的。
当模型读取大段文字时,它并不会像人类一样纯粹靠肉眼看,而是会在内部计算出一组复杂的中间状态,业界称为KV状态。
在生成接下来的回答时,模型需要时刻回看这些状态,以保持前后逻辑一致。
所谓提示缓存,保存的正是这部分已经计算好的中间结果。
你可以把它形象地理解为:上一次解题时留下的「计算草稿」。
下一轮对话时,只要题目开头没变,AI就不需要重新在草稿纸上算一遍,直接拿过草稿继续往下写就行。
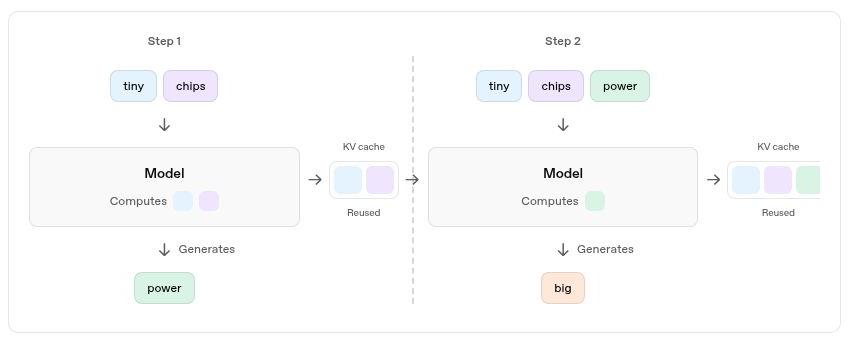
官方文档展示KV状态复用,已算内容可供后续步骤使用。
这里有两个非常关键的前提:
第一,缓存不等于记忆。
它不是给AI装上了永久记忆库,也不是直接把上一次的答案复制粘贴给你。
面对你的新提问,AI依然要认真思考并生成新回答,它只是省去了「重读旧资料」的重复劳动。
第二,复用必须满足精确匹配。
两次请求的前半部分必须一模一样,这段完全相同的内容,就被称为「共享前缀」。
这个前缀不仅包括你打出的聊天文字,还涵盖了系统的隐性指令、工具定义,以及图片、文档和音频等上下文。
对于GPT-5.6及之后的模型,能触发缓存的共享前缀至少需要达到1024个可见输入token。
而且缓存是有保鲜期的:最近一次写入或使用后,它会在服务器上保留至少30分钟。
只要在这期间再次调用,保鲜期就会重新刷新,不用再交一次写入费。
但待在同一个聊天窗口里,并不意味着100%能命中缓存。
如果请求被分配到了不同的服务器机器,或者跨越了不同区域,缓存依然可能失效。
读取打一折
为什么总账单不能直接除以十?
OpenAI宣称命中缓存的输入最高打一折,那为什么整体账单不能照这个比例削减?
因为天下没有免费的午餐,要把资料第一次写入缓存,本身需要先付一笔「开房费」。
根据最新的开发文档,对于GPT-5.6及之后的模型,首次将材料写入缓存的价格是普通输入的1.25倍;而后续如果成功命中缓存,读取价格则是普通输入的十分之一。
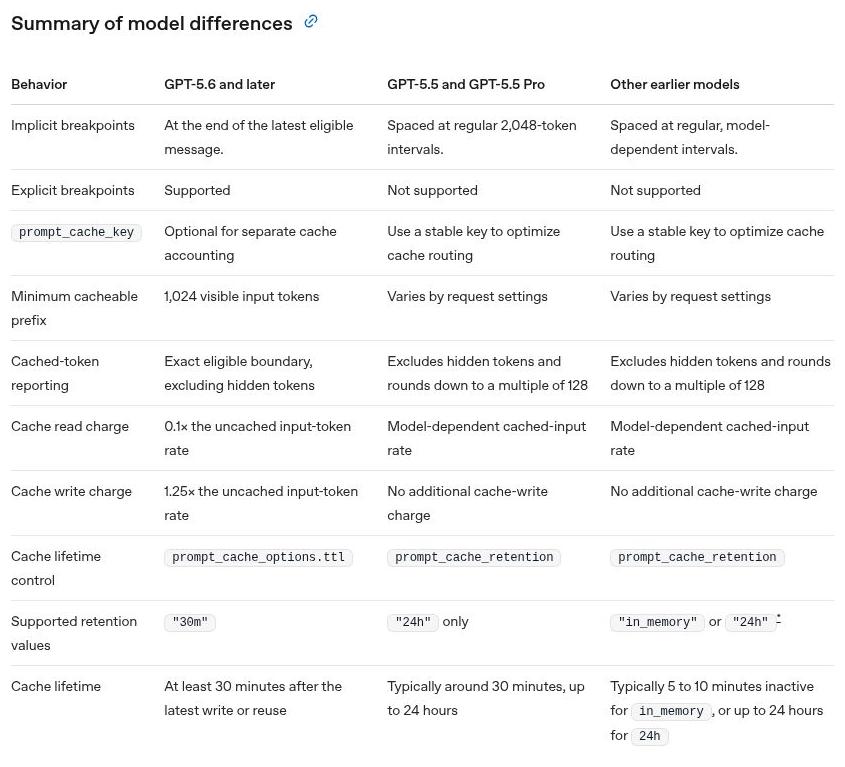
官方费率表:GPT-5.6及之后模型缓存读取0.1倍、写入1.25倍。
我们来算一笔最直观的账:
设你有一段庞大的资料,按普通输入处理一次算1份钱。如果连续使用10次,原本总共需要支付10份钱。
如果采用缓存机制,第一次写入,支付1.25份;后续9次全部命中缓存,每次支付0.1份,9次就是0.9份。
加在一起:1.25+0.9=2.15份。
相比原来的10份,费用直接从10份降到了2.15份,整整省下了78.5%。
这就是文章开头那个高达78.5%降幅的神奇数字的由来。
但请注意,这个高达78.5%的降幅,仅仅覆盖了那段「被重复使用的旧材料」。
在实际使用中,你的新提问、AI生成的输出内容,以及其他额外的计算,依然要按正常价格计费。
更现实的情况是:如果一段材料高价写入缓存后,你只用了一次就再也没理过它,你反而要承担更高的首次写入成本。
所以,优惠看单价,真正能不能省钱,全看复用率高不高。
为什么只改了一点
优惠就突然「断了」?
前面提到,缓存靠的是「精确匹配」。
AI是非常死板的,它无法理解「这两句话意思差不多」,只要开头有一丁点变化,缓存就会瞬间失效。
比如,有些应用为了记录时间,每次都会把当前的精准时间写在提示词的最最开头。这就导致后面的参考资料虽然一字未改,但因为开头的变化,整个前缀都无法匹配旧缓存了。
为了不让优惠断掉,开发者们总结出一条黄金法则:固定不变的内容永远往前放,经常变化的内容统一追加在后面。
在这次升级中,OpenAI还推出了几个非常实用的控制工具和方法:
一个是显式断点。
它就像是在文章里插入书签,明确告诉AI:「这段开头到这里为止是固定的,请帮我留待复用。」
它标记的是缓存的边界,而不是让AI暂停思考。
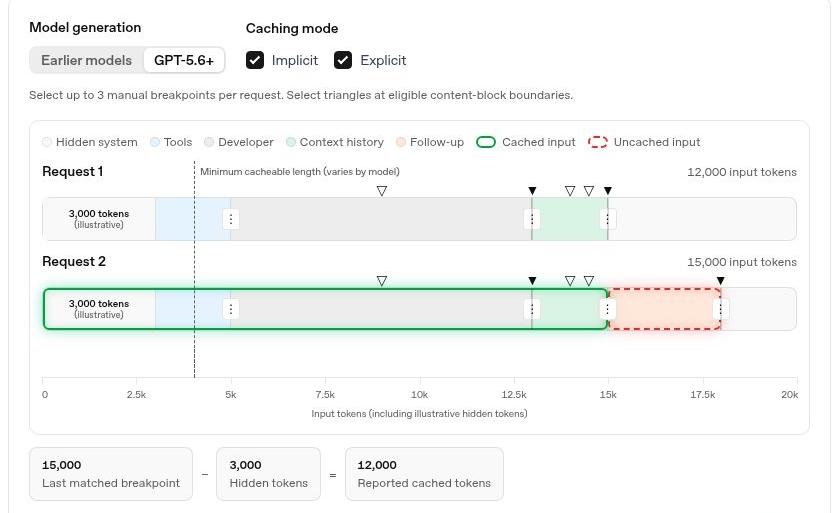
官方交互示例:绿色区域复用旧前缀,红色区域另行处理。
还有稳定工具定义。
改动工具的名称、调整参数顺序,都会破坏缓存。
OpenAI建议保持工具库的定义和顺序稳定,如果某轮对话不需要用某个工具,用控制参数暂时隐藏即可,千万不要直接把工具定义删掉。
第三个是慎重调整思考力度。
以GPT-6为例,如果直接修改全局的推理强度参数,同样会破坏前缀复用。
而如果在对话内部通过增量更新的方式调整思考力度,就能在改变AI思考精细度的同时,完美保住缓存。
当然,这些细节绝大多数都由应用层的开发者在后台默默处理,普通用户不需要背诵复杂的参数。
但应用代码写的优劣,却会直接决定你在界面前端等待的时间和花费的成本。
看得见损耗
AI才能真正提速降价
以前用AI,很多人都有过类似的困惑:
明明没聊几句,怎么Token消耗得这么快?究竟是哪里出了问题?
这次升级中,OpenAI补齐了监测与诊断能力。
在全新的缓存看板上,输入数据被清晰拆解:多少字来自缓存,多少字需要重新处理,命中率在什么时间点下滑,一目了然。
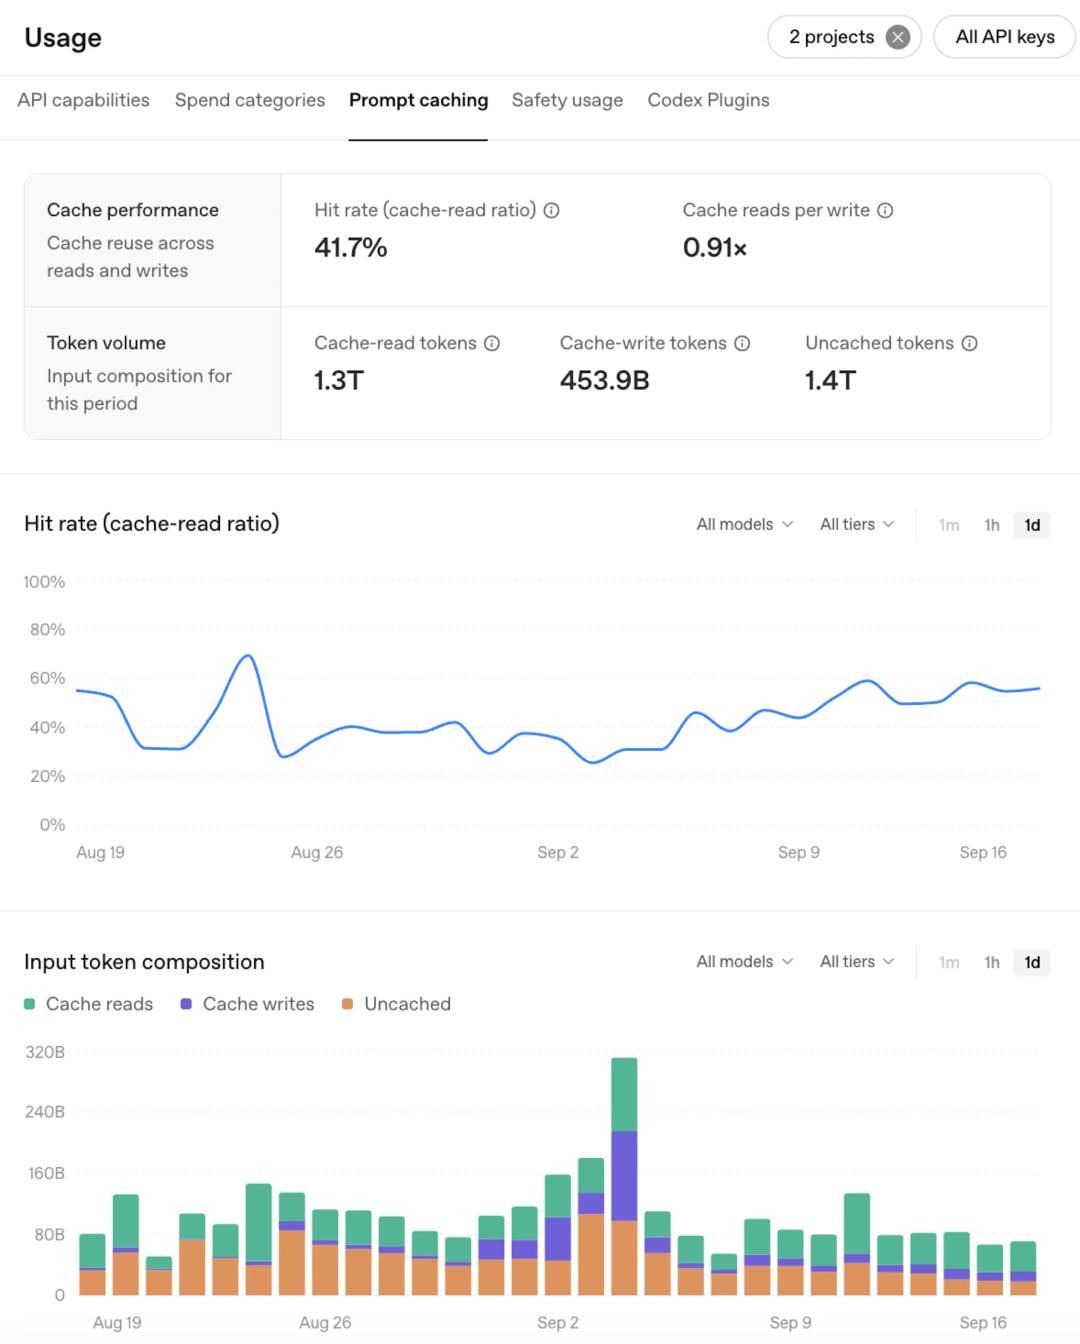
9月22日公布的缓存看板示例,展示命中率与输入构成。
而诊断工具则更像是一个排错专家,它能自动对比当前请求与历史响应,精准找出是哪个工具改了名字、哪条设置发生了变化,甚至能精确估算因此损失了多少个本可复用的Token。
官方示例显示,仅仅因为一个工具名称的微小变动,就导致了5629个Token无法命中缓存。
除了诊断,另一项更容易被用户感知到的改进叫「预热」(Warmup)。
当应用启动时,系统可以在你还没有打字之前,就先把已知的系统指令、工具说明或背景资料提前写入缓存处理好。
等你真正发来提问时,准备工作早已就绪,首字响应速度自然大幅提升。
预热并没有把计算变成免费(写入依然要按1.25倍计费),但它巧妙地把计算搬到了等待之前,极大地压缩了你的等待感知。
目前,像Manus这种AI智能体应用,其OpenAI模型的缓存命中率已从约85%提升并稳定在90%以上;GitHub Copilot在数万亿次的请求中,需要重复处理的提示Token占比相对此前基线下降超过50%,首字响应明显变快。
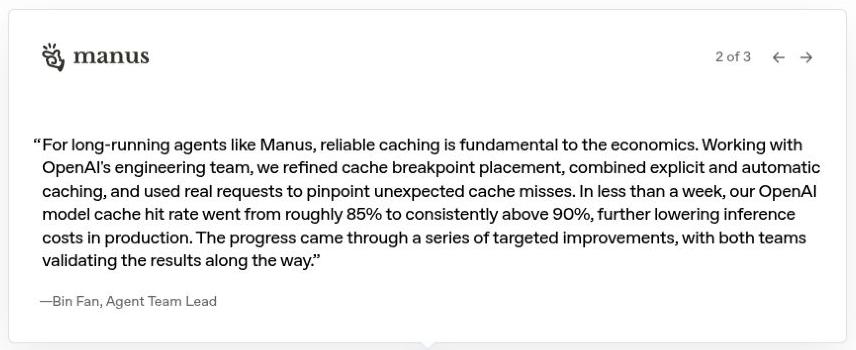
Manus团队称,优化后缓存命中率由约85%升至持续高于90%。
最后,我们用AI到底会不会更便宜?
看了这么多硬核改进,回到大家最关心的问题:我们用AI到底能不能省钱?
答案要分两种情况来看:
如果你是开发者,直接通过API按量付费使用模型,那么这些优化会非常直观地体现在你的账单和用量报表里,省钱立刊见影。
但如果你是普通用户,使用的是ChatGPT、Manus或其他按月订阅、打包收费的产品,中间还隔着一道产品的商业定价。
必须明确的是,这次更新并不是ChatGPT的降价公告。
底层计算成本的下降,最终可能会变成更便宜的订阅费、更充裕的使用额度,也可能会被产品方用来支持更复杂的AI功能。
但有一个趋势已经不可逆转:
当AI开始从「简单问答」迈向「连续干活几小时」的复杂任务,应用之间的竞争早已从单次调用的模型能力,延伸到了对底层计算资源的精细化运营。
模型标价可能完全相同,但怎样组织每一次请求、怎样最大化利用读过的材料,决定了谁能把极具性价比的服务交付到用户手中。
当AI替你干活成为日常,没有人会为「模型调用了多少次」而喝彩,大家只会为「事情终于高效做完了」而买单。
而接下来最值得期待的,正是这些省下来的计算成本,究竟有多少会真正变成我们手中的实惠。
参考资料:
https://openai.com/index/better-prompt-caching-for-gpt-6/
https://developers.openai.com/api/docs/guides/prompt-caching/diagnostics
