

 搜索


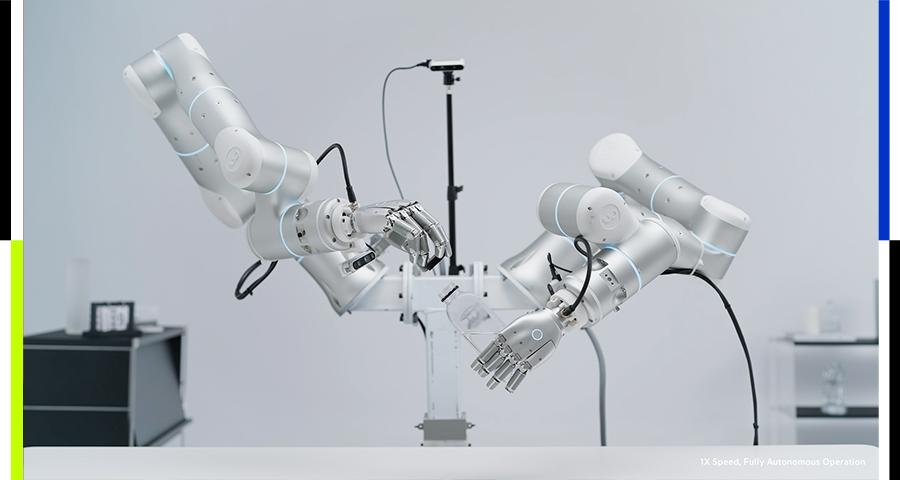
这两天,Claude Fable 5.2的消息大家都看到了,真机演示了拧瓶盖、解魔方、画画等任务,一气呵成,直接把双臂泛化成功率拉到64.9%,是Astra的两倍还高。
同一时间,蚂蚁灵波科技开源触觉基础模型LingBot-Touch,把磁触觉、视触觉、压阻式三类完全不同的传感器信号统一成同一套“触觉Token”,供不同灵巧手和动作模型使用,让机器人在“看得清楚、想得明白”的同时,进一步补齐精细操作所需的触觉感知。
通用大模型是否能“降维打击”具身智能?这两条技术路线的关系,正是当下具身智能行业讨论的焦点。在蚂蚁灵波看来,通用大模型与具身基础模型更接近1+1>2的协同关系:前者增强对任务和环境的理解与推理,后者补齐物理感知与闭环操作能力,两者齐头并进,才能共同加速具身产业成熟。
蚂蚁灵波首席科学家沈宇军对近期市场异动的看法略显犀利,他直言:“能用的工具,不等于最合适的工具。”他希望这个工具“不大不小”:关键能力没有短板,非必要能力尽量没有浪费。这里说的大小不是参数规模,而是能力配置。比如,具身模型不应把编程能力媲美Fable、Astra作为目标,因为完整的软件工程能力并不是机器人作业的刚需。反过来,对距离、触觉等物理模态的感知与理解,是数字世界模型并不原生具备、机器人完成高精度复杂操作却不可缺少的能力。
做触觉,不是选择题,是必答题
过去三年,具身智能一直被视觉和语言模态带着狂奔,行业里产出了一个个精彩的Demo,而一旦机器人进入真实世界,往往会倒在精细操作这一关。
在充分的落地实践中,行业里意识到,视觉和语言模态解决的是“接触之前”的思考,触觉解决的是“接触之后”的状态。当具身智能的“知”和“行”之间的鸿沟如此显眼,触觉已经不是选择题,而是必答题。
机器人能不能拿稳一件东西,往往要等手指碰到它之后,才见分晓。
触觉这一全新模态,逐渐走向行业舞台,只是,它过去几年也曾经走过弯路。比如,曾经的主流判断是:加入触觉,是不是反而给模型带来噪声,降低质量?触觉模态是不是应该等传感器路线完全明确再说?
而近几个月,关于触觉模态的共识,正在迅速反转。只是,尽管触觉模态的必要性已经形成共识,并不意味着行业已经找到统一的解决方案。目前,触觉传感器依旧存在三条不同的岔路——视触觉、磁触觉、压阻式触觉。
三种路线各有优缺点。视触觉通过观察柔性表面的形变获取接触信息,能够捕捉较丰富的接触形态,但难免受帧率拖累;磁触觉利用磁场变化感知受力,好处是薄、快,却怕铁磁干扰;压阻式是通过电阻变化测量压力,优势是便宜、也易铺大面积,但分辨率低、久用容易漂移。
技术路线的不收敛,也衍生出了大量行业痛点。由于缺少一个对三类异构触觉信号统一建模的触觉基座,无法生成通用的表征,行业研发效率极低。
举个直观的例子,一款机器人今天学会了“如何判断手指打滑”,但明天要换到另一款灵巧手或者触觉传感器上,这种经验就会直接作废。有工程师据此打趣道,每种触觉传感器就像各有各的“方言”,互相听不懂。
灵波此次发布的LingBot-Touch,正是试图粉碎这一痛点,其最大的特点是:通用、兼容。
灵波方面向我们大致介绍了整个触觉模型的训练过程。
首先,LingBot-Touch的数据主要来自两类真实操作:一类是由人佩戴触觉手套进行操作,采集了2197小时的压阻触觉数据、1136小时的磁触觉数据;另一类是通过遥操作Sharpa Wave双臂机器人,采集了1650小时的视触觉数据。
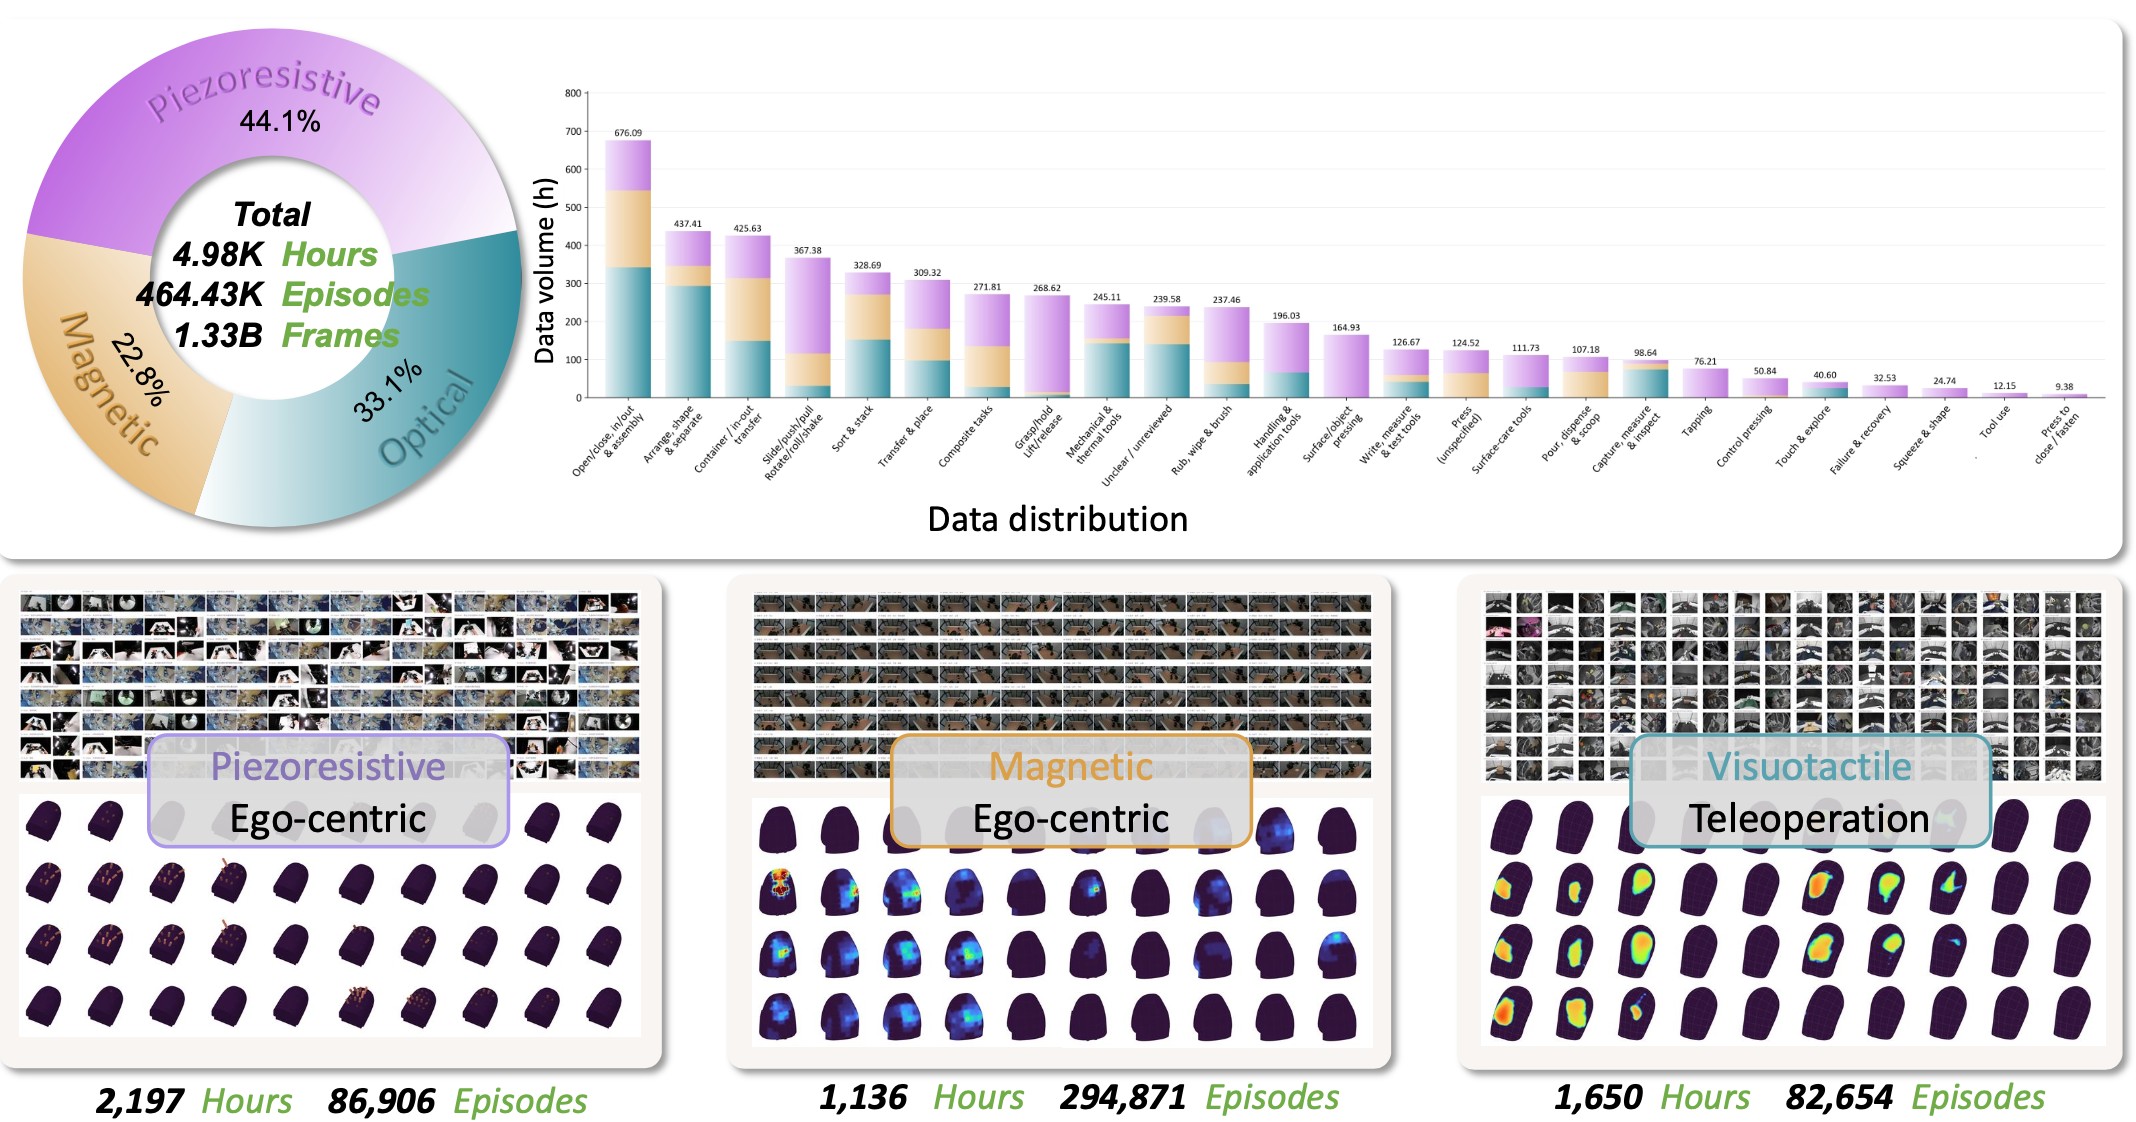
接下来的训练过程可以简要概括为三步:
第一,为了能让模型统一理解不同传感器产生的触觉信号,研究团队先将所有触点,映射到统一的标准指尖坐标系;第二,针对压阻、磁触和视触觉等不同传感原理,分别设计专用的Tokenizer(编码器);第三,将原始信号转化为模型可以处理的Token,最终输入同一个Transformer进行训练。
整个训练思路,有点像让模型做一道“填空题”——随机遮住一部分指尖的触觉信息,让模型根据其他位置的接触变化,推断被遮住的部分发生了什么。不过,它不要求模型精确还原传感器记录的原始数据,而是预测其中更有意义的特征,比如这些数值背后,代表了什么接触状态和物理变化。
最终达到的效果是,LingBot-Touch直接打通了过去传感器、灵巧手、任务、动作模型之间的层层阻碍。
举个例子,当你要换同原理的不同触觉传感器时,新型号不用重训练。若是需要更换灵巧手,即使新手上搭载的是预训练阶段没有见过的传感器,也可以直接接入。
另外,如果要换手部任务,不管是翻页还是拧盖,也不必重新训练一套触觉模型,只需要少量示范,就能让动作模型学会新的操作方式。甚至,需要更换底层动作模型时,也可以继续使用同一套触觉信息。
真机测试也验证了这一点。
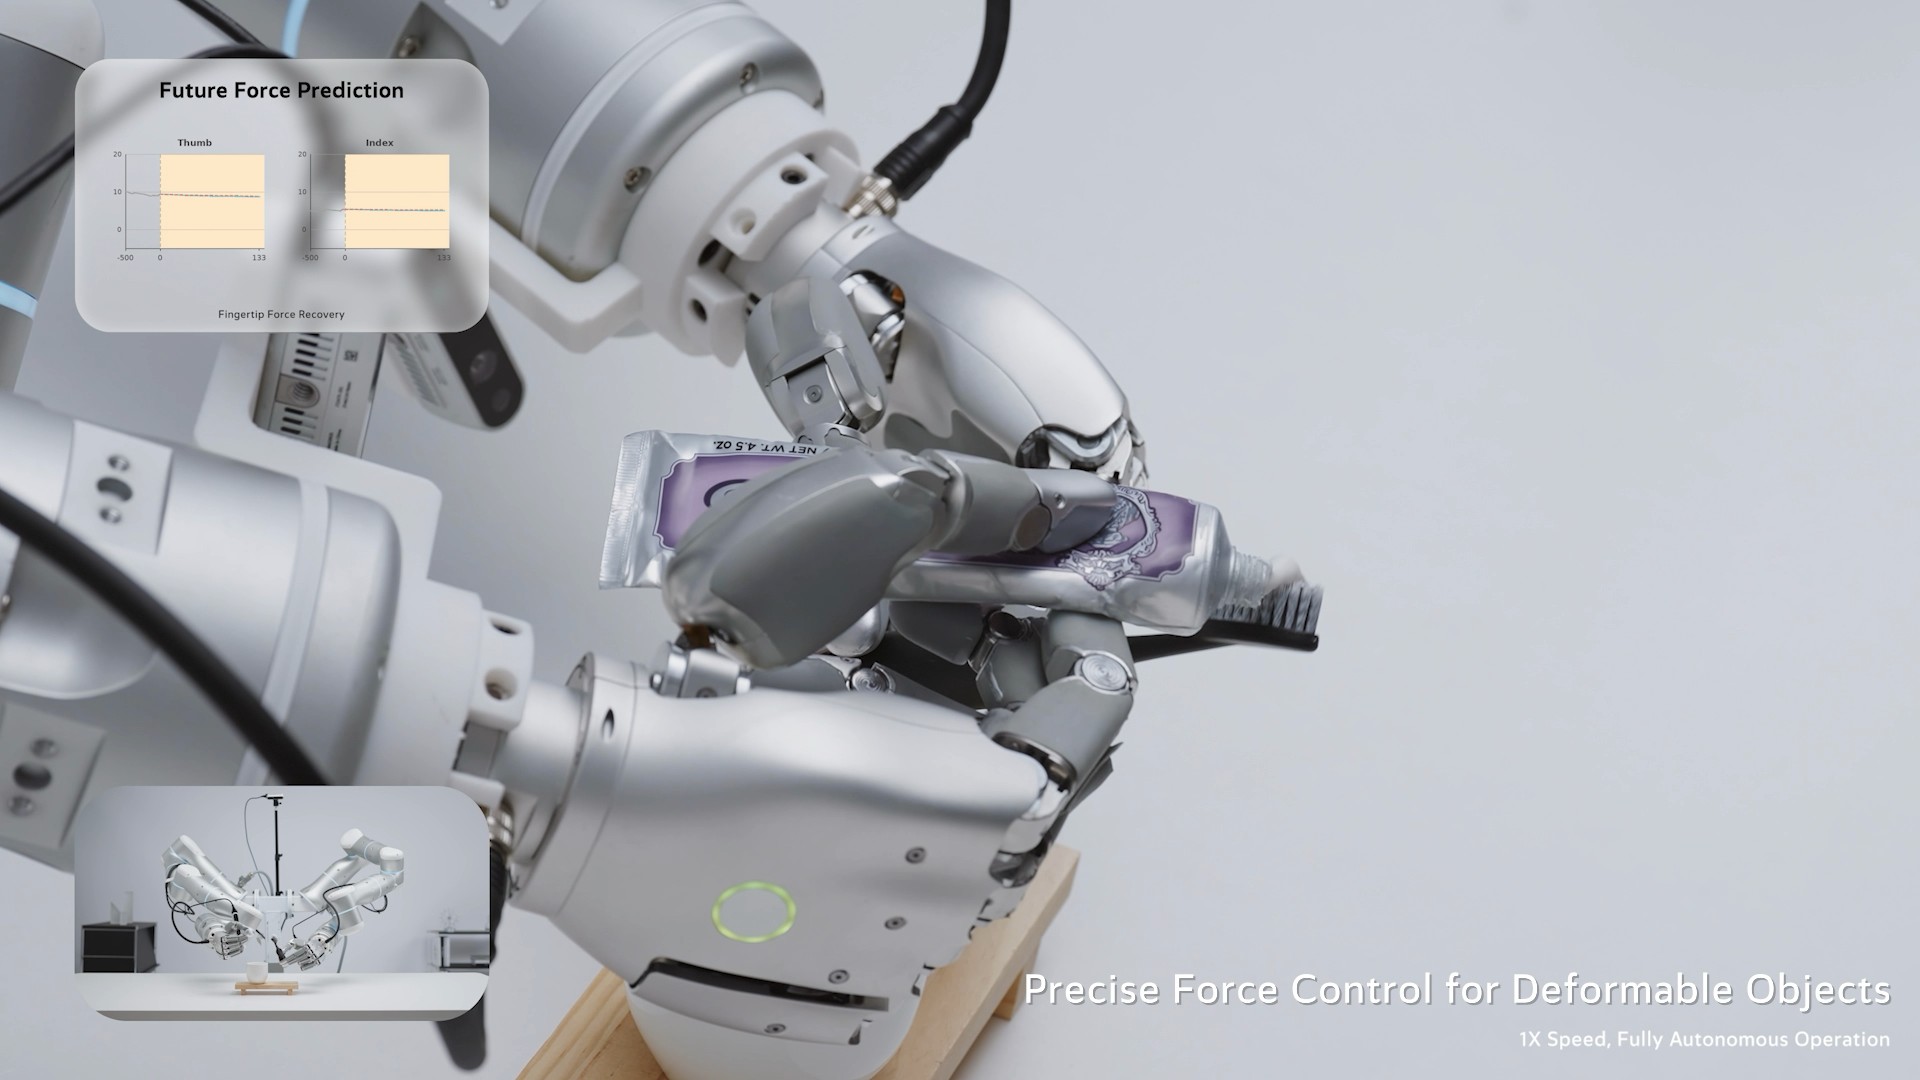
以拧瓶盖为例,Sharpa Wave在没有触觉模型时,成功率只有56.25%——在接入LingBot-Touch后,机器人能够感知瓶盖即将打滑、及时调整力度,成功率提升至90%。
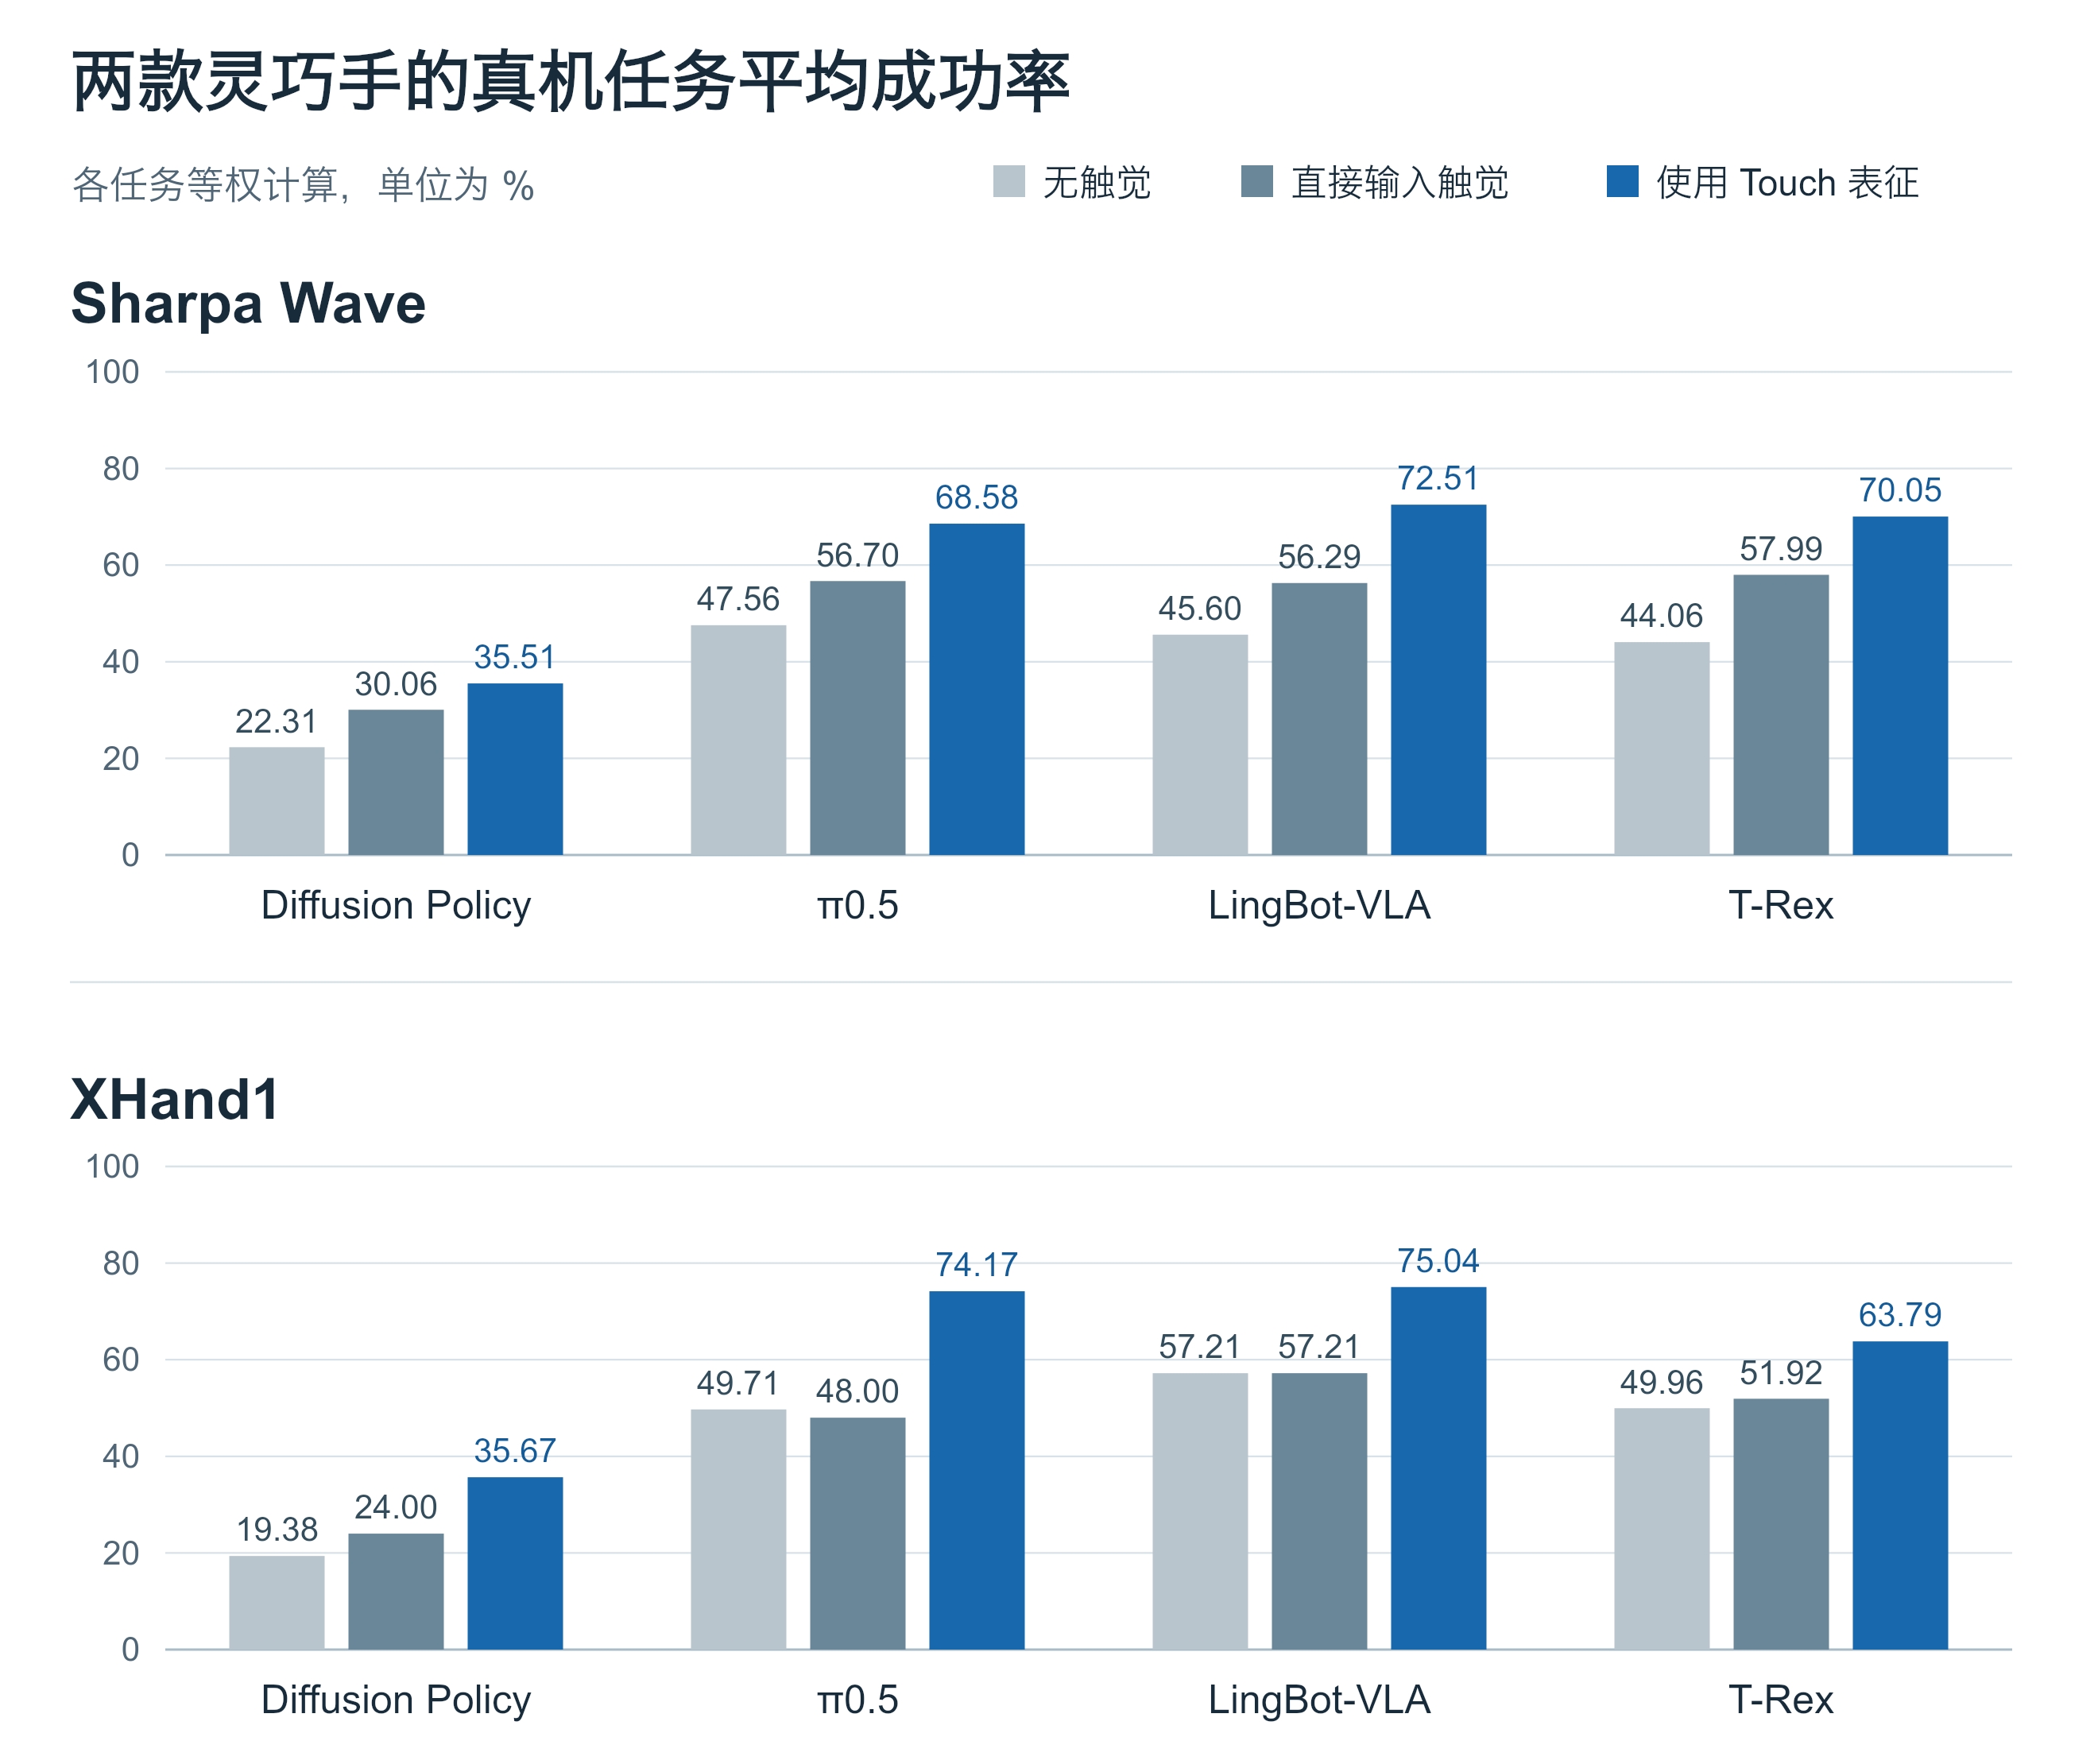
也就是说,当行业还在争论触觉怎么做、值不值得做的时候,灵波已经把它从一个“传感器选型问题”,变成了一个“底座能力问题”。这步棋走完,后面要回答的就不再是要不要触觉,而是触觉接入后,大脑够不够用。
基模猛攻,灵波为何还坚持具身原生?
在知晓了触觉的重要性后,可能会有观点认为,直接在基模上灌触觉,是不是机器人落地就万事大吉了?大错特错。
比如,有一类玩家直接把通用大模型当做现成的大脑,再补上动作数据,触觉信息,快速出作品。这类玩家的判断很现实,与其花大钱自研自己的大脑,不如直接“投诚”。但也有的做法更婉转,语义借助基模力量,但物理智能没有盲目嫁接。
与以上不同,灵波选择了一条更长坡厚雪、也更彻底的路线——坚持做具身原生的模型——前文提到的触觉模型,其实只是灵波大脑模型矩阵里的一个感官。
过去几年,灵波LingBot家族早已布局了一条深远的具身原生脉络,除了触觉,还覆盖了空间感知、世界预测、指令理解和动作生成。
在灵波首席科学家沈宇军他看来,基模与真实世界之间,至少存在三个鸿沟。
首先是数据鸿沟。这就正如人无法通过观看上万次费德勒打网球成为费德勒。互联网数据丰富且廉价,但真实世界的数据维度更多元——握网球用多少牛的力、手腕和指腹如何根据球的行径变化调整姿态。这些数据只存在真实的接触和实践里。
其次,物理世界不暂停。仔细观察可以发现,Fable 5.2在仿真环境下的思考和任务拆分虽然很强,但实际执行速度很慢。此前GPT-6 Astra的原视频也竟高达三个小时。真机需要毫秒级的变化,而云端大模型一个动作要思考数分钟,这在任务中早已出问题。
第三,直接往基模里简单粗暴投喂新的触觉模态,不一定1+1>2。灵波内部测试的一个例子是,以Sharpa Wave拉拉链为例,在不输入触觉模态时的成功率是39%——如果粗暴塞入触觉信息,成功率直接掉到15%,触觉反而成了干扰模型的“脏数据”。
因此,灵波反共识地提出“具身原生”的策略:理想中的机器人,不是“聪明的基础大模型配上触觉模态和机械臂”,而应该一杆子插到底——语义智能扎根数字世界,物理智能也要有自己的根,掌握真实世界的数据、自己的感官、自己的预训练方式。
在过去几年的蛰伏中,灵波大脑2.0已经打造了完整的原生技术栈。之所以称之为原生,是因为它并非简单把通用基础大模型的语言、视觉能力迁移到机器人身上,而是围绕物理世界中的感知、理解与行动,构建一套具身原生的模型体系。
据灵波方面介绍,灵波大脑2.0里的空间感知层由LingBot-Vision与Depth 2.0构成,让机器人不仅能识别物体是什么,还能判断物体的空间边界、距离和几何关系。
比如,面对透明杯、反光金属或堆叠杂物时,机器人不再只是根据二维图像猜测物体轮廓,而是要真正理解物体在三维空间中的位置与形态。
动态交互层通过LingBot-Video与World 2.0,则让机器人进一步理解物理世界的动态变化:不仅知道眼前有什么,还能预测自己的动作将如何改变环境。比如推开一扇门,不仅要知道门在哪里,还要预判门会如何转动、受到多大阻力,以及松手后是否会回弹。
触觉感知层则由LingBot-Touch补足视觉无法感知的信息,让机器人获得对接触位置、作用力和滑移状态的判断能力,相当于为大脑装上了一层皮下神经,使其能够感知物体是否正在滑落、抓取力度是否合适。
最后,操作执行层由LingBot-VLA 2.0与VA 2.0构成,将上述感知和预测能力转化为实际动作,让机器人能够在执行过程中持续推演、反馈和调整,而不是像传统模型那样,根据输入一次性生成动作指令。
值得注意的是,四个层次的模型矩阵的关系,不是简单的“1+1+1+1=4”,而是共享物理表征后的“大于4”。也就是说,Touch提取的力觉信息,将反哺VLA的抓取决策;World模型借助接触反馈校验预测;VLA的空间先验又会帮助Touch消除分歧。
我们或许可以用“机器人端起装满水的碗”这个案例来辅助理解——Depth告诉它碗沿在哪,Touch发现指腹开始打滑、碗在倾斜,World模型预判再不收力,汤就会洒,VLA立刻把力分配从“捏紧”改成“托底”。
其实,坚持具身原生的灵波也并非“少数派”,在海外,已经有一批公司不跟着基模走,抛弃了“把LLM调成机器人”的方向。
而灵波的不同在于,不单只做力控,也不单做世界模型,而是更成体系,把种种的模态做成“具身原生”的一根根神经,交织成能跨硬件复用的物理大脑。
为具身智能行业修路搭桥
把视角拉回产业,LingBot-Touch只是一个切口。灵波大脑2.0的四层架构——空间感知、触觉感知、动态交互、灵巧操作,想解决的是一个更大的问题:机器人能不能拥有一套通用的智能底座,不必每换一种硬件、进入一个新场景,就从头训练一遍?
这件事如果能做成,对整个行业至少有三方面的影响。
首先,是让机器人硬件和智能算法不再深度绑定。
过去,一家机器人公司选定某款灵巧手、传感器和本体后,往往还要围绕这套硬件重新训练感知模型和动作模型。换一套硬件,很多算法也得跟着重做。
灵波想做的,是把视觉、深度、触觉等感知能力从具体硬件中抽离出来,形成可以独立调用的模块。这样一来,本体厂商可以把更多精力放在机械结构和运动控制上,传感器厂商也不必从零搭建算法体系。不同厂商各自做好擅长的部分,再通过统一的智能底座协同工作。
其次,是让机器人采集的数据能够持续积累,而不是跟着项目走。
过去,行业并不缺采集数据的公司,真正的问题在于,数据往往和特定硬件、特定任务绑定。一个项目结束,换一台机器人、换一个操作对象,之前的数据未必还能直接使用。
灵波的思路,是通过统一的表征方式,把不同设备、不同模态采集到的物理交互数据转化为可以复用的训练素材。这样,机器人在一个场景中学到的东西,才有机会迁移到另一台设备、另一种任务上。数据也不再是一次性消耗品,可以随着训练和应用不断积累。
第三,是让机器人的精细操作更容易走出实验室。
空间感知让机器人看清环境,触觉感知让它感知接触和受力,动态交互帮助它理解物体与环境的变化,灵巧操作则把这些信息转化为实际动作。几层能力协同起来,机器人才能从完成一段预设动作,进一步走向应对真实世界中各种不确定情况。
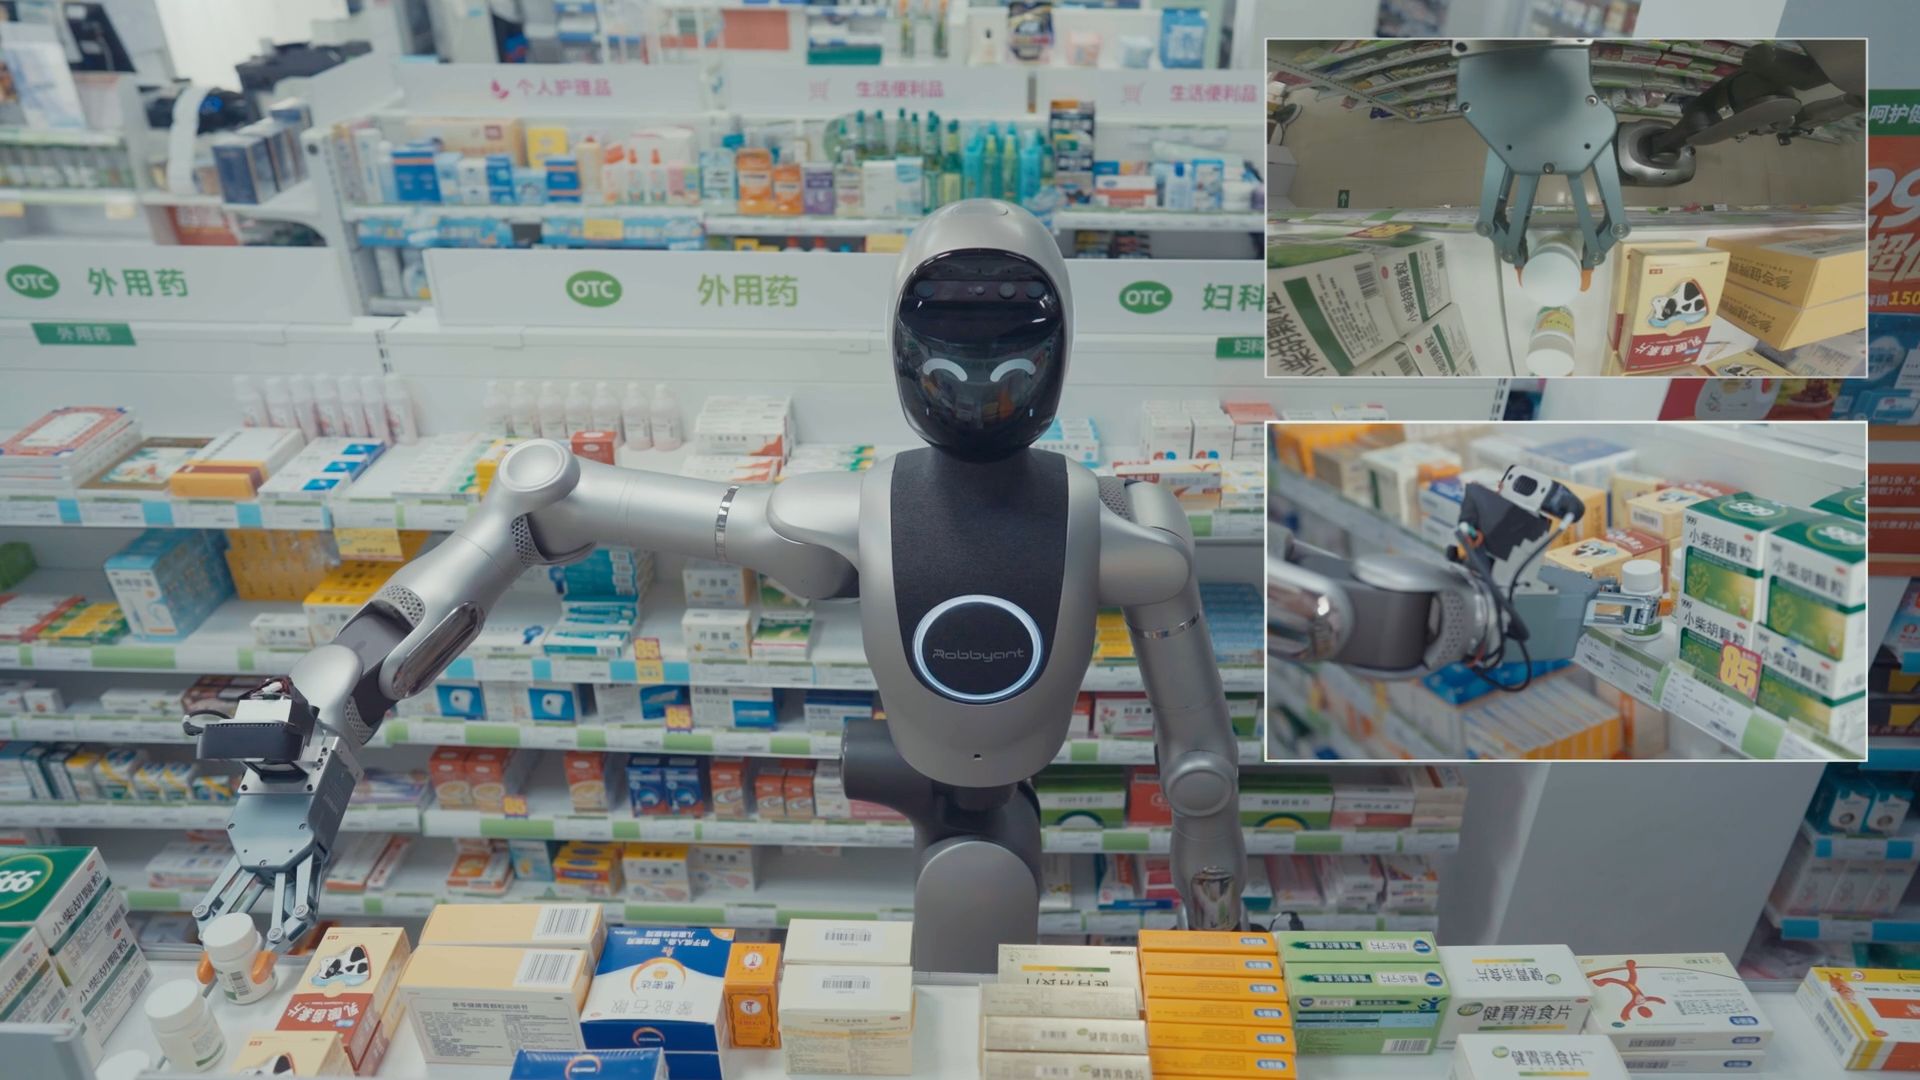
对于应用方来说,这意味着零售分拣、物流搬运、工业装配等场景,未来或许不必再依赖工程师针对每一个任务反复调试,而是可以在通用模型的基础上,经过少量适配就部署到新的场景中。
把这三件事放在一起看,灵波想做的其实不只是一套机器人模型,而是产业链中间的一层智能基础设施:向上承接任务和动作模型,向下适配不同的机器人本体与传感器,让视觉、触觉、力觉等能力能够协同工作。
目前,灵波也正在和乐聚、钛虎等本体厂商,以及国大药房、隆盛等场景方开展真实场景测试。这套架构能否真正跑通,最终还要看它能不能在不同硬件和任务之间实现稳定迁移。
沈宇军用了一个有意思的比喻:具身智能可以借鉴数字世界的“预训练—微调”模式,但不能简单照搬大模型的发展路径。
比如,特斯拉训练FSD,并不是从GPT中蒸馏出驾驶能力。汽车对碰撞、惯性、路况和其他车辆行为的理解,最终还是要来自真实驾驶数据的持续积累。
未来,机器人也是如此。通用大模型可以帮助它理解任务,但要知道“药片在指尖将要滑落时该如何调整力度”,仍然需要来自真实物理世界的训练。
当机器人从展示柜走进工厂和仓库,真正拉开差距的,可能不再是谁能做出更炫的Demo,而是谁能让智能在真实世界中不断积累,并且把已经学会的能力迁移到更多硬件和场景中。
这或许也是灵波“具身原生”策略真正值得期待的地方——它不只是让机器人变得更聪明,更试图为整个行业建立一套可以不断复用、持续进化的基础设施。
