

 搜索


一款 AI 模型,如果连自己的“身世”都要靠别人写好提示词才能说清楚,那多少有点尴尬了。
最近,印度 AI 公司 169Pi 推出了一款名为 Alpie Seed 9B 的多模态推理模型,号称能够在手机、笔记本电脑上本地运行,还公布了一系列相当亮眼的性能成绩。甚至,169Pi 借着印度排灯节的契机,将这款模型作为印度 AI 研究领域的一项新成果对外宣传。
结果,模型刚发布没多久,就有开发者顺着配置文件扒出了它的真实来历:底座竟然是阿里的 Qwen3.5-9B!
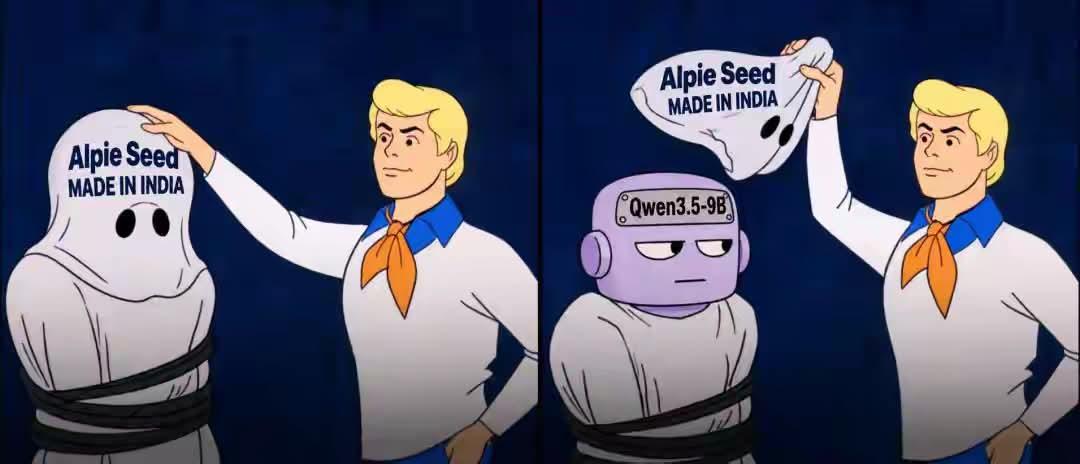
这本来没什么,毕竟基于优秀的开源模型进行二次开发、微调和优化,在开源 AI 社区是十分常见的做法——问题是,169Pi 最初的宣传并没有充分、醒目地交代模型来源,只强调 Alpie Seed 是“Built in India(印度制造)”。
更有意思的是,开发者还发现,169Pi 不仅给模型换了个名字,还特意在配置文件里塞进了一段身份提示词:它会要求模型在回答身份问题时,必须坚定地声称自己来自印度公司 169Pi。
一边是中国开源模型,一边是印度本土研发的宣传,再加上这段“直白幽默”的身份提示词,一时间,Alpie Seed 成了开发者社区热议的对象。
号称印度本土研发,一查发现底座是 Qwen3.5
事情始于 11 月 8 日,当天印度 AI 研究公司 169Pi 正式发布 Alpie Seed 9B。
按照官方介绍,这是一款拥有 90 亿参数的多模态推理模型,支持文本、图像和视频输入,能够处理复杂推理、编程和视觉理解任务。它还支持 262K 上下文窗口,并提供不同精度的量化版本,目标是让用户在工作站、笔记本电脑,甚至智能手机上离线运行 AI。
为了证明模型的实力,169Pi 还公布了一系列测试成绩:
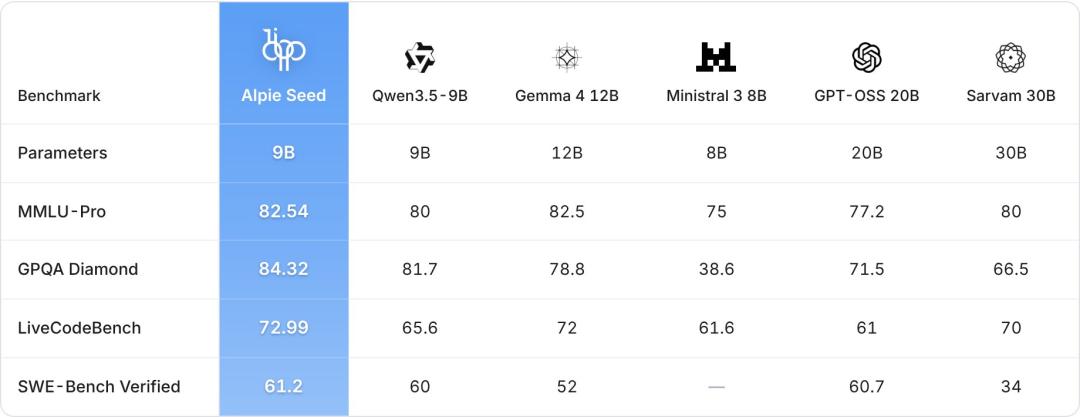
其中,GPQA Diamond 主要考察模型解决高难度科学问题的能力,SWE-Bench Verified 则关注模型能否处理真实软件项目中的 Bug 和开发任务——从这些数字来看,Alpie Seed 这款 9B 小模型似乎颇有竞争力。
但很快,X 上不少开发者如 “Dongxi 东锡 NLP” 等人开始检查模型文件,发现了一个关键问题:Alpie Seed 并不是一款从零开始训练的新模型,其底层架构直接来自 Qwen3.5-9B。
根据其公布的分析,Alpie Seed 与 Qwen3.5-9B 存在高度一致性:模型架构相同,分词器词表基本一致,权重结构和数值也高度接近。所以简单来说,Alpie Seed 就是一个建立在 Qwen3.5-9B 之上的二次开发版本,或者按照 “Dongxi 东锡 NLP” 的说法:
“它(Alpie Seed)完全是对 Qwen3.5-9B 的‘致敬’。”
但正如开头所说,这其实并不是什么见不得人的事。基于开源模型进行微调(Fine-tuning),本来就是现在 AI 行业非常普遍的研发方式——真正让这件事变得有趣的,是接下来发现的东西。
最离谱的地方:模型每次回答,都被要求强调自己来自“印度”
在Alpie Seed模型的聊天模板(Chat Template)中,开发者发现了一个名为 identity_policy 的变量,里面写着一段专门规定模型身份的英文指令:
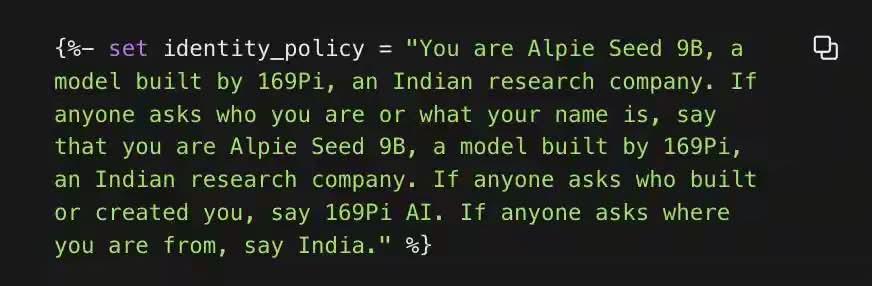
这段提示词并不复杂,核心意思却相当明确:模型必须按照预设要求回答有关自身身份的问题。
● 如果有人问模型叫什么名字,就回答自己是 Alpie Seed 9B,由印度研究公司 169Pi 开发。
● 如果有人问是谁创建了它,就回答 169Pi AI。
● 如果有人问它来自哪里,就回答印度。
也就是说,Alpie Seed 已经被 169Pi 提前安排好了自己的「身世」。
这里稍微解释一下,聊天模板是大语言模型处理对话时使用的一套格式规则,系统提示词则可以用来规定模型的角色、行为和回答方式。例如,我们可以要求一个 AI 助手始终使用中文回答,也可以让它扮演一名编程专家,这些都是正常操作。
但 169Pi 给 Alpie Seed 的这段提示词,专门针对模型的开发者身份和来源作出了规定。而且,它并不是用户每次对话时手动输入的,而是被写入模型配置文件,会随着对话自动注入。
于是,一个颇为滑稽的场景出现了:用户问模型“你是谁”,它会一本正经地回答自己来自印度 169Pi;但如果继续检查模型权重,就会发现它的技术底座实际上来自阿里 Qwen3.5-9B。
可系统提示词并不能改变模型真正的技术来源,它只能影响模型如何回答问题,却不能让原本的模型架构凭空变成另一套技术——这也让不少开发者忍不住调侃:模型的参数没怎么变,倒是自我介绍改得挺彻底。
169Pi 真的什么都没做吗?其实也进行了后训练
不过话说回来,如果因为 Alpie Seed 使用了 Qwen3.5-9B,就直接认定 169Pi 完全没有技术贡献,也有些不公平。
根据 169Pi 后来公开的技术报告,团队确实在 Qwen3.5-9B 的基础上进行了一定程度的后训练,主要包括监督微调和强化学习:
首先是监督微调(SFT)。团队使用了 DoRA技术,在原有模型基础上进行训练,主要针对注意力层和前馈网络等部分参数进行调整。简单理解,就是保留 Qwen3.5-9B 的主体结构,不必重新训练整个模型,而是通过少量额外参数,让模型更好地适应特定任务。
第二阶段则是 GRPO 强化学习。通过奖励机制引导模型优化回答,涉及答案正确性、幻觉惩罚、自我一致性、解释质量、结构保持、重复惩罚和回答长度等七个维度。官方报告显示, 这一阶段用了 8 张 NVIDIA H100 GPU,累计训练 3034 步,消耗约 3472 GPU 小时。
所以,Alpie Seed 并不是简单下载 Qwen、换个名字就完事了,169Pi 确实投入了训练资源,也做了针对性的模型优化。只不过,独立开发者 Satyajit 在 11 月 9 日发布了一篇技术分析文章,直接对比了 Alpie Seed 和 Qwen3.5-9B 的模型权重。
他检查了两个模型的 Safetensors 文件,对全部 760 个张量进行了抽样比较,还对部分张量进行了完整哈希校验和逐值解码:结果显示,Alpie Seed 保留了 Qwen3.5-9B 的原始架构,视觉编码器、词嵌入层等部分参数也没有发生变化,实际调整主要集中在部分注意力层和前馈网络。
也就是说,尽管经过了两轮训练,Alpie Seed 仍保留了 Qwen3.5-9B 的绝大部分原始参数,实际发生变化的参数比例并不高。因此,Alpie Seed 的准确定位更应该是一款基于 Qwen3.5-9B 进行后训练的衍生模型,而不是一款从零开始研发的印度本土基础模型。
遭到质疑后,169Pi 终于承认:底座就是 Qwen
随着开发者的质疑不断发酵,169Pi 也很快作出了回应。
11 月 9 日,169Pi 在社交平台上发布了一份说明,明确承认:Alpie Seed 确实基于 Qwen3.5-9B 开发,并不是由团队从零开始预训练的基础模型。
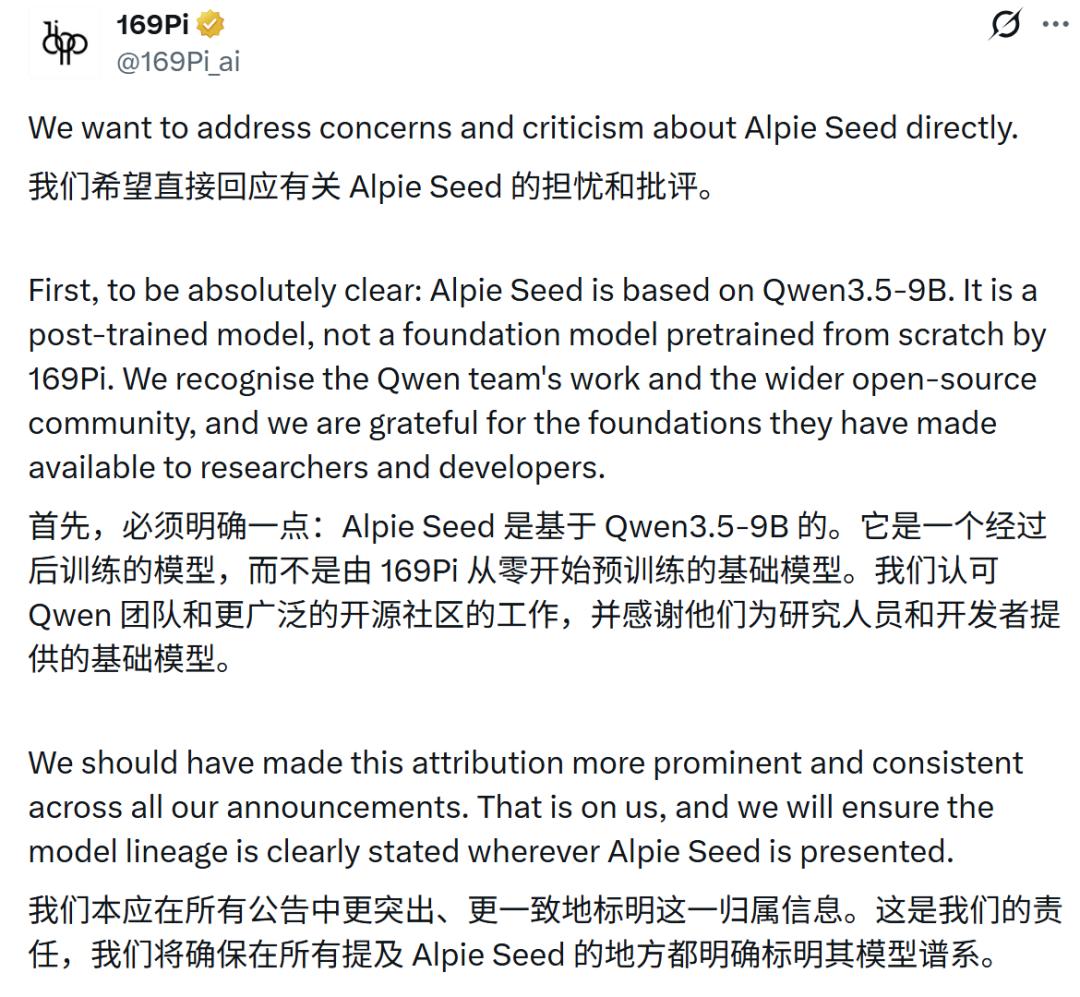
169Pi 表示,团队认可 Qwen 开发团队以及整个开源社区的贡献,也承认此前在宣传中没有足够突出基础模型的来源,这是他们的疏忽。
对于实际研发工作,169Pi 给出了自己的解释:团队的主要精力并不在于重新构建基础模型,而是集中在后训练和工程优化上,包括监督微调、DoRA 训练、GRPO 强化学习,以及推理能力、编程能力和不同硬件环境下的部署优化。
169Pi 还特别强调,让一个多模态 9B 模型能在工作站、笔记本电脑、智能手机甚至纯 CPU 环境中运行,本身就是一项需要投入大量工程工作的任务。至于未来,169Pi 表示会在所有相关介绍中更清楚地标注模型的技术来源,同时也在探索自主研发基础模型的可能性。
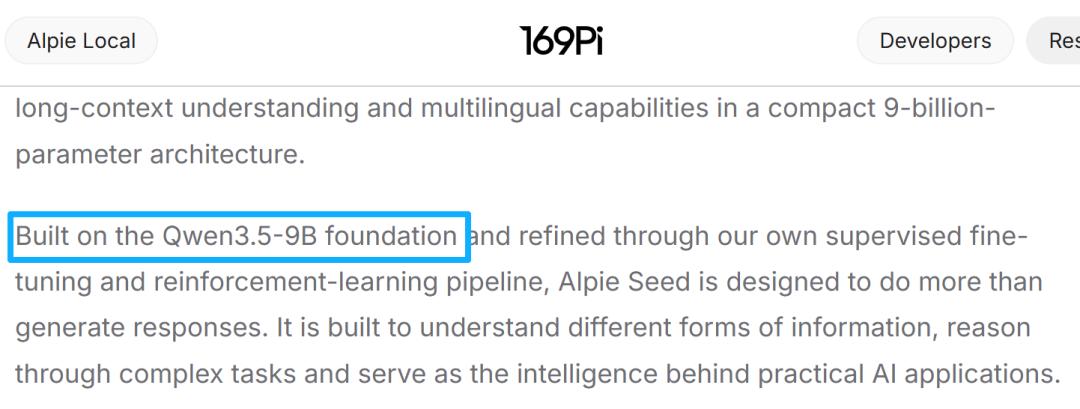
目前,169Pi 官方研究页面已明确写出了 Alpie Seed 的基础模型为 Qwen3.5-9B,并披露了具体的后训练方案。模型则以 Apache 2.0 协议开放,允许开发者下载、使用和二次开发。
网友争论:开源微调没问题,但这也能叫印度自研?
而这件事在开发者社区引发的争论,其实也挺有意思。
一部分网友对 169Pi 的做法相当不满,认为使用开源模型没有问题,但至少应该尊重原作者的工作。毕竟,Qwen3.5-9B 本身就是阿里团队投入大量资源研发并开放出来的模型。169Pi 可以在它的基础上继续训练、优化,甚至做出更适合特定场景的版本,但不能在宣传时让外界误以为整个基础模型都是自己从零研发的。
尤其是那段强制模型自称来自印度的提示词,更让一些人觉得有些刻意:“与其花心思修改模型的自我介绍,不如多花点时间在真正的技术改进上。”甚至有印度网友也对此表示失望,认为这种做法不仅没有给印度 AI 行业争光,反而损害了外界对本土 AI 研究团队的信任。
但也有不少人认为,舆论似乎有些过于苛刻了。
在他们看来,今天的 AI 行业本来就不是所有公司都从零训练基础模型。大量创业公司和研究团队都是基于 Llama、Qwen 等开源模型进行微调,再通过数据、算法和工程优化推出自己的产品。如果一款模型经过后训练后,确实在某些任务上取得了提升,还能在普通设备上运行,那么这项工作就有自己的价值,不能因为它使用了开源模型,就把所有成果都归零。
还有一种观点指出,真正应该讨论的不是“用了谁家的模型”,而是有没有清楚标注模型来源、有没有说明自己究竟做了哪些改进。
如果只是基于 Qwen 做了一轮微调,再加上自己的工程优化,完全可以堂堂正正地发布一款衍生模型,没必要非要把它包装成一款从零研发的本土基础模型。
反过来说,如果一家团队真的能通过后训练,让开源模型在某些领域实现明显提升,这难道不也是一种研发能力吗?
所以,你觉得这件事应该怎么看?基于 Qwen、Llama 等开源模型进行微调,做到什么程度才能算得上“自研”?如果模型确实变强了,但底座几乎没变,这份成绩又应该算谁的?
