

 搜索


两年前,和大学下铺的同窗聊起GPU、半导体的先进制程,谈到摩尔定律已经逼近物理极限,除了硅,是否还有更好的材料。同学当年毕业后去Berkeley(加州大学伯克利分校)研究固体物理,他还真的特意问过导师这个问题。导师的回答是:综合考虑物理性能、资源可获取和成本等因素,一时没能找到比硅更合适的材料。
两年过去,AI又把力不从心的硅再向极限狠狠地push了一把。既然暂时找不到硅的替代,人们就开始想办法在硅的基础上补短板,用光替代电实现数据搬运,继续在硅上系统化地榨取计算性能。人类虽不像AI一样常给人surprise,但善于迭代。
半导体材料的事,留给物理学家。AI不会让科学家没活儿干。
用光解决数据搬运瓶颈
当数万乃至数十万颗GPU协同工作时,算力瓶颈已不只是芯片的计算能力,还包括GPU之间,以及计算与存储系统之间的数据传输效率和功耗。
电的优势在小尺度内,光的优势在小尺度之外。光凭借高带宽、低传输损耗,以及在特定距离和带宽条件下的能效优势,正在深入AI计算系统。
AI计算的下一场硬仗,不只是让GPU算得更快,还要让数据跑得更快、耗电更少。
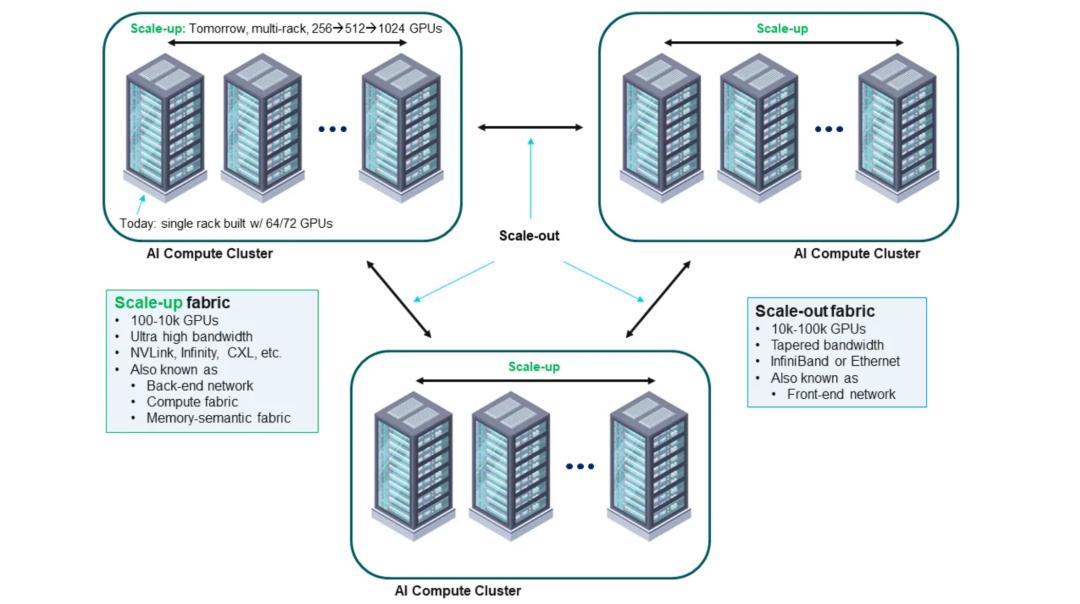
Scale-up和Scale-out路径示意图,图片来源:Ayar Labs
Scale-up通过高带宽、低延迟互连扩大紧密协同的计算域;Scale-out则通过网络连接更多计算节点,扩展集群规模。光技术正在同时进入这两个市场。
从Lightmatter到Celestial再到Salience Labs:光互连与光交换开始上演大戏
上面说的两个路径,已经有十多家创业公司分别取得了进展。Lightmatter、Celestial AI和Salience Labs是三家有代表性的公司。
Lightmatter源自MIT,以光计算起家,后来将重心转向光互连。公司累计融资超过8亿美元,2024年估值达到44亿美元。
Celestial AI以Photonic Fabric(光互连网络)切入芯片间及计算与内存之间的数据传输,累计融资近6亿美元,2026年2月被Marvell收购。
Lightmatter和Celestial AI主要通过光互连提高芯片间的数据传输带宽和能效,重点瞄准Scale-up市场。
源自牛津大学的Salience Labs则聚焦OCS(Optical Circuit Switching,光电路交换),通过直接改变光路连接,减少不必要的光电转换。其技术用于Scale-out网络,也有向Scale-up延伸的潜力。
在这个领域,Google已经先行一步,在TPU集群中规模应用MEMS光交换,证明了OCS在大型AI计算系统中的实际产业价值。但Google也是模型的参与者,产业需要一个Google之外独立的玩家,这就给其它公司留出了机会。
过去几年,硅谷已经涌现出10多家快速成长的公司。中国的曦智科技也已经走出一步,并在港交所上市。
这些公司普遍在6-8年前成立,很多来自大学的实验室,技术从小到大靠工业界,从无到有还是少不了研究机构。这一轮与其说是产业推动了技术进步,不如说基础研究遇到了产业场景,应用快速起飞。
产业巨头在该领域的参与,印证了这个产业的前景。 Salience 获得了 AMD 和 Intel CEO 陈立武主导的基金的投资,NVIDIA 更是连续投资了Coherent、Lumentum、iPronics、 Ayar Labs 等公司。
Scale-out:光互连率先兑现商业价值的市场
Scale-out是将大量计算节点连接起来,形成更大的计算集群。随着集群规模扩大,传统电互连在传输距离、带宽密度和功耗方面越来越吃力,光互连自然成为重要选择。
800G光模块已规模商用,1.6T正进入商业化放量阶段。中际旭创、Coherent、Lumentum等中外公司已经形成初步规模,潜力巨大。
Scale-out通过光模块和光纤互连,沿着现有产业链逐步升级,率先解决了数据传输瓶颈。OCS有望进一步提高网络效率,同时避开Scale-up在芯片级光电集成方面的部分挑战。
因此,Scale-out率先成了光互连兑现商业价值的市场,光电结合、要求更高的Scale-up则是下一阶段更具挑战性、也更具战略价值的主战场,留在后面讨论。
MEMS与SiPh:光交换的两条技术路线
在Scale-out网络中,光模块和光纤互连已经广泛应用,而OCS正在成为值得关注的新方向。目前OCS主要存在传统MEMS和集成硅光等技术路径。
传统MEMS利用微型机械结构改变光路,技术成熟、损耗低,适合大规模光交换。Google从TPU v4开始,就将MEMS OCS用于TPU超级计算集群内部的互连。
固态硅光交换基于SiPh(Silicon Photonics,硅光子技术),利用热光、电光等效应在芯片上改变光路,具有体积小、集成度高、切换速度快的潜力。一旦克服损耗、串扰和制造复杂度等挑战,将展现出巨大潜力。
MEMS依靠今天的工业成熟度赢得先机,SiPh在高速、高密度集成方面潜力更大,国内这两方面都已经有创业公司在探索。
NOEMS:MEMS向高速高集成延伸
NOEMS(纳米光机电系统)将微纳机械结构与集成光学结合,试图同时获得传统MEMS的低损耗优势与硅光芯片的高集成度,并改善传统机械光交换的速度限制。
部分NOEMS研究已在器件级展示微秒级甚至更快的切换能力。
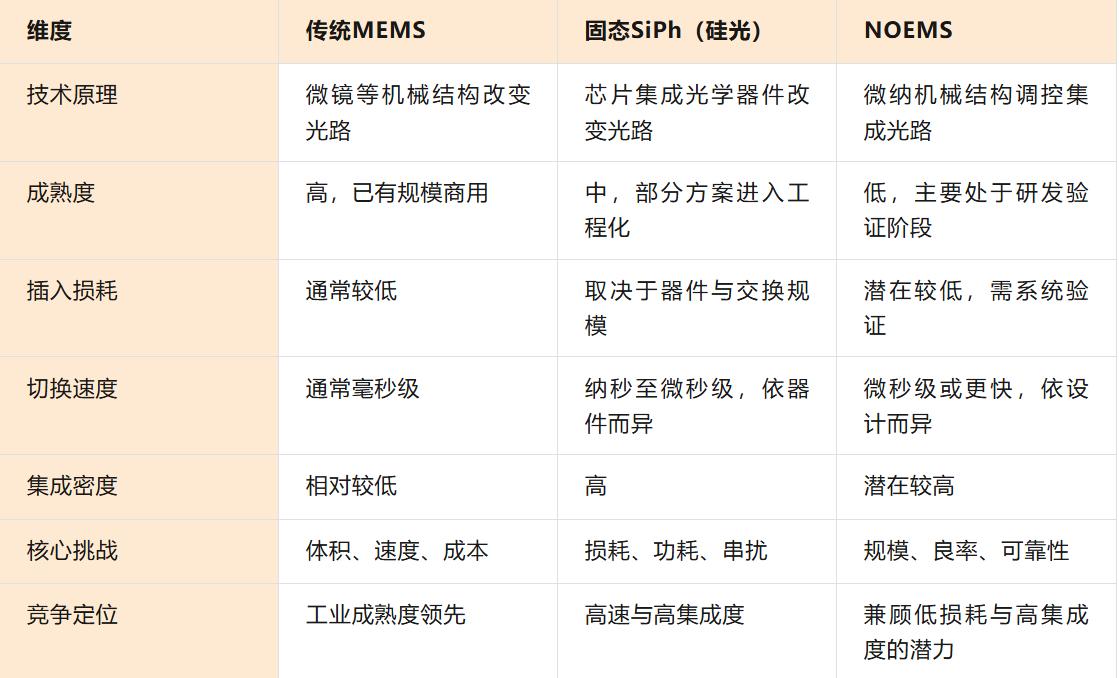
三条光交换技术路线对照
传统MEMS强在成熟,SiPh强在集成,NOEMS试图兼得两者优势,技术原理已获得突破,虽仍待大规模验证,但机理巧妙,前景可期。
Scale-up:长期战略硬道理
Scale-up通过超高带宽、低延迟互连,让大量GPU像一台计算机一样协同工作。NVIDIA新近推出的Vera Rubin在这方面做足了功夫。
目前主流的Scale-up仍依赖铜互连和电子交换。随着GPU从数十颗扩展至数百、数千颗,高速电信号的传输损耗、SerDes功耗、布线密度和交换芯片I/O带宽将成为越来越突出的瓶颈。
CPO(共封装光学)是突破高速电互连限制的重要技术路径。通过将光引擎靠近GPU或交换芯片,缩短高速电通道,以光纤实现更远距离、更高带宽密度的连接。但GPU级CPO仍面临激光光源的效率与寿命、光纤耦合、散热与封装良率等挑战。
谁能率先实现高带宽、低功耗、高可靠且可规模制造的GPU光互连,谁就有机会掌握下一代AI计算系统的关键技术入口。
赢在网络计算的最小单元,这是Scale-up长期战略价值所在。
结语
从电到光,不只是计算和通信技术的升级,更是AI推动的计算架构重构。
令人欣喜的是,这几年做天使投资过程中,结识的国际一线年轻研究人员,比以往多年加起来还多。他们兼备国内外求学和科研经历,研究和产业视野开阔。虽比那些耳熟能详的大家差了些年资,但敢做产业敢闯是他们的优势,跃跃欲试,令人鼓舞。
本文作者:阿尔法公社创始合伙人 许四清。
