

 搜索


过去一周之内,连着两台新手机产品刷屏,一台是 Apple 新出的 iPhone 18,一台则是
AI 开始看见屏幕,也开始伸手触碰屏幕。与此同时,《华尔街日报》透露,OpenAI 已经以超过 3 亿美元收购相机技术公司 Glass Imaging。
交易尚未得到 OpenAI 公开确认,但这块新拼图出现的位置十分微妙:去年,OpenAI 花 65 亿美元收购了 Jony Ive 创办的硬件公司 io 后,还没有做出大名堂,工业设计师和相机工程师就已经先后到位。
是 AI ,但不是修图 AI
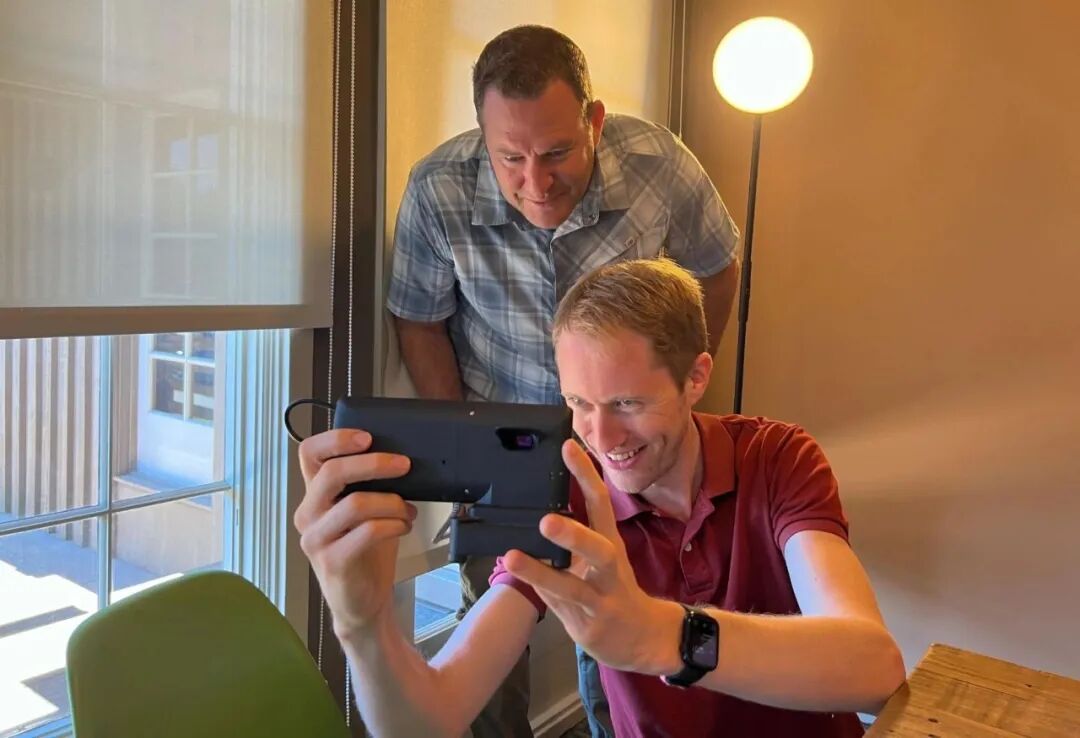
Glass Imaging 由 Ziv Attar 和 Tom Bishop 创办,两人此前都曾在苹果从事计算摄影工作,并参与过 iPhone 人像模式的开发。
不过,Glass Imaging 研究的不是今天最常见的 AI 修图,是用 AI 反过来影响相机硬件的设计逻辑。
手机按下快门后,传感器最先得到的并不是一张可以直接观看的照片,而是一堆原始光信号。传统的图像信号处理器需要完成降噪、校色、锐化等工序,才会在屏幕上生成最终图像。
Glass Imaging 试图用一套针对具体镜头和传感器训练的神经网络接管这条流水线。它的技术底层还是 Neural ISP,传统 ISP 会把 RAW 数据依次交给去马赛克、降噪、多帧融合、锐化等模块,每一步由独立算法处理,也会在过程中丢掉一部分信息。
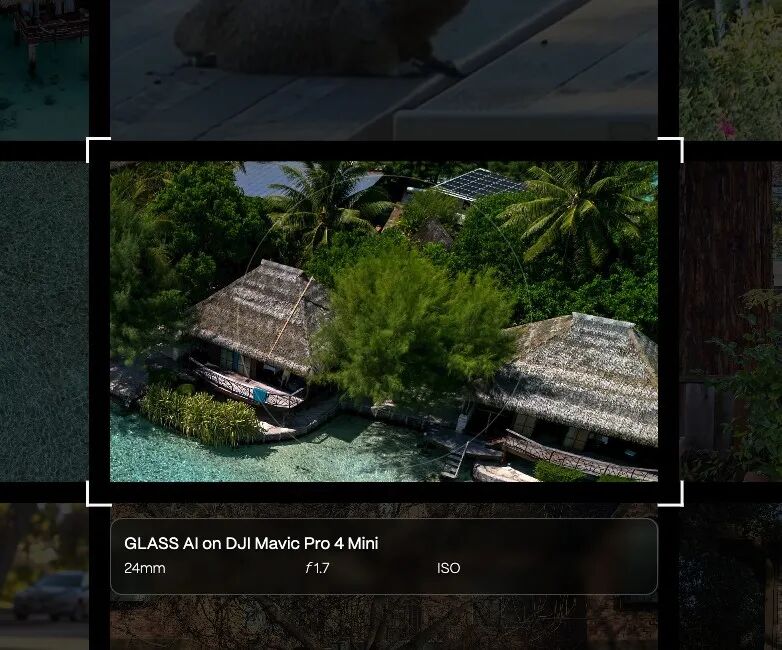
GlassAI 则从传感器的 RAW 连拍数据出发,把去马赛克、降噪、去模糊、多帧融合放进同一个联合训练的网络,同时加入传统 ISP 不擅长的镜头像差反卷积和传感器串扰校正,最后直接输出成品 RGB 图像。
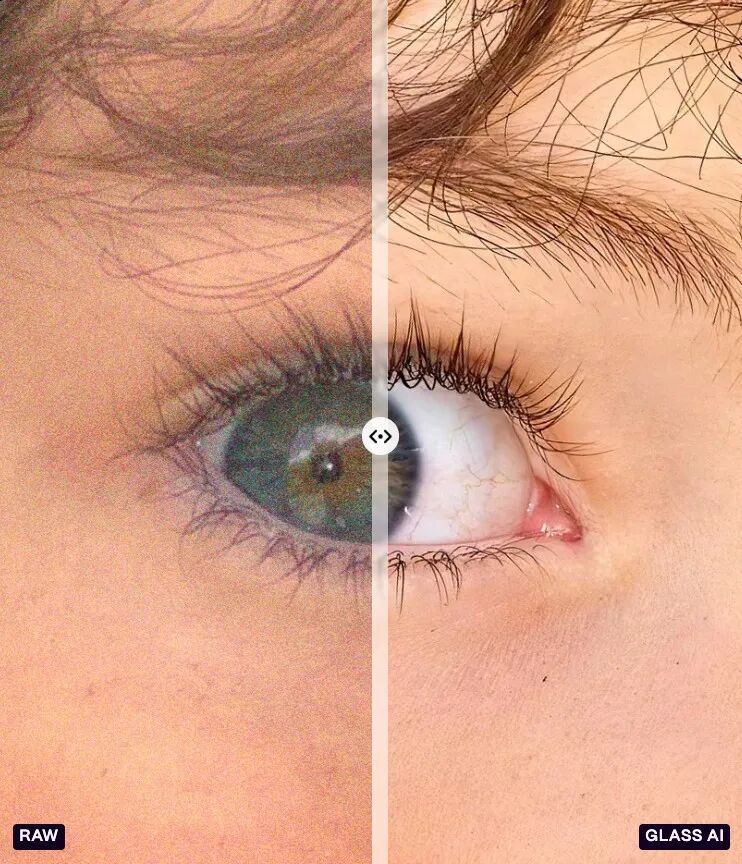
以Neural ISP为基础,Glass Imaging 吸收并重写了传统ISP的大量核心环节。它需要学的是,一台相机如何产生误差,再在图像形成时把误差倒推回去。Glass Imaging 的思路是,镜头只要把足够的信息送到传感器,剩余的模糊、色差和畸变可以交给专门训练的网络修复。
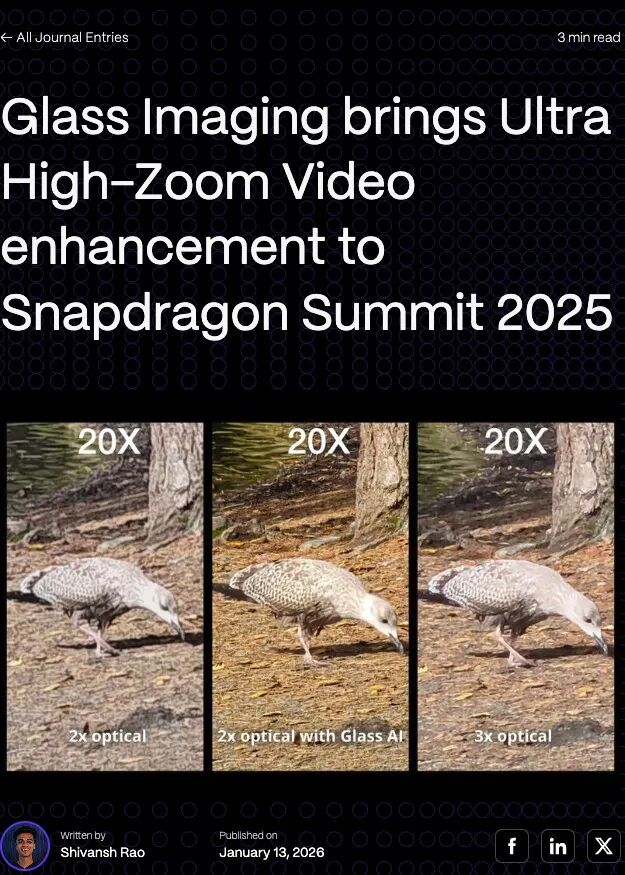
但这里所谓的「修复」并不是指 AI 修图那种意义上的「修」,生成式修图,的确可以把远处模糊的文字、月亮和人脸「猜」得更加清晰,但清晰不等于真实。Glass Imaging 的资料称,其网络针对具体光学系统和 RAW 数据训练,目标是恢复传感器实际捕捉到的信息,而不是凭常识和推论生成新的纹理。
相比于 AI 目前在图像处理中的主要作用,这很不一样,原因在于:如果摄像头只是为了拍朋友圈,照片好看即可;可如果图像要交给 Agent 判断现实并采取行动,那么凭空补出来的物体和文字就可能导致错误操作——这才能理解 OpenAI 为何会对它感兴趣。
AI 设备的两种「观看权」
对手机厂商来说,Neural ISP 技术可以让更小的镜头拍出更清晰的照片;但对一家正在制造 AI 硬件的公司来说,它还有另一层意义:模型看到的世界,首先取决于摄像头交给它什么。
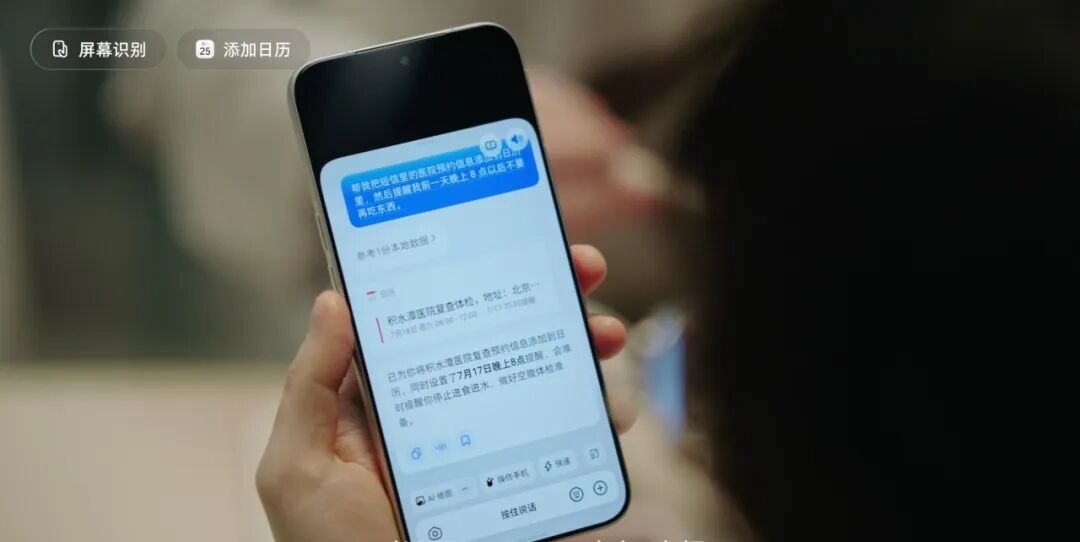
AI 设备需要两种「观看」能力。第一种发生在屏幕以内,AI 要看懂用户正在浏览什么,读取哪些本地信息,还要获得调用不同 App 的权限。在这个基础之上,理解整个操作系统里的上下文。
第二种发生在屏幕以外:菜单上的文字、桌上的物品、眼前的道路和房间里的设备,无法只靠聊天记录就让 AI「知道」,需要先拍下一张照片,再把照片交给 AI。
照片是人观看的终点,却可能只是 Agent 工作的起点。未来的 AI 设备若要及时行动,就必须缩短「人看见、拍摄、上传、询问」这一整条链路。
摄像头的身份也因此发生了变化,过去它替人保存值得回看的画面,在未来,将变为向机器提供判断下一步行动的依据。
GlassAI 的变焦技术已经进入荣耀 600 系列,说明它至少完成了从模型、手机芯片到量产设备的适配;公司还曾在骁龙 8 Elite Gen 5 参考设备上展示实时 4K 视频处理和 20 倍以上变焦增强。
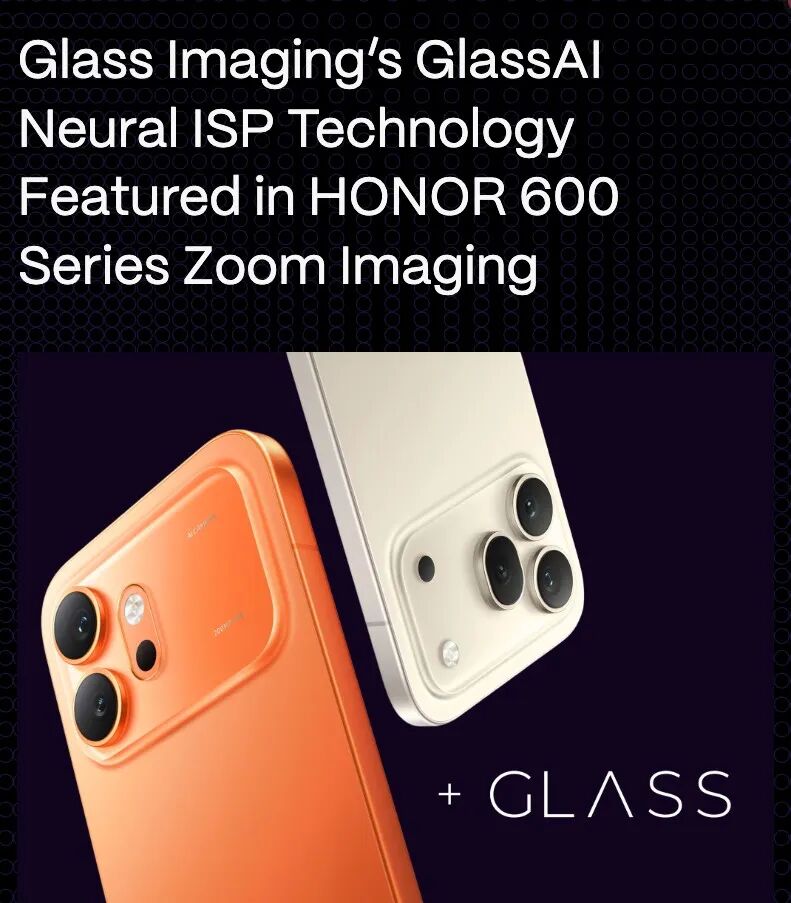
这些能力目前是被用来让人把远处拍得更清楚,在未来,当摄像头连接的不是相册,而是一个准备采取行动的 Agent,成像的评价标准就会发生变化。
照片不只要看起来漂亮,还要尽可能真实、稳定、及时地呈现文字、物体和空间关系,因为模型接下来可能据此识别商品、操作设备,甚至规划行动。
倒不是说,GlassAI 会让相机自动变成智能体,却补上了智能体进入现实之前最底层的一环:尽量把传感器实际看到的信息,准确地交给模型。
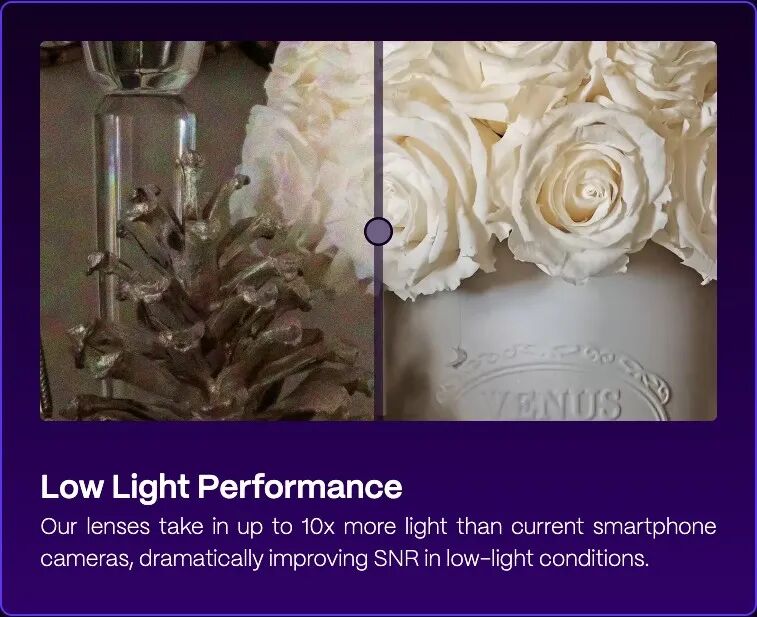
Glass Imaging 揭示的第一种变化,是硬件与软件之间的分工被重新划定。过去,相机厂商先尽量用镜头和传感器解决像差、模糊与噪声,再让 ISP 修饰最终图像;GlassAI 则允许硬件保留一些能够被计算逆转的缺陷,只要传感器还捕捉到了足够的信息,专门训练的网络便可以在成像过程中将其恢复。镜头因此可以更小,像素可以继续缩小,一部分原本需要增加镜片、厚度和成本才能解决的问题,被转移给了神经网络。
那么就有可能,未来 AI 设备的硬件,不必得被完整设计出来之后,再往里面「塞一个模型」。镜头、传感器、NPU、内存和模型会从一开始共同设计,传感器负责保留哪些原始信号、神经网络能够修复哪些误差、设备需要多大的本地算力、能否在低功耗状态下持续理解环境……这些问题都将反过来影响硬件的形状。
比如说,假设工程师提前知道,某些光学缺陷能够被神经网络稳定修复,下一代相机在选择镜头数量、像素尺寸、传感器和机身厚度时,就可以包容过去无法接受的缺陷。可能是不再通过堆叠更多镜片彻底消除像差,也可能是确保传感器仍然保留足够的原始信息,再交给 AI 恢复。
同样的逻辑也可能延伸到麦克风、空间传感器和其他感知部件。过去,硬件负责把世界尽量完整地记录下来,软件只在事后处理;未来,硬件只需要捕捉模型能够理解和还原的信息,模型则从一开始参与影响硬件应该怎样观看世界。
模型不负责决定摄像头看什么,却会改变相机必须用多少硬件,才能得到一幅足以被还原和理解的图像。
